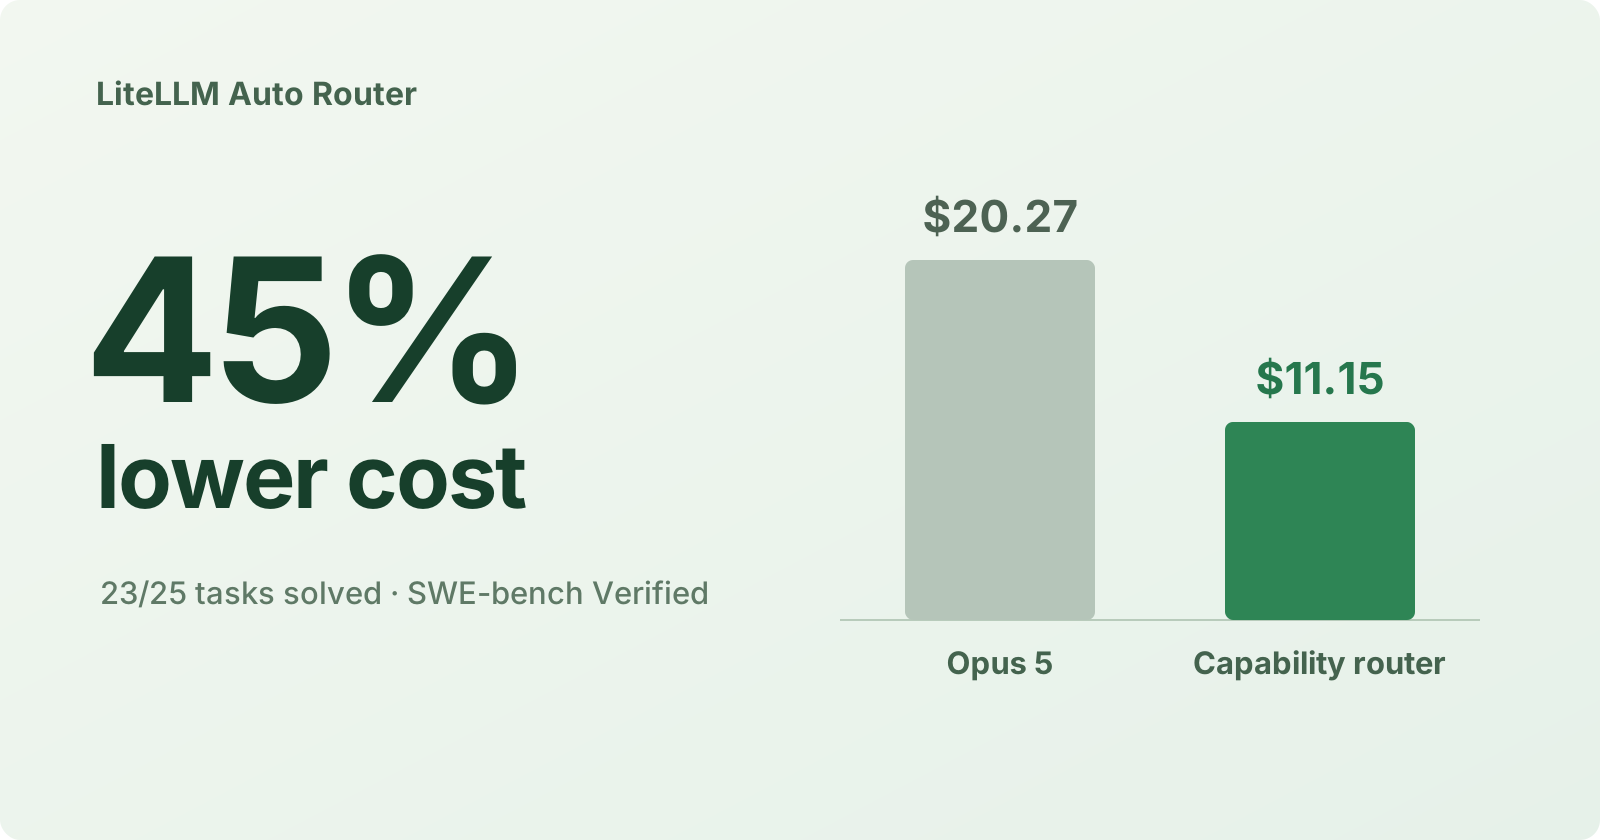

我們使用 LiteLLM 的實驗性能力路由器,以 $11.15 解決了 25 個 SWE-bench Verified 任務中的 23 個。若所有 solver 請求都使用 Opus 5,我們以 $20.27 解決了 23 個任務。包含分類器請求在內,兩次執行皆啟用提示快取,我們總共少花了 45%。
結果
我們在相同的 25 個任務上比較四種配置。我們以解決率衡量品質,並將未成功嘗試與分類器請求納入總成本。
| 配置 | 已解決任務 | 解決率 | 總成本 | 每個已解決任務成本 |
|---|---|---|---|---|
| LiteLLM 能力路由器 | 23/25 | 92% | $11.15 | $0.48 |
| Opus 5 | 23/25 | 92% | $20.27 | $0.88 |
| Sonnet 5 | 22/25 | 88% | $13.19 | $0.60 |
| NeMo Switchyard | 21/25 | 84% | $17.03 | $0.81 |
每個已解決任務成本 = 總執行成本 ÷ 已解決任務數。
- 在相同解決數下,成本比 Opus 5 低 45%。 兩次執行都解決了 23/25 個任務,使用能力路由花費 $11.15,而 Opus 5 為 $20.27。
- 比 Sonnet 5 多解決 1 個任務,且少花 $2.04。 使用能力路由解決了 23/25 個任務,而 Sonnet 5 為 22/25。
- 比 NeMo Switchyard 多解決 2 個任務,且少花 $5.88。 使用 LiteLLM 能力路由達到 92% 的解決率,而 Switchyard 為 84%。
Sonnet 與 Opus 之間的路由
我們會在選擇模型之前先對任務進行分類。我們將開頭指令、任何最新的使用者後續回覆,以及能力檢查清單送給 GPT-5.4-mini。我們請它找出最困難的需求,並使用清楚的需求、可用輸入與可執行檢查等訊號,估計 Sonnet 5 完成整個任務的機率。
我們將該機率與任務能力類別的閾值進行比較,對於不確定或不受支援的任務要求更高的機率。當估計值達到閾值時,我們選擇 Sonnet 5;若低於閾值,則選擇 Opus 5。
在這次執行中,我們將 98.4% 的 solver 請求送往 Sonnet 5,1.6% 送往 Opus 5。
基準測試設定
我們對每個配置都使用相同的 Harbor 與 mini-swe-agent 設定:相同的 25 個 SWE-bench Verified 任務、每個任務一次嘗試、三個並行任務,以及相同的驗證器。我們在每次執行中都啟用了提示快取,並從 LiteLLM gateway 支出記錄中量測總成本,包含分類器與 judge 請求。
結果範圍
我們在這個子集中達成了與 Opus 相同的解決數,但成功與失敗的任務不同:兩次執行都解決了 21 個任務,另外各自還有兩個不同的任務。在 25 個任務且每種配置只嘗試一次的情況下,我們無法建立跨工作負載的相同品質,也無法預測您的代理程式可節省多少。
若要比較您的工作負載,請使用相同的任務與驗證器,在各配置間啟用提示快取,並將分類器支出納入總成本。
如需相關實驗,請閱讀 Prompt Caching Works with Auto Router 與 Subtask-Specific Routing: Same Quality, 46% Less Cost。
實驗性分類器
能力預測是 Auto Router 的實驗性方法。它會根據需求、可用資訊與驗證工具,估計較便宜的模型是否能完成任務。我們正在評估這個構想,以及它如何與複雜度評估搭配運作
與 LiteLLM 團隊合作,在您的正式流量上評估 Auto Router。
申請成為設計夥伴