v1.97 對 auto router 做了三項變更。
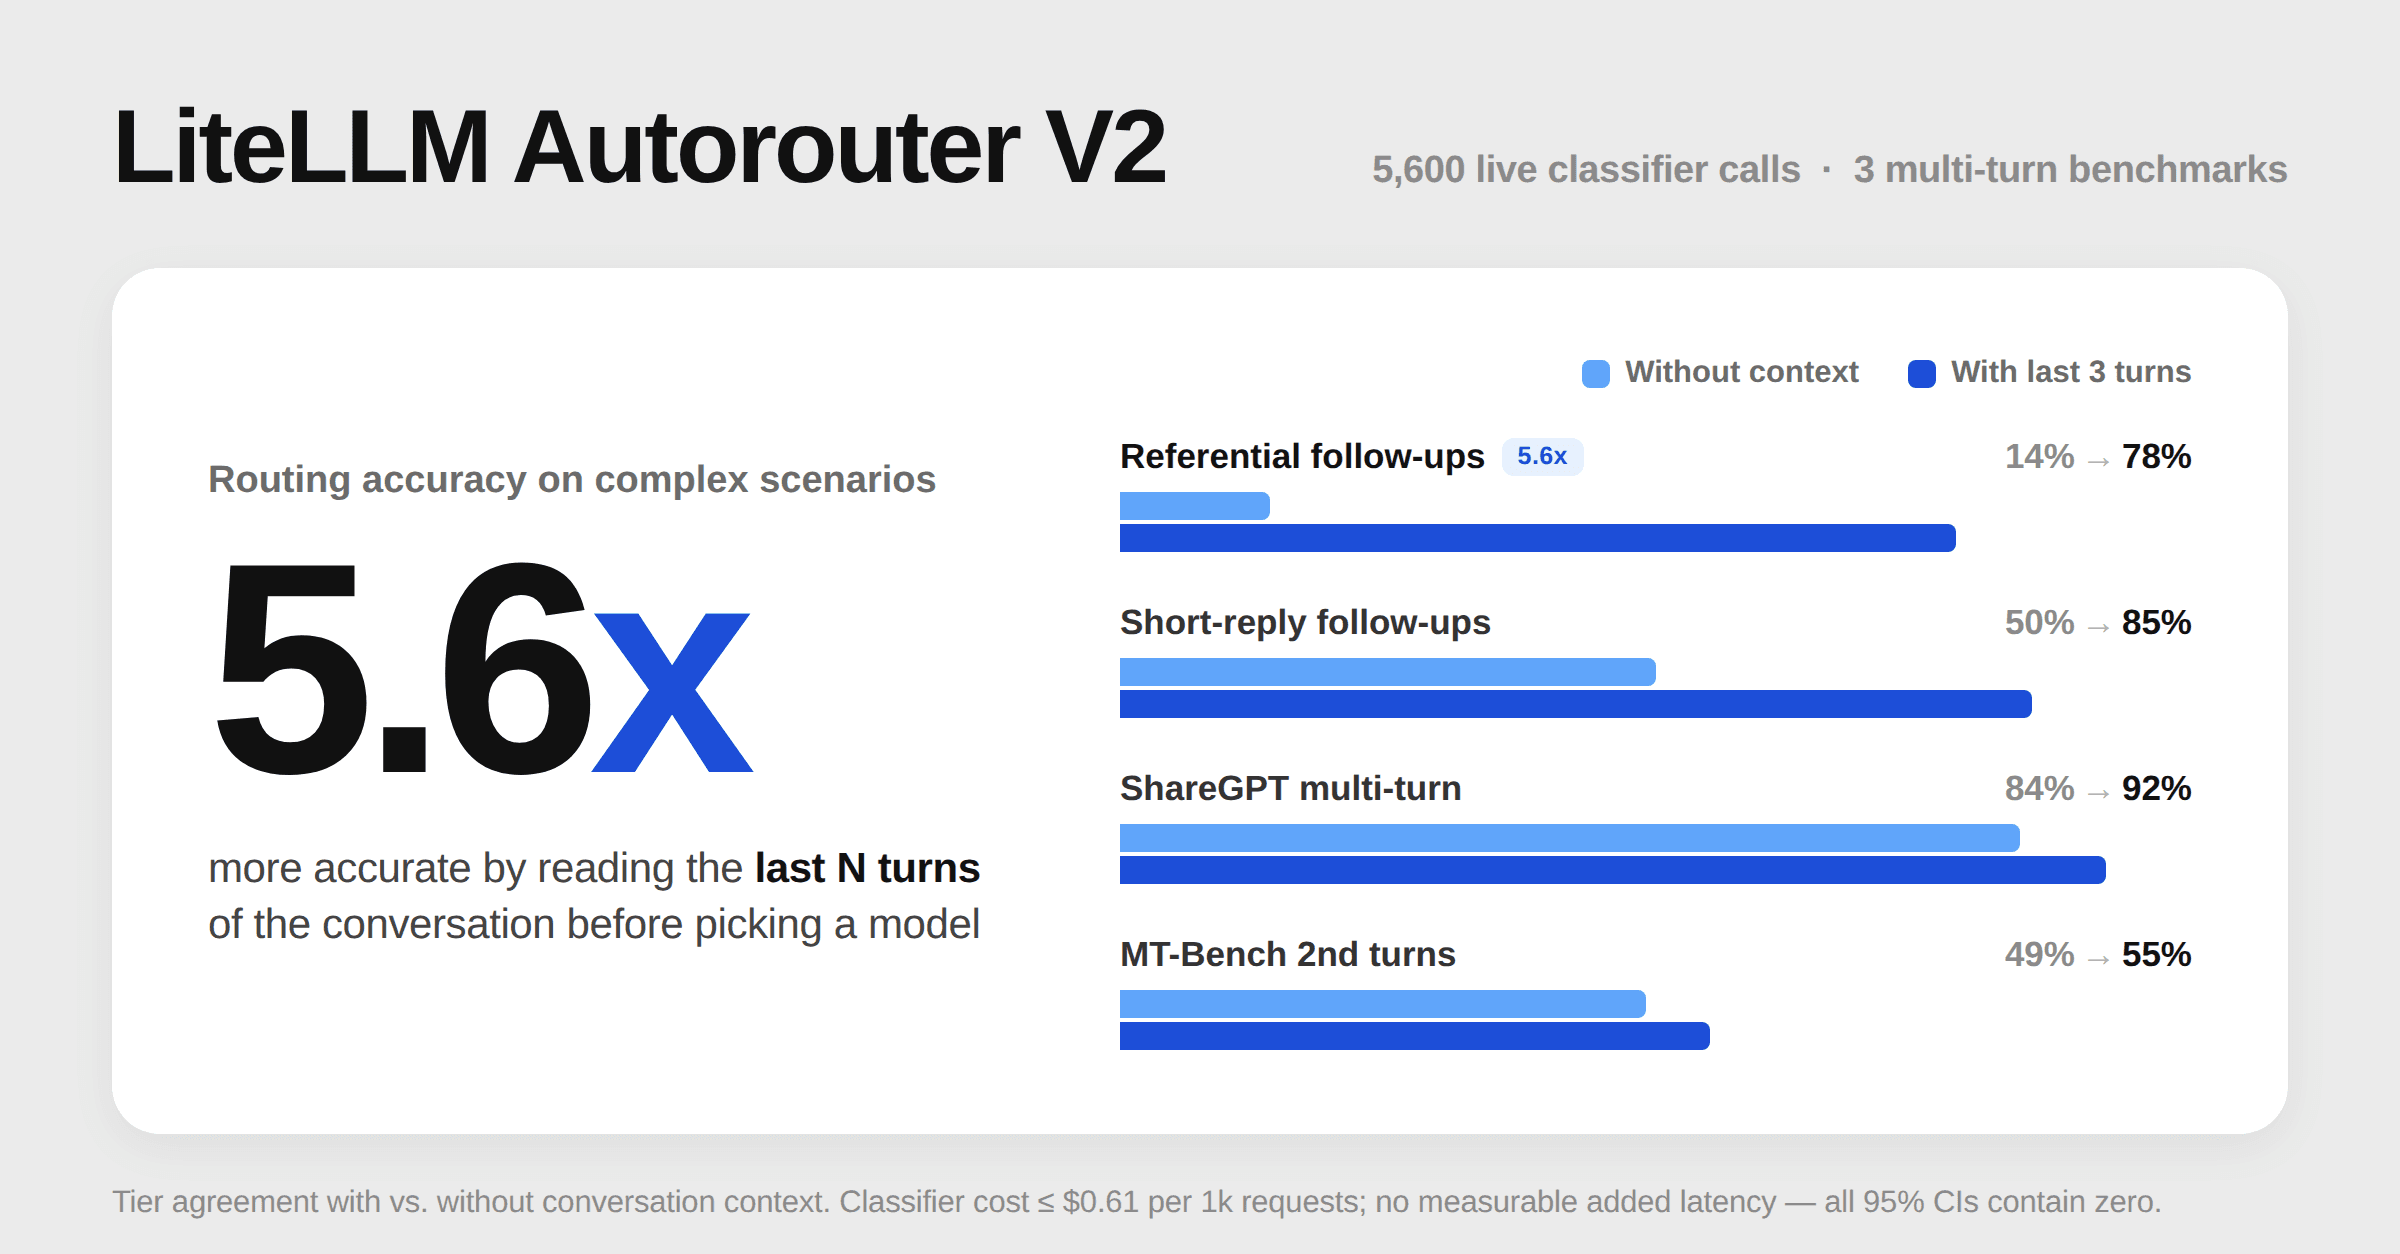
- LLM 分類器現在會接收一段先前對話輪次,預設為三輪。這將追問分類的準確率從 14% 提升到 78%,成本最高為每 1,000 次請求 $0.61,且不增加額外延遲。
- 新的 Benchmarks 檢視會以 all-frontier 基準為您的路由流量定價並回報差異,這些節省現在也會出現在 Cost Optimization 總計中。
- session affinity 現在預設為關閉,這符合我們先前的文章所示:這會導致品質變差,且沒有成本改善。
classifier_context_window_size 現在預設為 3(僅 LLM 分類器),而 session_affinity 現在預設為 false(所有 routers)。設定檔不會被修改,但新預設值會套用到任何尚未設定的鍵,因此從未提及 session_affinity 的設定,在升級後會重新分類每一輪。明確設定任一鍵值的設定不受影響。
成本與使用量基準測試
Benchmarks 檢視會顯示您使用 router 相較於固定模型(例如 Opus)的實際用量所節省的成本。
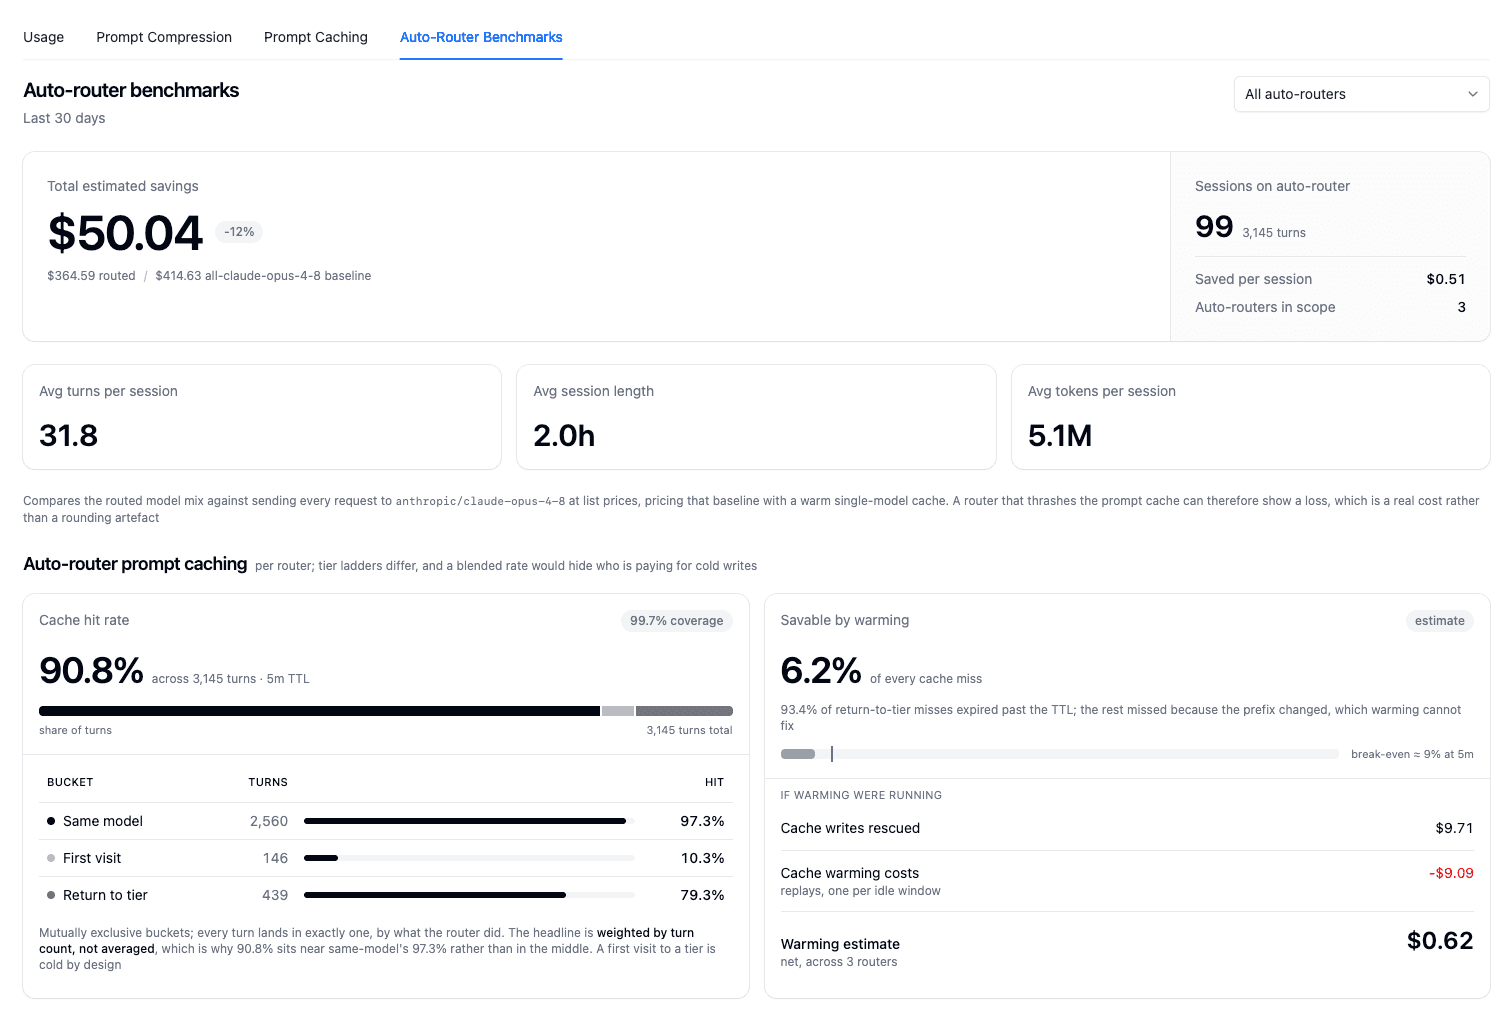
針對每個 router 與每個時間範圍,它會以清單價格將路由流量與送往單一 frontier 模型的相同流量進行定價,並回報美元與百分比差異,同時列出:router 上的 sessions、每個 session 的 turns、每個 session 的 tokens,以及每個 session 的節省。基準值是以已預熱的單一模型 cache 而非冷 cache 來定價。
此檢視也會估算背景 cache 保溫器對您流量的價值,將挽救的 cache 寫入與重播成本相抵後得出淨值。Benchmarks 數值可直接查詢:
GET /auto_router/benchmarks?start_date=2026-07-01&end_date=2026-07-31
節省會匯總到 Cost Optimization
Router 節省現在會與 prompt 壓縮和 prompt caching 一起匯入 Cost Optimization 區段,並擁有自己的卡片、節省行,以及 by-driver 明細中的一個切片。
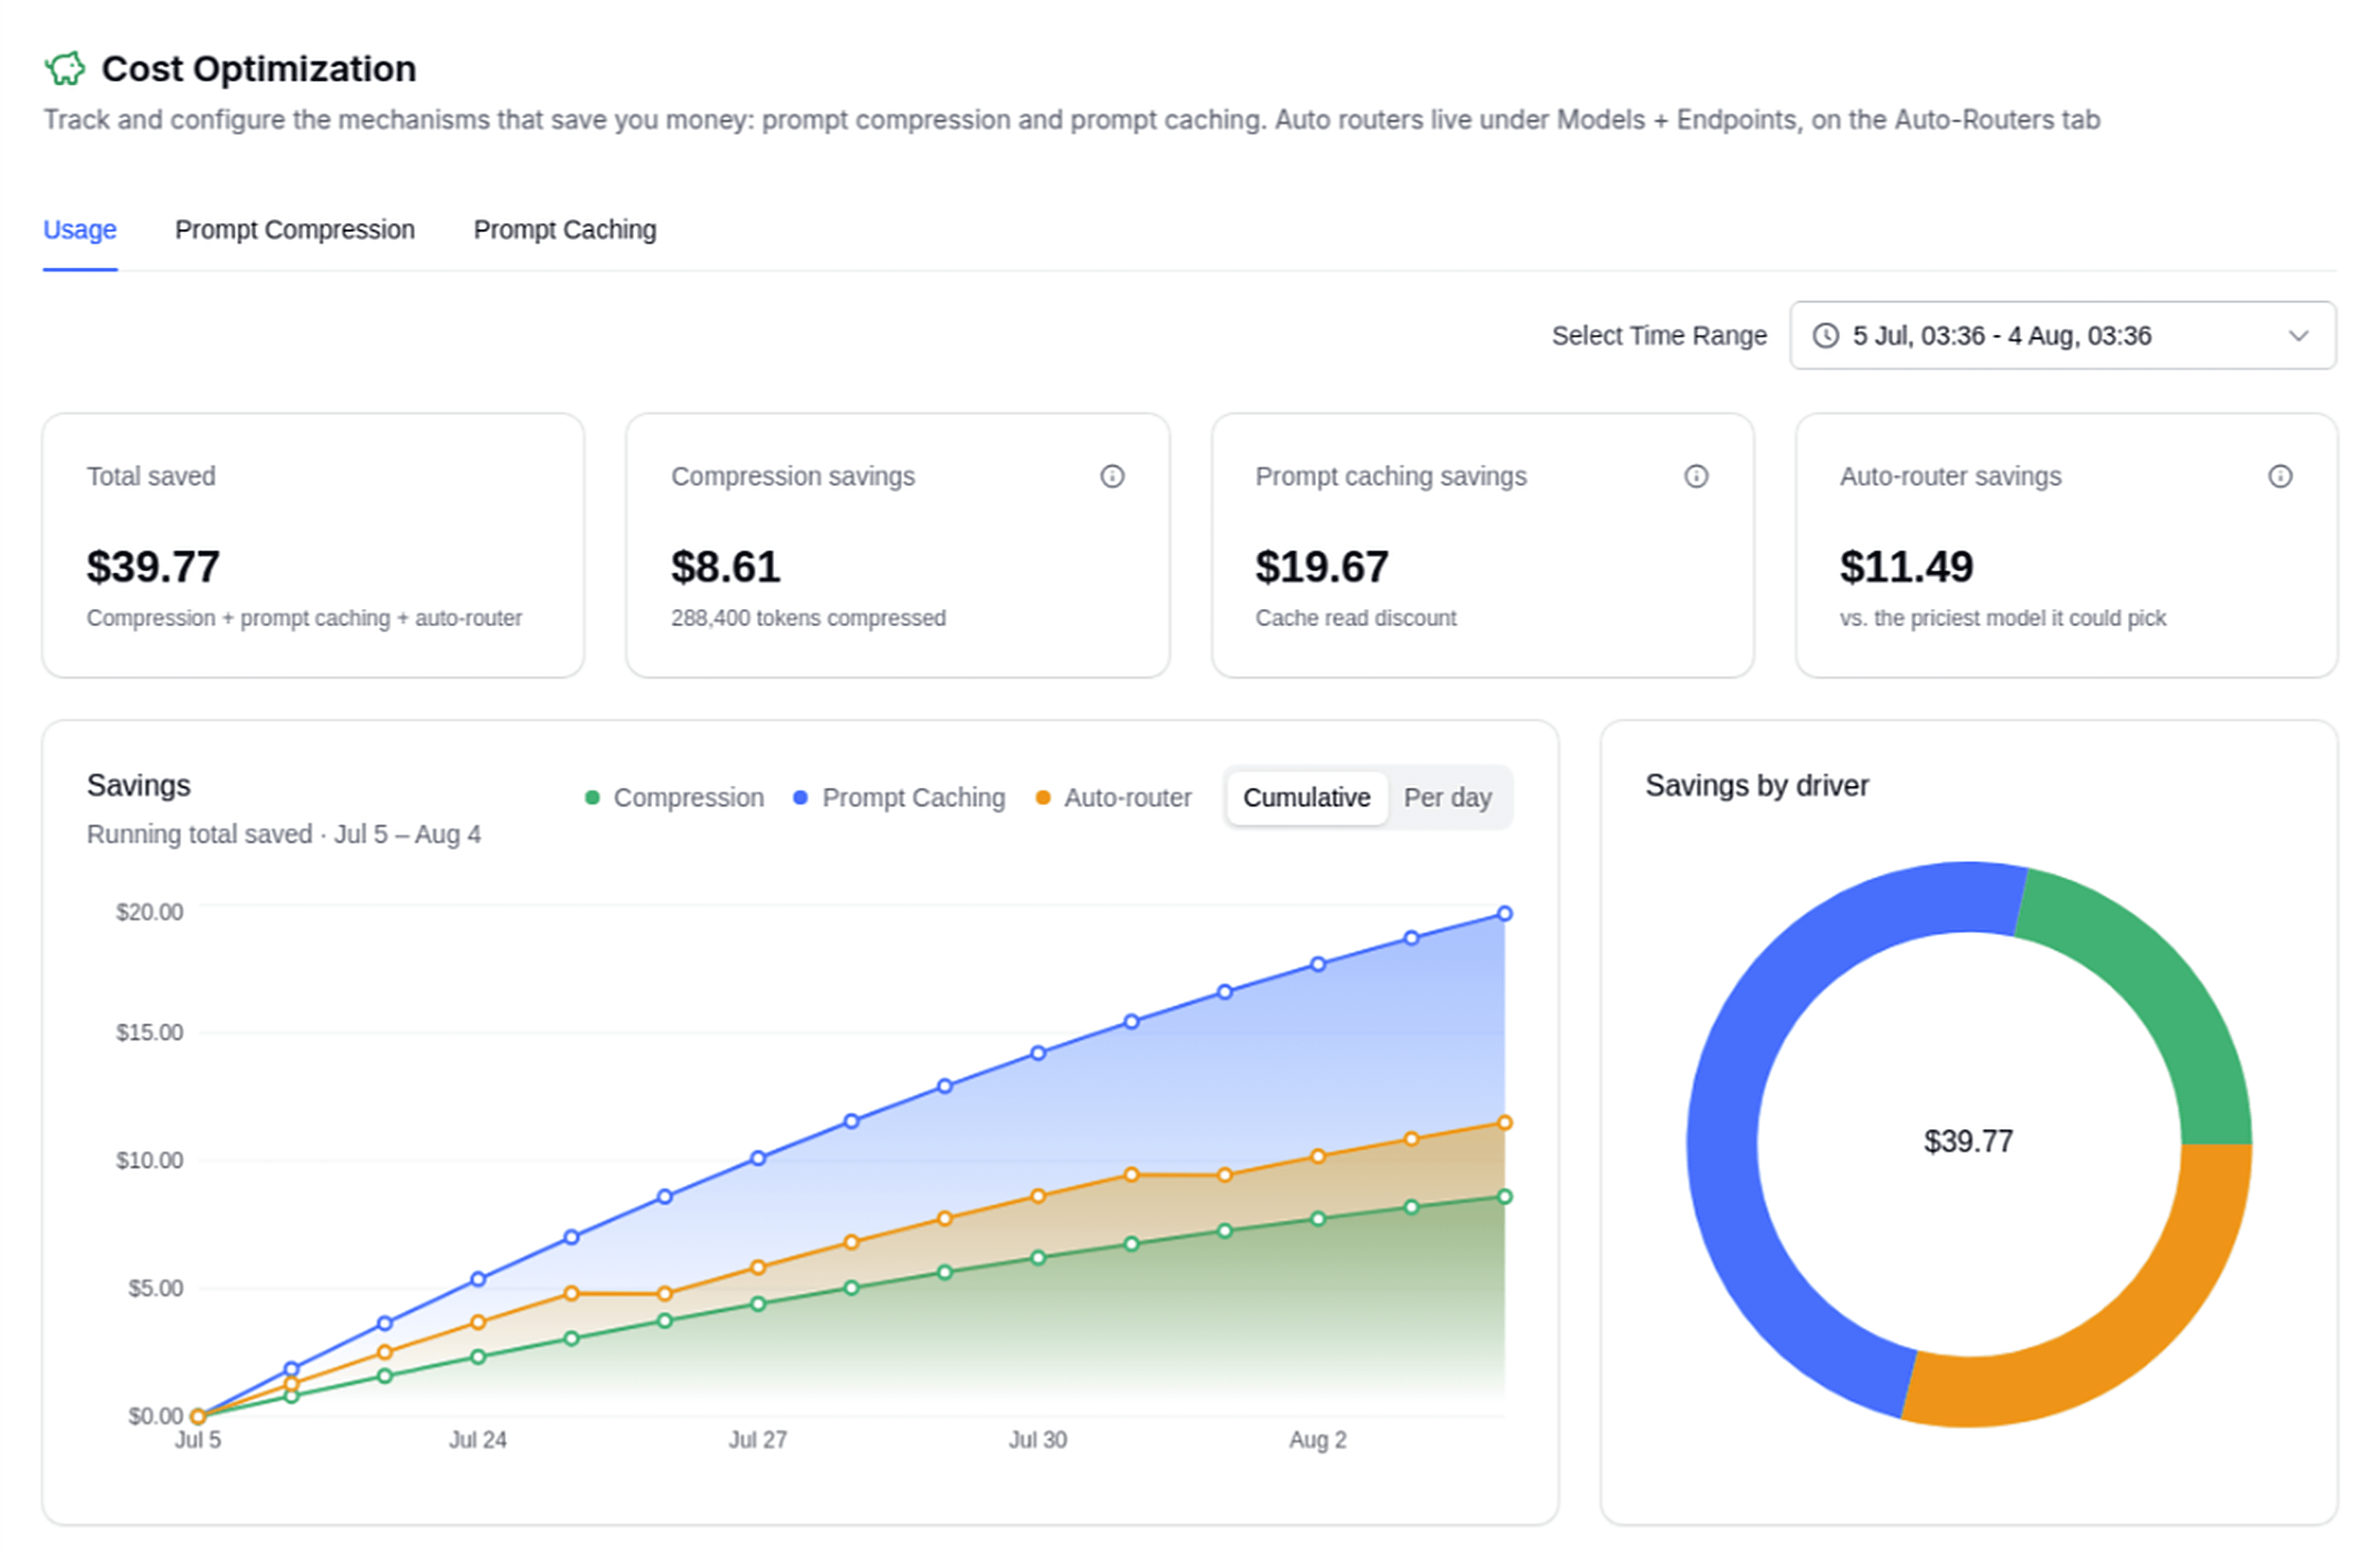
這兩個檢視回答的是不同問題,因此其節省數字不會相同。Benchmarks 會以一個 frontier 模型端到端為流量定價;Cost Optimization 卡片則計算 router 所選 tier 與它本可選擇的最昂貴 tier 之間的差額。
LLM 分類器可以看到先前幾輪
本節中的所有內容都需要 classifier_type: llm。heuristic scorer 不會呼叫模型,也沒有可放置 context 的位置,因此維持不變;下方三個欄位只會在 LLM 路徑上讀取。
問題
先前 LLM 分類器只會看到目前這一輪,對多輪查詢的效果不佳:
- 第 1 輪:「請為重新設計這個元件擬定一個計畫」
- 第 2 輪:「好,開始吧」
第 2 輪可能會被分類為簡單,但它所授權的工作其實相當龐大。
complexity_router_config 上的三個新欄位可解決這個問題:
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_config:
        classifier_type: llm
        classifier_llm_config:
          model: gpt-5.4-mini
        classifier_context_window_size: 3                  # default 3; 0 = old behavior
        classifier_context_per_turn_chars: 200             # default 200
        classifier_context_include_assistant_turns: false  # default false
先前輪次會依最早到最晚的順序插入,編號為 [1]、[2]、[3],每一輪都會裁切到 classifier_context_per_turn_chars,並以尾端省略號標示截斷處。
沒有人工撰寫文字的輪次不會佔用名額。工具輸出會被排除,<system-reminder> 區塊會被移除,移除後變成空白的輪次會被略過,而與正在分類的詢問完全相同的輪次會被丟棄。
啟用 classifier_context_include_assistant_turns 時,assistant 訊息會連同角色標籤一起加入這段 window,而該文字只會送到 classifier payload;關鍵字規則、升級處理、heuristic scorer 與語意比對仍只會讀取人類訊息。
我們測量了什麼
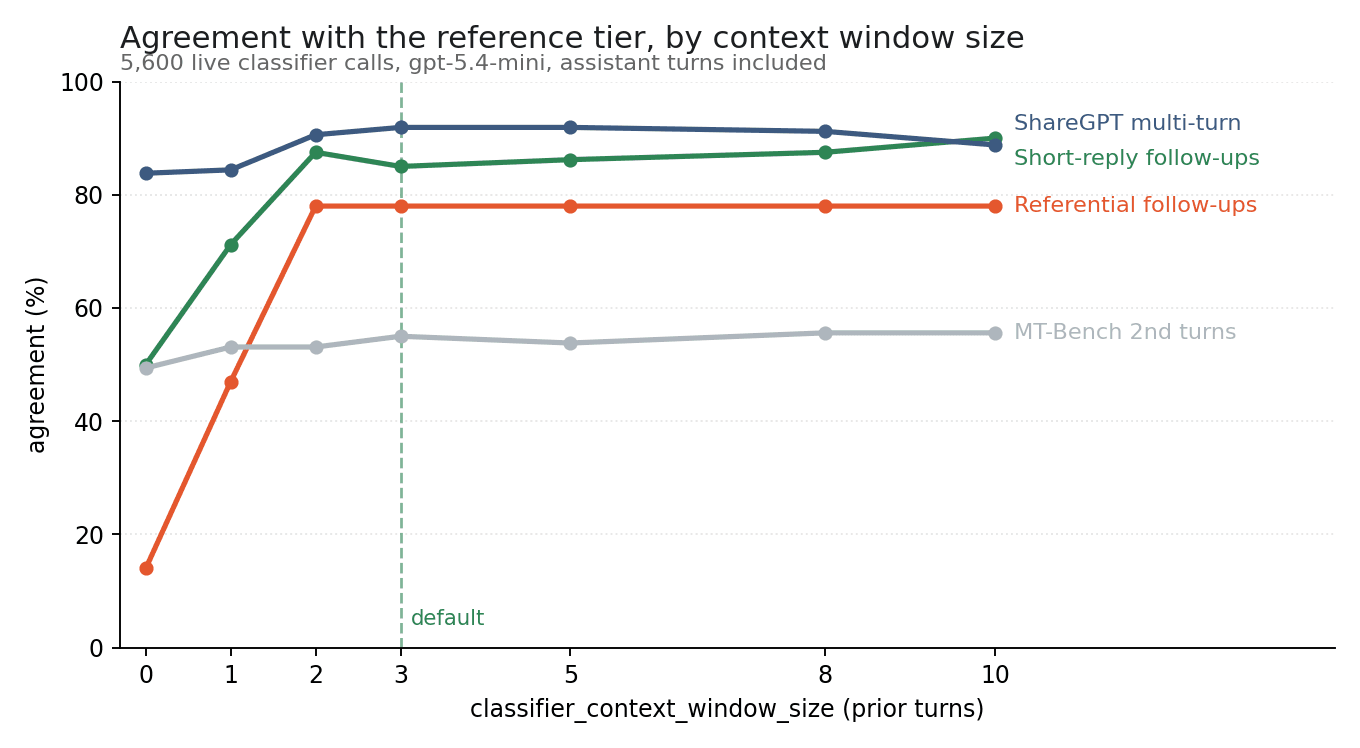
對真實提供者進行 5,600 次 live classifier 呼叫:兩輪掃描、每輪七種設定(classifier_context_window_size 為 0、1、2、3、5、8、10),一組在 window 中包含 assistant 輪次,另一組不包含,涵蓋三個多輪資料集,每段對話重複兩次。除設定外,其餘全部相同,包括對話內容、rubric、classifier 模型(gpt-5.4-mini)與每輪上限。
品質。 router 所選 tier 與參考 tier 之間的一致率:
| Window | 短回覆追問 | MT-Bench 第 2 輪 | ShareGPT 多輪 |
|---|---|---|---|
| 0 | 50.0% | 49.4% | 83.8% |
| 1 | 71.2% | 53.1% | 84.4% |
| 2 | 87.5% | 53.1% | 90.6% |
| 3 (預設) | 85.0% | 55.0% | 91.9% |
| 5 | 86.2% | 53.8% | 91.9% |
| 8 | 87.5% | 55.6% | 91.2% |
| 10 | 90.0% | 55.6% | 88.8% |
最大的影響出現在 36 個追問上,它們最後一輪只在歷史脈絡下才說得通。那部分的一致率在 N=0 時為 14%,N=1 時為 47%,N=2 時為 78%,之後一路到 N=10 都維持持平。同一組中的自我描述控制項在沒有 window 時為 80%,有一輪時為 91% 到 95%,因此這個 window 並不是讓所有數字都等比例上升。
N=1 只能恢復不到一半的落差。單一先前輪次只會讓分類器知道對話存在,卻無法建立其主題,因此在該設定下,大約三分之一的指涉性案例仍會被路由錯誤。
MT-Bench 的上限反映的是其參考標籤,而非 router 行為。其類別到 tier 的對應會把每個「寫作」的第二輪都指定為 MEDIUM,因此該欄位適合用來看趨勢,而不適合當作準確率分數。
延遲。 以每段對話相較於 N=0 配對比較,兩輪掃描中的每個 95% bootstrap CI 都包含 零:
| Window | 啟用 assistant 輪次 | 停用 assistant 輪次 |
|---|---|---|
| 1 | +21.5 ms [-19.6, +63.9] | -17.8 ms [-68.9, +29.6] |
| 2 | +10.5 ms [-31.2, +55.2] | -14.3 ms [-67.2, +34.4] |
| 3 | +6.2 ms [-30.0, +43.0] | -10.8 ms [-61.1, +37.1] |
| 5 | +6.0 ms [-37.5, +52.6] | +11.7 ms [-40.6, +61.9] |
| 8 | -10.5 ms [-45.0, +23.9] | +10.2 ms [-43.6, +63.9] |
| 10 | +9.0 ms [-25.9, +43.1] | -15.3 ms [-65.6, +30.0] |
在 318 到 1,043 個 token 的範圍內,prompt tokens 與延遲的相關係數為 r = 0.007(啟用 assistant 輪次)與 r = 0.018(停用 assistant 輪次)。這個 window 只增加 prefill;輸出仍然是固定且小型的結構化 tier。所有設定的 p50 都接近 600 ms。
成本。 這個 classifier 的成本最高為每 1,000 次請求 $0.61:
| Window | Classifier $/1k req(追問 / MT-Bench / ShareGPT) | 模型化路由 $/1k req |
|---|---|---|
| 0 | $0.31 / $0.32 / $0.34 | $2.87 / $5.41 / $5.48 |
| 2 | $0.38 / $0.42 / $0.44 | $6.79 / $4.65 / $5.31 |
| 3 | $0.38 / $0.42 / $0.47 | $6.49 / $5.13 / $5.14 |
| 10 | $0.38 / $0.42 / $0.61 | $6.42 / $4.87 / $5.22 |
tier 選擇主導了成本影響,而且會依流量不同而往兩個方向變動。
在短回覆集上,路由後成本從每 1k 的 $2.87 上升到約 $6.50。當 N=0 時,這些請求會送往便宜層級,同時授權大量工作;在 N=0 時,層級組合有 66% 為 SIMPLE,而 N=2 時為 30%,因此這個增加反映的是請求按其所需層級定價。相較之下,在 MT-Bench 和 ShareGPT 上,路由後成本反而略為下降,因為上下文將含糊的後續回覆解析為 MEDIUM,而不是 REASONING。
對特定部署適用哪個方向,取決於其流量,這也正是 Benchmarks 檢視頁的用途:在一天的流量之後,比較路由後支出與基準值。
要執行什麼
預設值 3 已經超過所有曲線趨於平坦的點,而超過這個值再增加分類器 token 也不會帶來可測得的增益。上表來自 assistant-turns-on 掃描;user-only 掃描則是預設值,會早一個槽位趨於平坦,因為否則一個 assistant turn 會消耗一個槽位,所以在兩種模式下 3 都已足夠。
classifier_context_include_assistant_turns 預設關閉,因為啟用它會改變層級判定,進而改變已在生產環境中的路由器支出。
classifier_context_per_turn_chars 最好維持在 200。趨於平坦的點會在上限生效前很久就到達,而截斷標記已足以表示某個 turn 被截斷。
注意事項
參考層級是判斷性的決定。人工標記與 ShareGPT 評審通過都編碼了這條規則:短回覆會繼承其所核准工作的難度,而這正是視窗產生的行為,使得後續集合既是這裡最銳利的工具,也是最有利的工具。
路由後的 completion 成本是模型化而非實際計費:將所選層級的價格套用到對話的 prompt tokens 加上 600 個輸出 tokens。沒有呼叫任何層級模型,這樣就能把層級選擇的影響與任何特定回覆的影響分離開來。
只對一個分類器模型做了掃描。較偏重推理的模型具有更高的絕對延遲,不過約 200 個額外 prefill tokens 的邊際成本應仍可忽略不計。
延遲是在單一 VM 上、並發 10 下測得。成對差異承載了這個發現;絕對數值則反映了該設定。
Session affinity 現在預設關閉
Session affinity 會將某個 session 綁定到處理其第一個 turn 的模型,之後跳過重新分類,目的是維持提供者 prompt cache 的熱度。這個預設值的變更有兩個原因。
我們的 prompt caching benchmark 檢視了 4,684 次切換,發現 97.4% 在 5 分鐘 TTL 下仍然是熱的,而在一小時時則有 99.3%。提供者快取在路由變更下仍可良好存活,因此綁定是在犧牲路由品質,去換取本來就會發生的快取命中。
此外,綁定部分上也是用來替代無法存取對話歷史的分類器,而這已不再需要。
未提到 session_affinity 的設定,在升級後會對每個 turn 進行分類。若要保留先前的行為,無論是為了嚴格的每個 session 模型一致性,或是為了足夠長、使未命中代價高昂的前綴,請明確設定:
      complexity_router_config:
        session_affinity: true
        session_affinity_ttl_seconds: 3600
Affinity 需要在 metadata 中有可解析的 session_id,且在設定了 plugins 時會被忽略。
試試看
model_list:
  - model_name: gpt-5.4-nano
    litellm_params: {model: openai/gpt-5.4-nano}
  - model_name: gpt-5.4-mini
    litellm_params: {model: openai/gpt-5.4-mini}
  - model_name: claude-sonnet-5
    litellm_params: {model: anthropic/claude-sonnet-5}
  - model_name: gpt-5.5
    litellm_params: {model: openai/gpt-5.5}

  - model_name: smart-router
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_default_model: claude-sonnet-5
      complexity_router_config:
        classifier_type: llm
        classifier_llm_config:
          model: gpt-5.4-mini
          timeout_ms: 2000
        classifier_context_window_size: 3
        classifier_context_per_turn_chars: 200
        tiers:
          SIMPLE: gpt-5.4-nano
          MEDIUM: gpt-5.4-mini
          COMPLEX: claude-sonnet-5
          REASONING: gpt-5.5
每個回應都帶有 x-litellm-model-name 和 x-litellm-response-cost,因此可在依賴任何彙總之前先檢查某個請求所屬的層級。在生產流量運行一天後,Benchmarks 中的路由後對基準值指標,比此處使用的任何資料集都更能精確描述特定工作負載。
完整文件:Auto Routing。