Published:
Tin LoAI Product Engineer, LiteLLM
我們透過結合複雜度與能力評估來改進 Fuse V2,以了解每個模型在哪些情況下成功、失敗,以及何時需要升級。

協助塑造 Auto-Router
與 LiteLLM 團隊合作,針對您的正式流量評估路由。
申請成為設計合作夥伴結果
我們評估了 SWE-bench Verified 上的 25 個任務,每個任務嘗試一次。本次執行的重點發現如下:
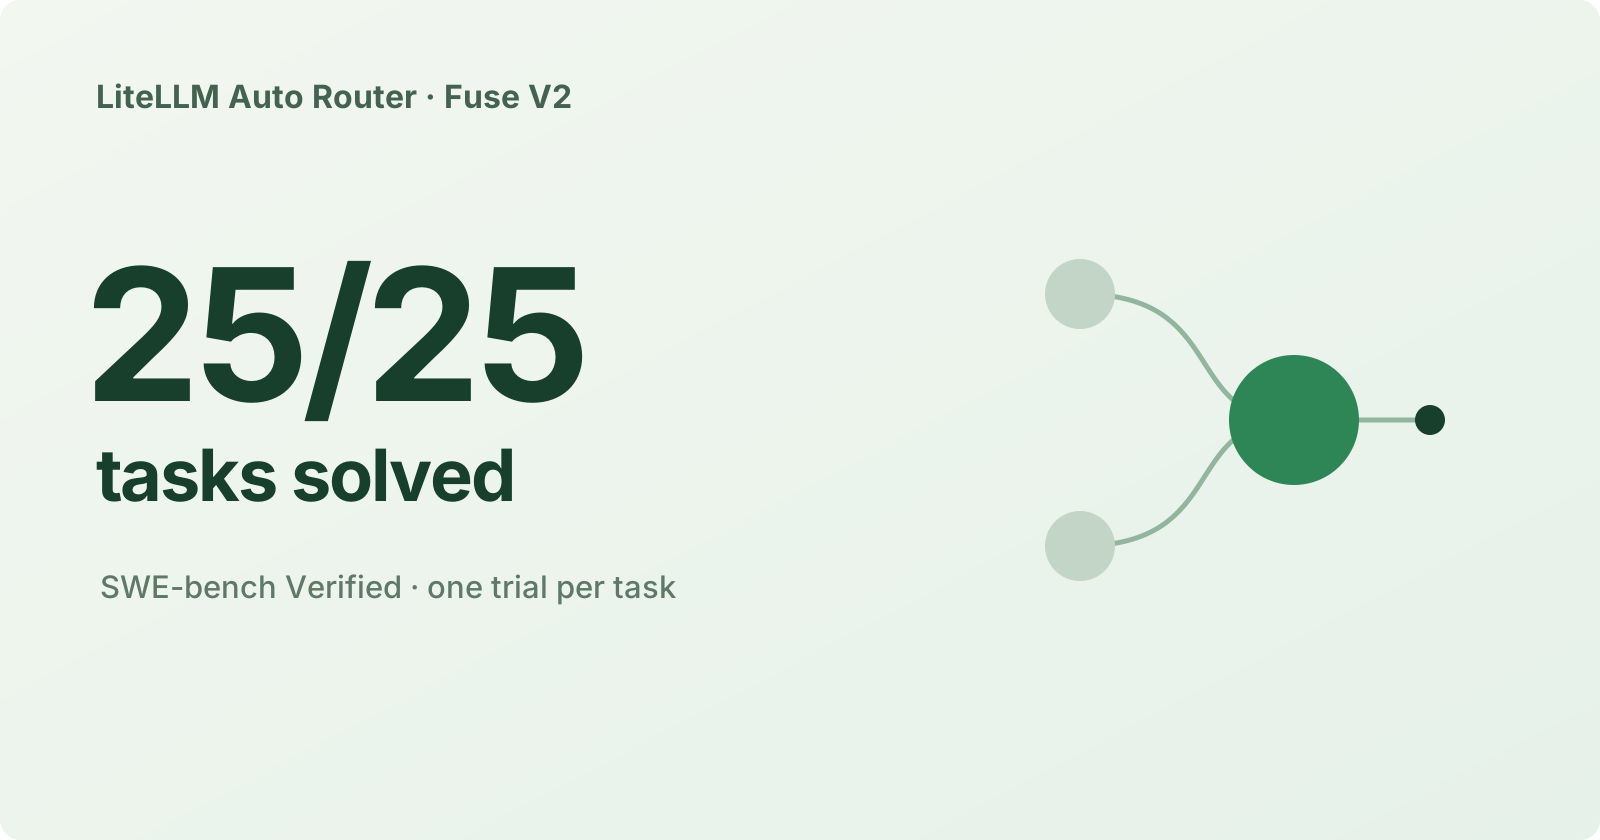
- 25/25 個任務成功解決,相較之下,能力分類器與僅使用 Opus 5 皆為 23/25。
- 每個成功解決任務的成本比複雜度分類器低 21%: $0.75 對 $0.95。
- 每個成功解決任務的成本比僅使用 Opus 5 低 15%: $0.75 對 $0.88。
| 組態 | 成功解決任務數 | 解決率 | 總成本 | 每個成功解決任務成本 |
|---|---|---|---|---|
| Fuse | 25/25 | 100% | $18.65 | $0.75 |
| 複雜度分類器 | 24/25 | 96% | $22.70 | $0.95 |
| 能力分類器 | 23/25 | 92% | $11.15 | $0.48 |
| NeMo Switchyard | 21/25 | 84% | $17.03 | $0.81 |
| 僅使用 Opus 5 | 23/25 | 92% | $20.27 | $0.88 |
| 僅使用 Sonnet 5 | 22/25 | 88% | $13.19 | $0.60 |
能力分類器的總成本與每個成功解決任務的成本最低。我們將總成本(包含分類器呼叫與未成功嘗試)除以成功解決的任務數。美元金額四捨五入至分;百分比降低使用四捨五入前的比率。下載結果表。
在測試設定下,我們將所有 Fuse V2 solver 呼叫送至 Opus。我們在僅使用 Opus 的執行中觀察到 23–25 次成功解決;這個單次試驗結果無法證明融合帶來可重複的品質或成本改善。
改進複雜度與能力的融合
我們希望預測模型何時會在任務上遇到困難,以及何時另一個模型可以幫助。於 Fuse V2 中,我們結合兩項評估:
- 複雜度: 評估任務的範圍、推理需求與可用檢查。
- 能力: 估計每個模型完成該任務的機率,並找出其可能的失敗方式。
我們在每個任務開始時向 judge 同時請求這兩項評估,然後重複使用模型選擇。接著,我們根據預測成功機率的差異,在各個 solver 之間做選擇。
在這個實驗中,我們比較了 Sonnet 5 與 Opus 5,並以 GPT-5.4-mini 作為 judge。請參閱 Fuse V2 實作。
學習每個模型在哪些情況下有效
從我們獨立的 Terminal-Bench 重複研究中的固定模型結果,我們看到了不同的優勢:
- pytorch-model-cli: Sonnet 成功解決 2/3 次嘗試;Opus 成功解決 0/3。
- query-optimize: Opus 成功解決 3/3 次嘗試;Sonnet 成功解決 1/3。
我們希望 Fuse V2 在選擇模型之前先辨識這些差異。為了改進整體評估,我們需要將其預測與每個模型在同一任務上實際能做到的結果進行比對。
我們下一步要改進的內容
我們的目標是讓能力分類器的成本維持不變,同時提供複雜度分類器的品質。我們正朝這個方向進行三個步驟:
- 校準模型預測。 在相同任務上執行兩個模型,並利用它們的成功與失敗來調整 judge 的預測。
- 調整何時升級。 使用獨立的調校資料,在模型能完成任務時選擇較便宜的模型,並在我們預期有足以抵銷額外成本的品質提升時進行升級。
- 驗證品質與節省。 在未見過的任務上重複測試 Fuse,追蹤解決率與每個成功解決任務的成本。
基準測試設定
- Harness: Harbor 0.22.0 搭配 mini-swe-agent 2.4.6;所有 arm 使用相同的 agent 組態與預算。
- 任務: 25 個 SWE-bench Verified 任務,使用 seed
20260911抽樣;每個任務與組態嘗試一次。 - 評分與成本: Harbor verifier
reward == 1.0;啟用 prompt 快取的 LiteLLM spend logs,並在各 arm 間一致。 我們排除了已被取代的設定失敗試驗。
成為 Auto-Router 設計合作夥伴
與 LiteLLM 團隊合作,在您的工作負載上測試 Fuse V2,並協助改進模型選擇。
申請成為設計合作夥伴