Auto-Router 會先詢問請求有多難,來挑選模型。這次版本新增了接下來緊接著的問題:請求是否適合我們挑選的模型,而該模型是否真的看得到它?
複雜度層級無法預測是否可路由。即使是一個極其簡單的問題,在程式編寫工作階段中送到 30 萬個 token 之後,仍然不能送往小型模型;而「這張螢幕截圖裡有什麼?」這種請求,也不可能送往純文字模型,不管問題有多簡單。路由器現在會在送出前檢查這兩者,而 shadow 評估可讓您在正式推送前,先在團隊的即時流量上驗證任何這些設定。
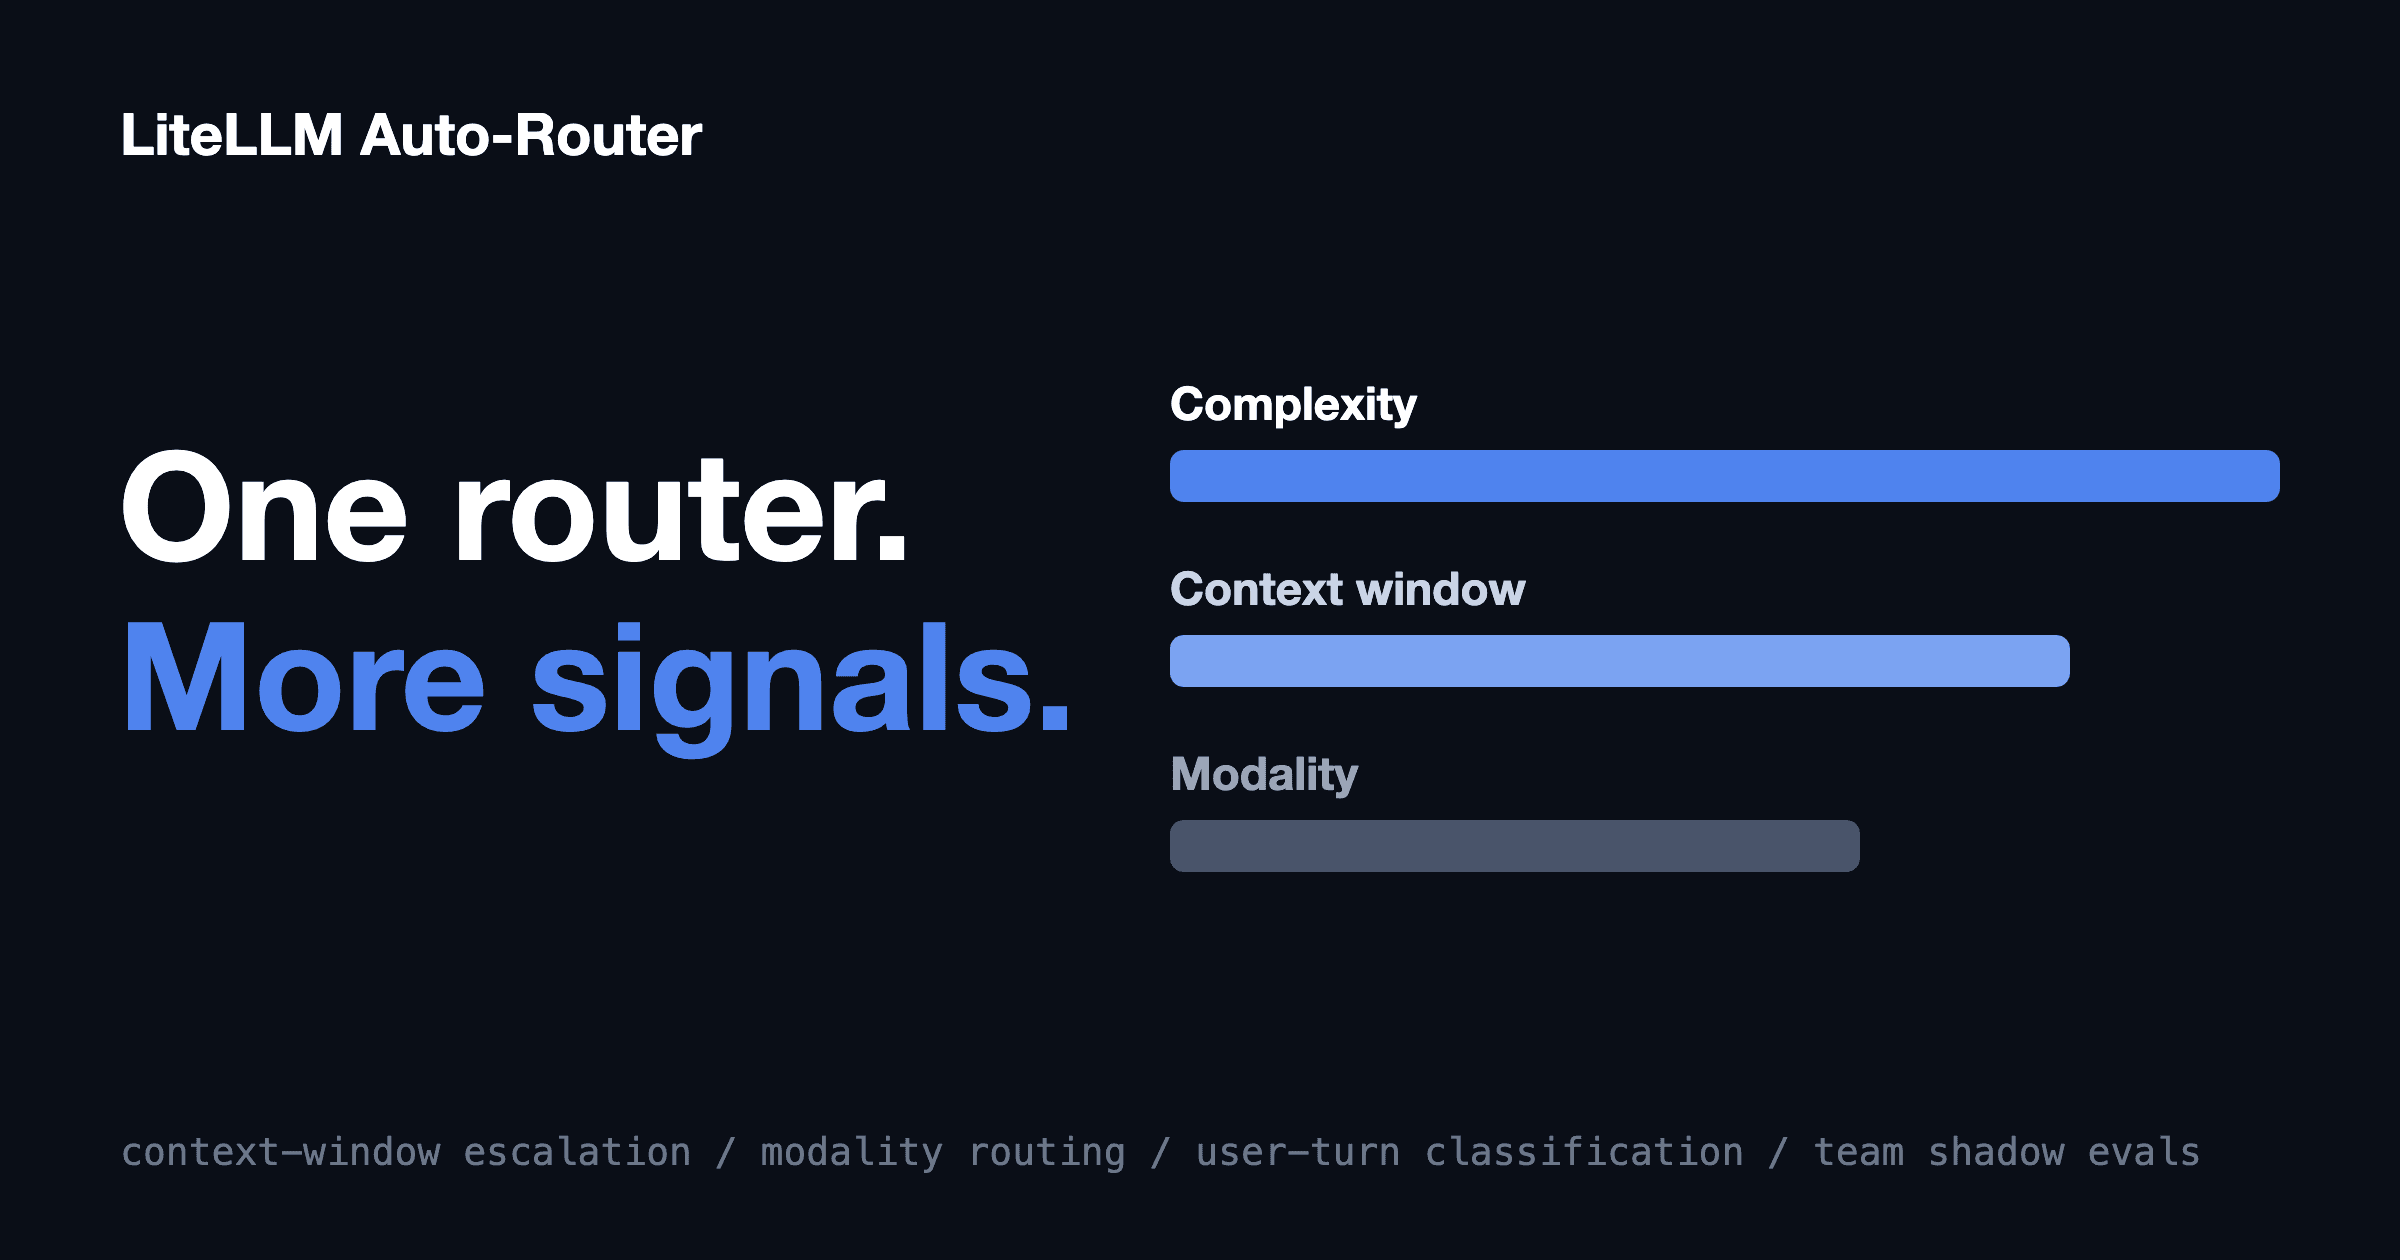
一個路由器,更多路由訊號
| 路由訊號 | 功能 | 設定鍵 | 預設值 |
|---|---|---|---|
| 複雜度 | 分類請求並挑選層級 | tiers | 核心行為 |
| 上下文大小 | 將明確無法放入已決定層級的提示升級 | enable_context_window_escalation | 開啟 |
| 模態 | 將含有圖片的請求路由至具備視覺能力的層級 | modality_routing | 關閉,需手動啟用 |
| 回合類型 | 僅分類新的使用者提問,跳過延續回合 | classification_mode: user_turn | every_request |
每個閘道都會回報自己做了什麼。已升級的決策會帶上 context_escalated 或 modality_escalation,以及分類器最初挑選的層級,因此路由器做的任何事都不會是看不見的。
基於上下文視窗的路由
對於「提示無法放入」的業界標準作法是反應式處理:先送出請求,捕捉 context-length 400,再用更大的模型重試。每一輪長會話都要為失敗的呼叫與延遲付出代價。我們檢視路由產品如何處理這件事時,反應式備援是常態;我們沒有找到任何一個會在送出前依 token 數過濾候選項目的產品。
Auto-Router 現在會在送出前完成這件事:
- 在送出前估算完整提示的占用量,包含 system prompt 與工具定義;對於像 Claude Code 這類編碼代理程式,這些內容承載了大部分負載
- 升級到可明確容納的最便宜層級。 先由已決定層級中可容納的模型群組勝出,因此您永遠不會為超出提示所需的更高規格模型付費
- 未知的上下文視窗會保持不變。 只有在能證明不相容時,閘道才會動作
- 已升級的決策絕不會綁定於工作階段。 當工作階段縮小後,路由也會跟著降回來
- 預設開啟,並帶有安全緩衝(
context_window_escalation_buffer: 0.95),讓接近上限的提示會升級,而不是賭一把
基於模態的路由
如果您的便宜層級只支援文字,而請求包含圖片,過去的結果會是在請求已經離開閘道之後才由提供者端回傳錯誤。使用 modality_routing: true 後:
- 會在請求中的任何位置偵測圖片:OpenAI
image_url與input_image部分、Anthropicimage區塊,以及巢狀於工具結果中的圖片,這正是真實代理程式螢幕截圖送入時的形式 - 路由器會往上尋找最近的具視覺能力層級,從分類器決定的層級開始
- 沒有任何層級能看見?閘道會直接回傳清楚的 400,而不是令人困惑的提供者錯誤
- 設計上採保守策略。 只有明確標示為不具視覺能力的模型才會被排除;未知模型仍保有資格
- 需手動啟用,預設關閉
在有意義時才進行分類
代理式工作階段在每次對話中會發出許多請求,而其中大多數(工具結果、追問、重試)都不是新問題。使用 classification_mode: user_turn 時,分類器只會在最新訊息是真正新的使用者提問時執行,而既有決策則會延續到後續回合。分類器呼叫更少、路由額外負擔更低,且在任務進行中模型選擇更穩定。
先在團隊上做 shadow 評估,且在沒人察覺前完成
shadow 評估 會在不改變任何使用者可見回應的情況下,測試 Auto-Router。現在您可以用它們做到:
- 鎖定一個
key、一個team,或一個user。 具 JWT 驗證的流量沒有可指向的虛擬金鑰;第一次可讓團隊與使用者目標變得可評估 - 在同一個工作中比較多個路由器設定,使用相同抽樣流量
- 信任比較結果:抽樣是配對的。 每個設定都會看到完全相同的請求,因此品質與成本差異來自設定本身,而不是流量運氣
這就把上述一切串起來了:先用新的閘道草擬設定,用它在真實團隊流量上與您目前的路由器做 shadow 比較,閱讀配對比較結果,然後將勝出的版本正式上線。
啟用方式
model_list:
  - model_name: gpt-4o-mini
    litellm_params: {model: openai/gpt-4o-mini, api_key: os.environ/OPENAI_API_KEY}
  - model_name: gpt-4o
    litellm_params: {model: openai/gpt-4o, api_key: os.environ/OPENAI_API_KEY}
  - model_name: claude-sonnet-5
    litellm_params: {model: anthropic/claude-sonnet-5, api_key: os.environ/ANTHROPIC_API_KEY}
  - model_name: gpt-5.5
    litellm_params: {model: openai/gpt-5.5, api_key: os.environ/OPENAI_API_KEY}

  - model_name: smart-router
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_config:
        tiers:
          SIMPLE:    gpt-4o-mini
          MEDIUM:    gpt-4o
          COMPLEX:   claude-sonnet-5
          REASONING: gpt-5.5

        # on by default: escalate prompts that provably don't fit
        enable_context_window_escalation: true
        context_window_escalation_buffer: 0.95

        # opt-in: route image requests to vision-capable tiers
        modality_routing: true

        # classify new user asks, carry the decision through continuation turns
        classification_mode: user_turn
      complexity_router_default_model: gpt-4o
上下文視窗升級已經開啟;長會話將不再失敗。模態路由只需要一行。這兩者都會顯示在路由決策中,因此您可以 دقیق確看到每個閘道何時以及為何觸發。
將一個 shadow-eval 工作指向您最繁忙的團隊,把目前設定與已開啟新閘道的設定進行比較,並在 討論串 #32168 告訴我們您的發現,或者
申請成為設計夥伴