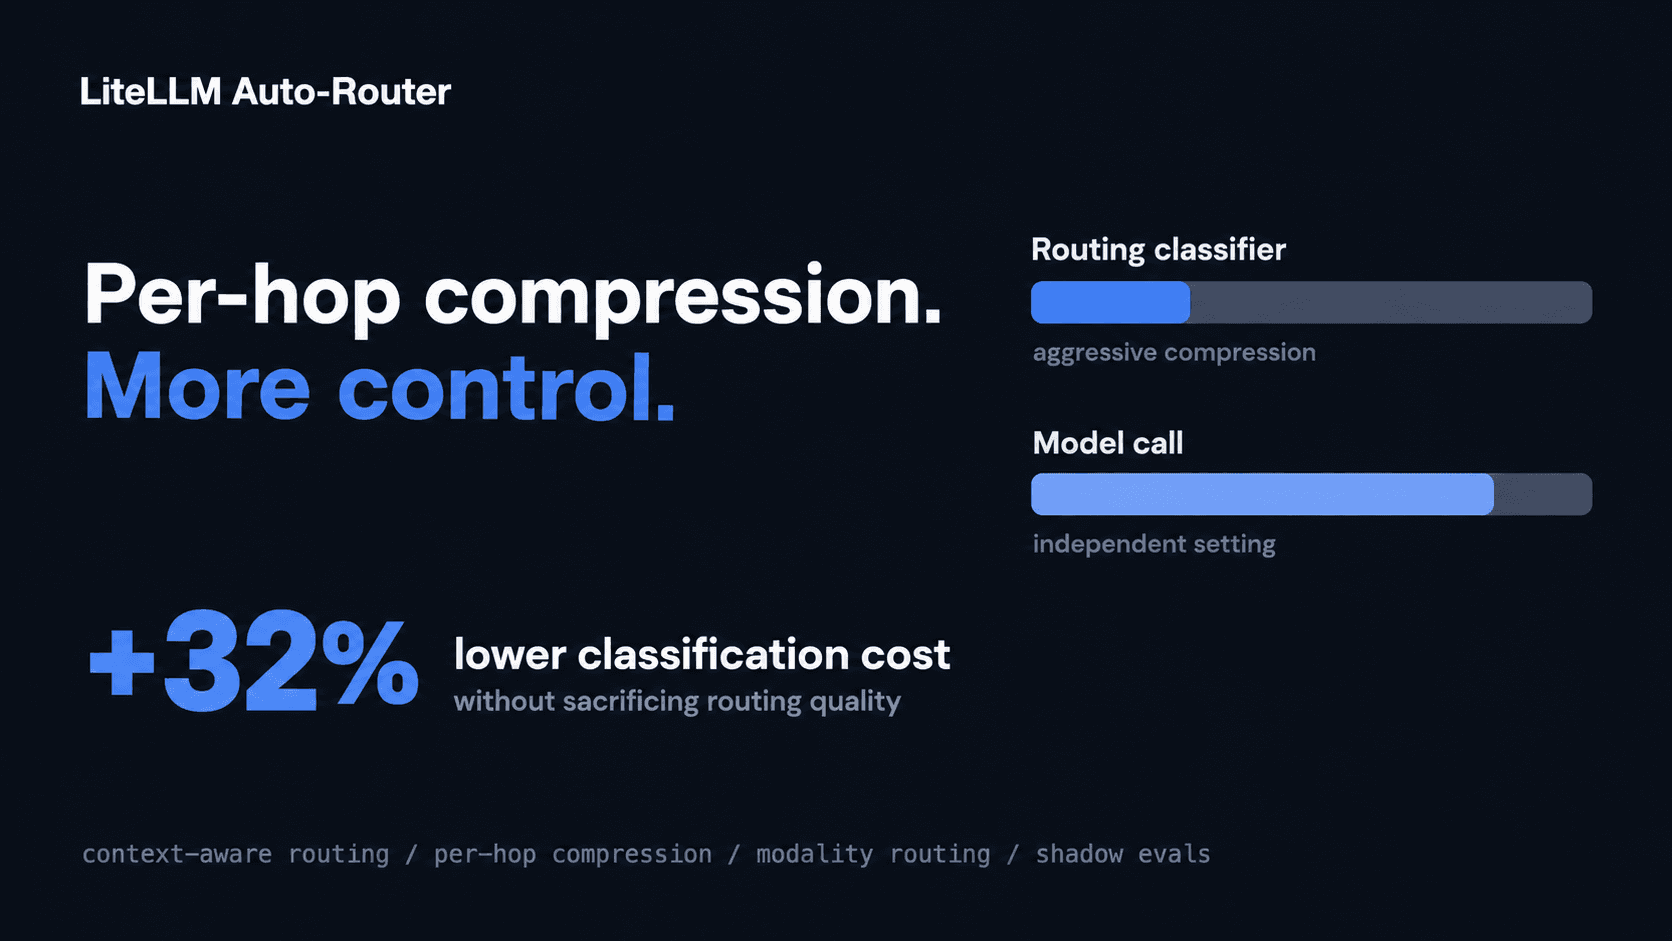
complexity router 的 LLM 分類器現在可以比您的模型呼叫更積極地壓縮。在內部測試中,這讓分類成本在共享壓縮原本已節省的基礎上再降低 32%,且路由準確度沒有變化。
問題
complexity router 可以用幾種方式對請求分類:免費的啟發式評分器、關鍵字規則,或者當您需要啟發式方法無法捕捉的判斷時,使用 LLM 分類器。最後這個選項會讓每個請求多付一次 LLM 呼叫費用:先呼叫一次來決定等級(SIMPLE 對應便宜的模型、MEDIUM 對應中間層級的模型、COMPLEX 或 REASONING 對應前沿模型),再呼叫第二次真正回答的模型。
直到現在,這個分類器呼叫都與它所路由到的模型呼叫共享壓縮設定,這表示分類器的壓縮上限受限於模型呼叫所能容忍的程度。這個上限並不正確。分類器只需要足夠的上下文來回答一個問題:這個請求由哪個等級處理。它不需要完整的對話歷史或模型呼叫為了實際產生回應所需的詳細背景,因此它可以被壓縮到遠超過模型呼叫開始受影響的程度。
解決方案
兩個新欄位將 LLM 分類器的壓縮與模型呼叫的壓縮解耦:
auto_router_routing_compression:用於壓縮分類器提示詞的防護欄auto_router_model_compression:用於壓縮模型提示詞的防護欄
將路由壓縮設為更積極,而模型呼叫壓縮維持適中。若兩個跳點都使用相同的防護欄,則只會執行一次壓縮,不會執行兩次。任何一個欄位都可以設為 none 以略過該跳點的壓縮。
運作方式
當您透過具有 classifier_type: llm 和分離壓縮設定的 complexity router 傳送請求時:
- 代理伺服器會將路由跳點壓縮套用到您的訊息副本
- 分類器會看到壓縮後的版本並做出路由決策
- 您的原始訊息會套用模型跳點壓縮
- 被路由的模型會接收自己的壓縮副本
- 在記錄和 API 回應中,您會看到每個跳點執行了哪個壓縮防護欄
如果兩個跳點使用相同的防護欄,代理伺服器只會壓縮一次並重用結果。如果某個壓縮防護欄無法連線且設為 fail_closed,請求會安全失敗。
設定方式
model_list:
  - model_name: gpt-4o-mini
    litellm_params: {model: openai/gpt-4o-mini, api_key: os.environ/OPENAI_API_KEY}
  - model_name: gpt-4o
    litellm_params: {model: openai/gpt-4o, api_key: os.environ/OPENAI_API_KEY}
  - model_name: gpt-4-turbo
    litellm_params: {model: openai/gpt-4-turbo, api_key: os.environ/OPENAI_API_KEY}

  - model_name: smart-router
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_config:
        tiers:
          SIMPLE: gpt-4o-mini
          MEDIUM: gpt-4o
          COMPLEX: gpt-4-turbo
        classifier_type: llm

        # Aggressive compression for the classifier
        auto_router_routing_compression: headroom-aggressive
        # Moderate compression for the model call
        auto_router_model_compression: headroom-moderate

guardrails:
  - guardrail_name: headroom-aggressive
    litellm_params:
      guardrail: headroom
      mode: pre_call
      api_base: https://api.berri.ai/headroom
      model: o1
      tokens_to_retain: 200

  - guardrail_name: headroom-moderate
    litellm_params:
      guardrail: headroom
      mode: pre_call
      api_base: https://api.berri.ai/headroom
      model: gpt-4o-mini
      tokens_to_retain: 1000
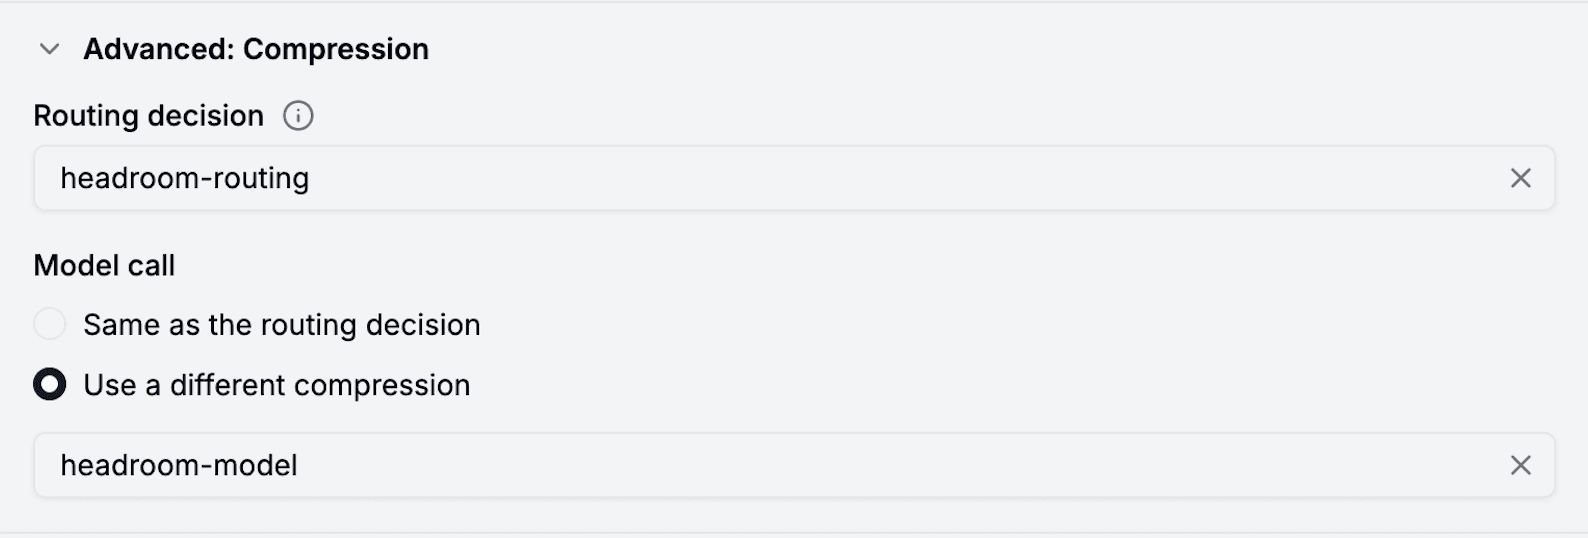
在 Admin UI 中,開啟 complexity router 的 Detailed Configuration,然後進入 Advanced: Compression。選擇您的路由防護欄,替模型呼叫選擇「Use a different compression」,並分別選取其防護欄。
將 shadow-eval 工作指向您流量最大的團隊,比較您目前的設定與分離壓縮設定,並在 discussion #32168 告訴我們您的觀察結果,或
申請成為設計合作夥伴