Published:
Tin LoAI Product Engineer, LiteLLM
以下所有內容都已包含在 v1.97.x 中。
查看與相關模型基準比較的 Auto-Router 節省成效與使用情況
試用 Auto-Router 的團隊最常問的問題是「它實際幫我省了多少」。現在有一個分頁可以回答這個問題。
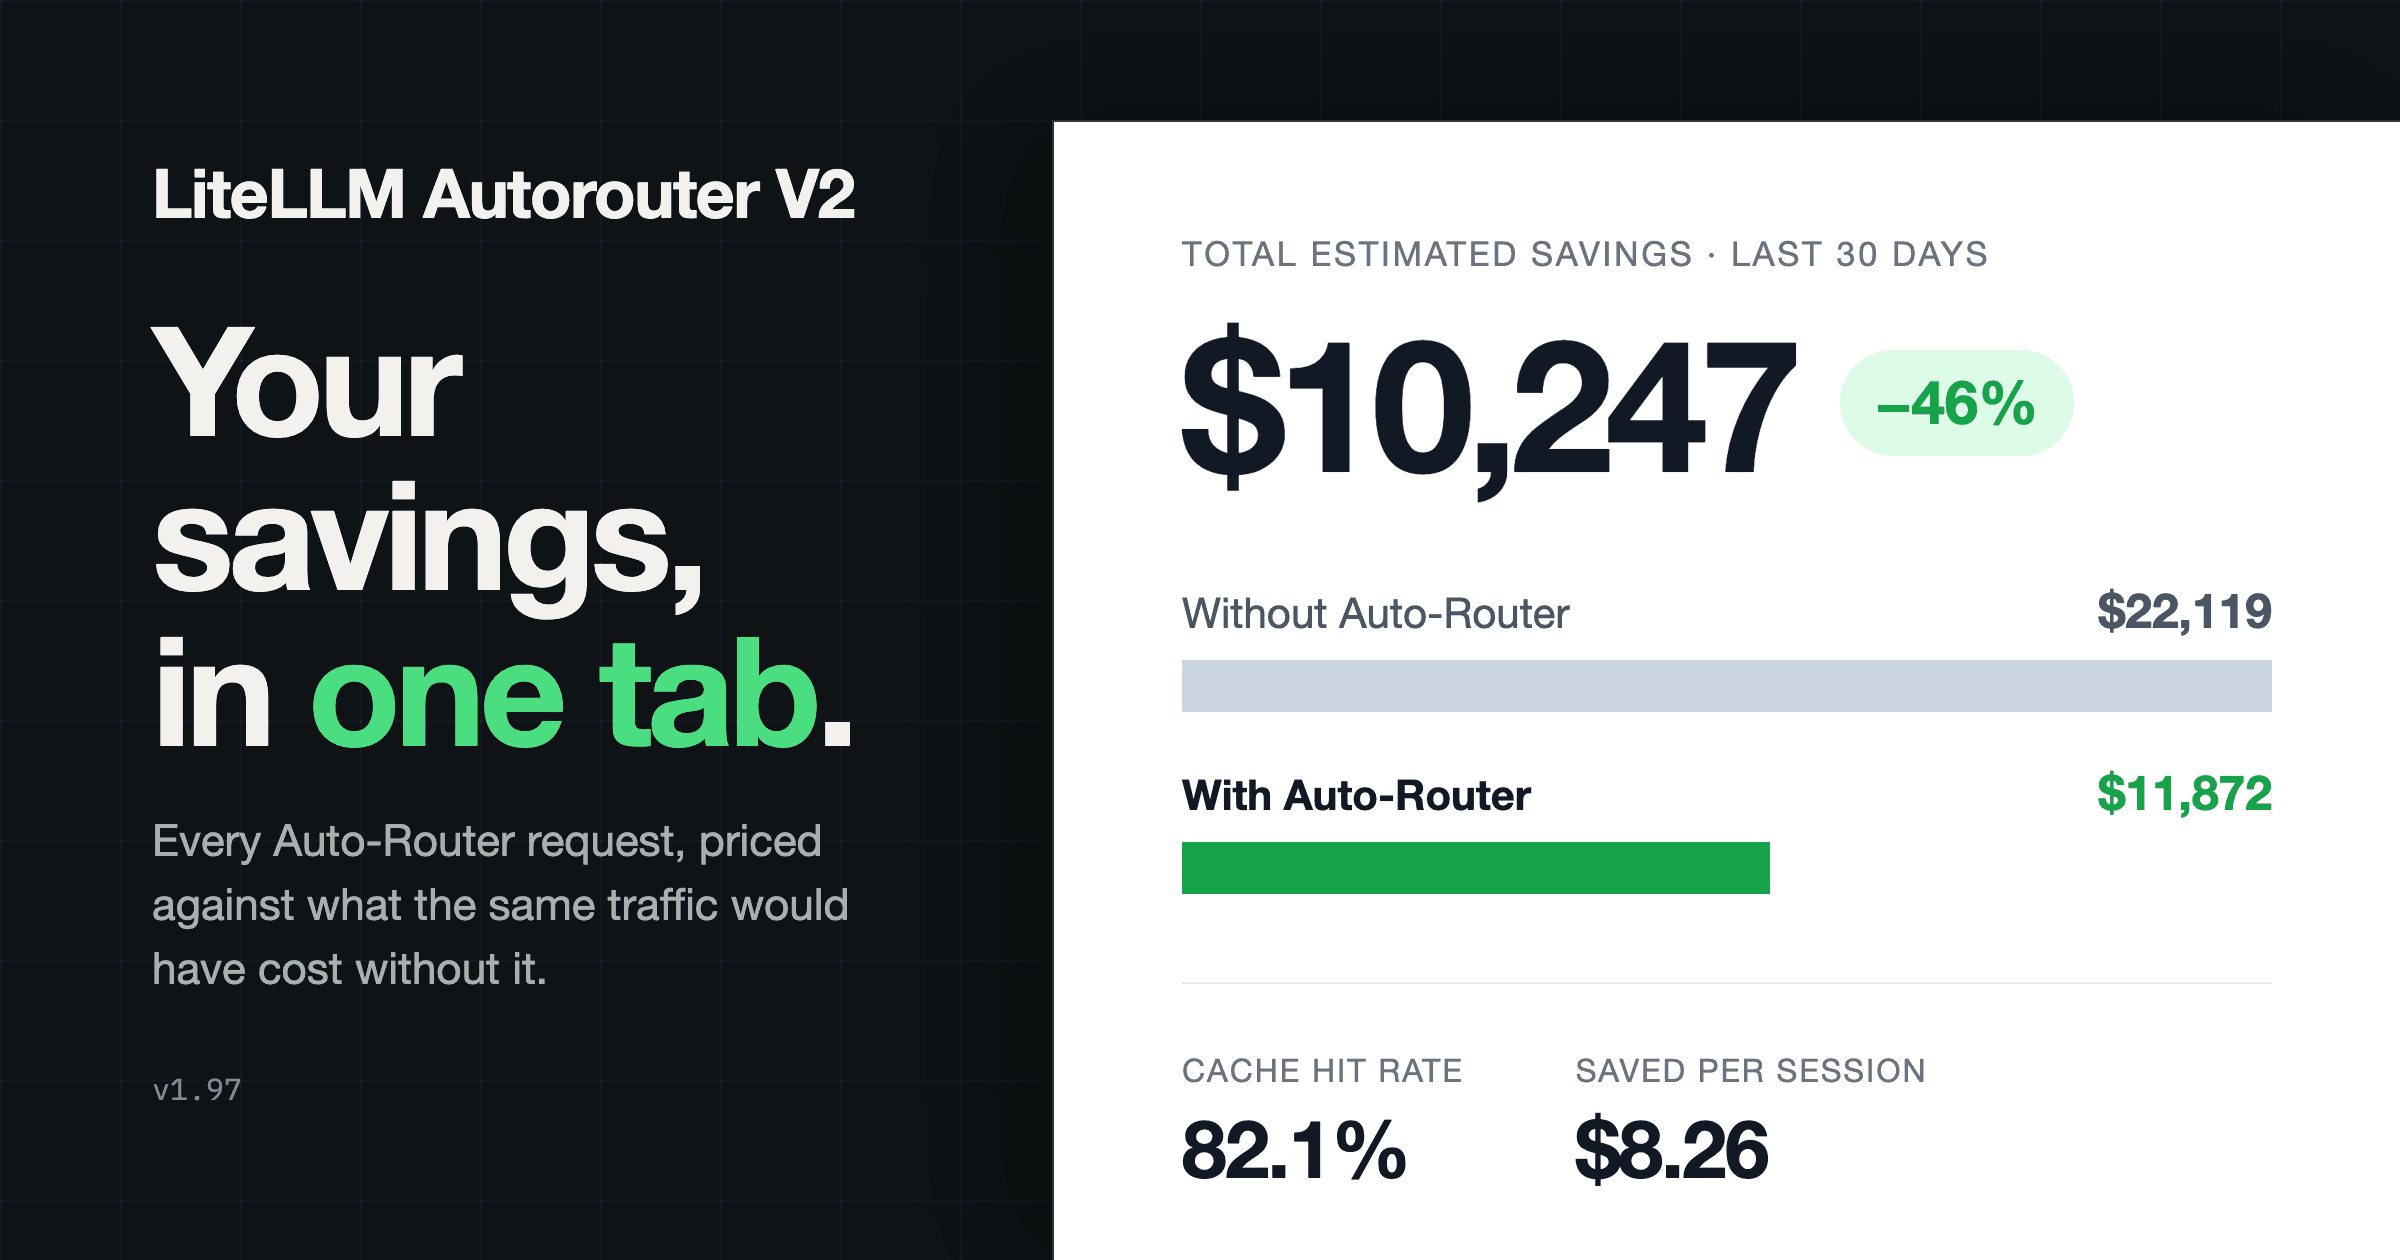
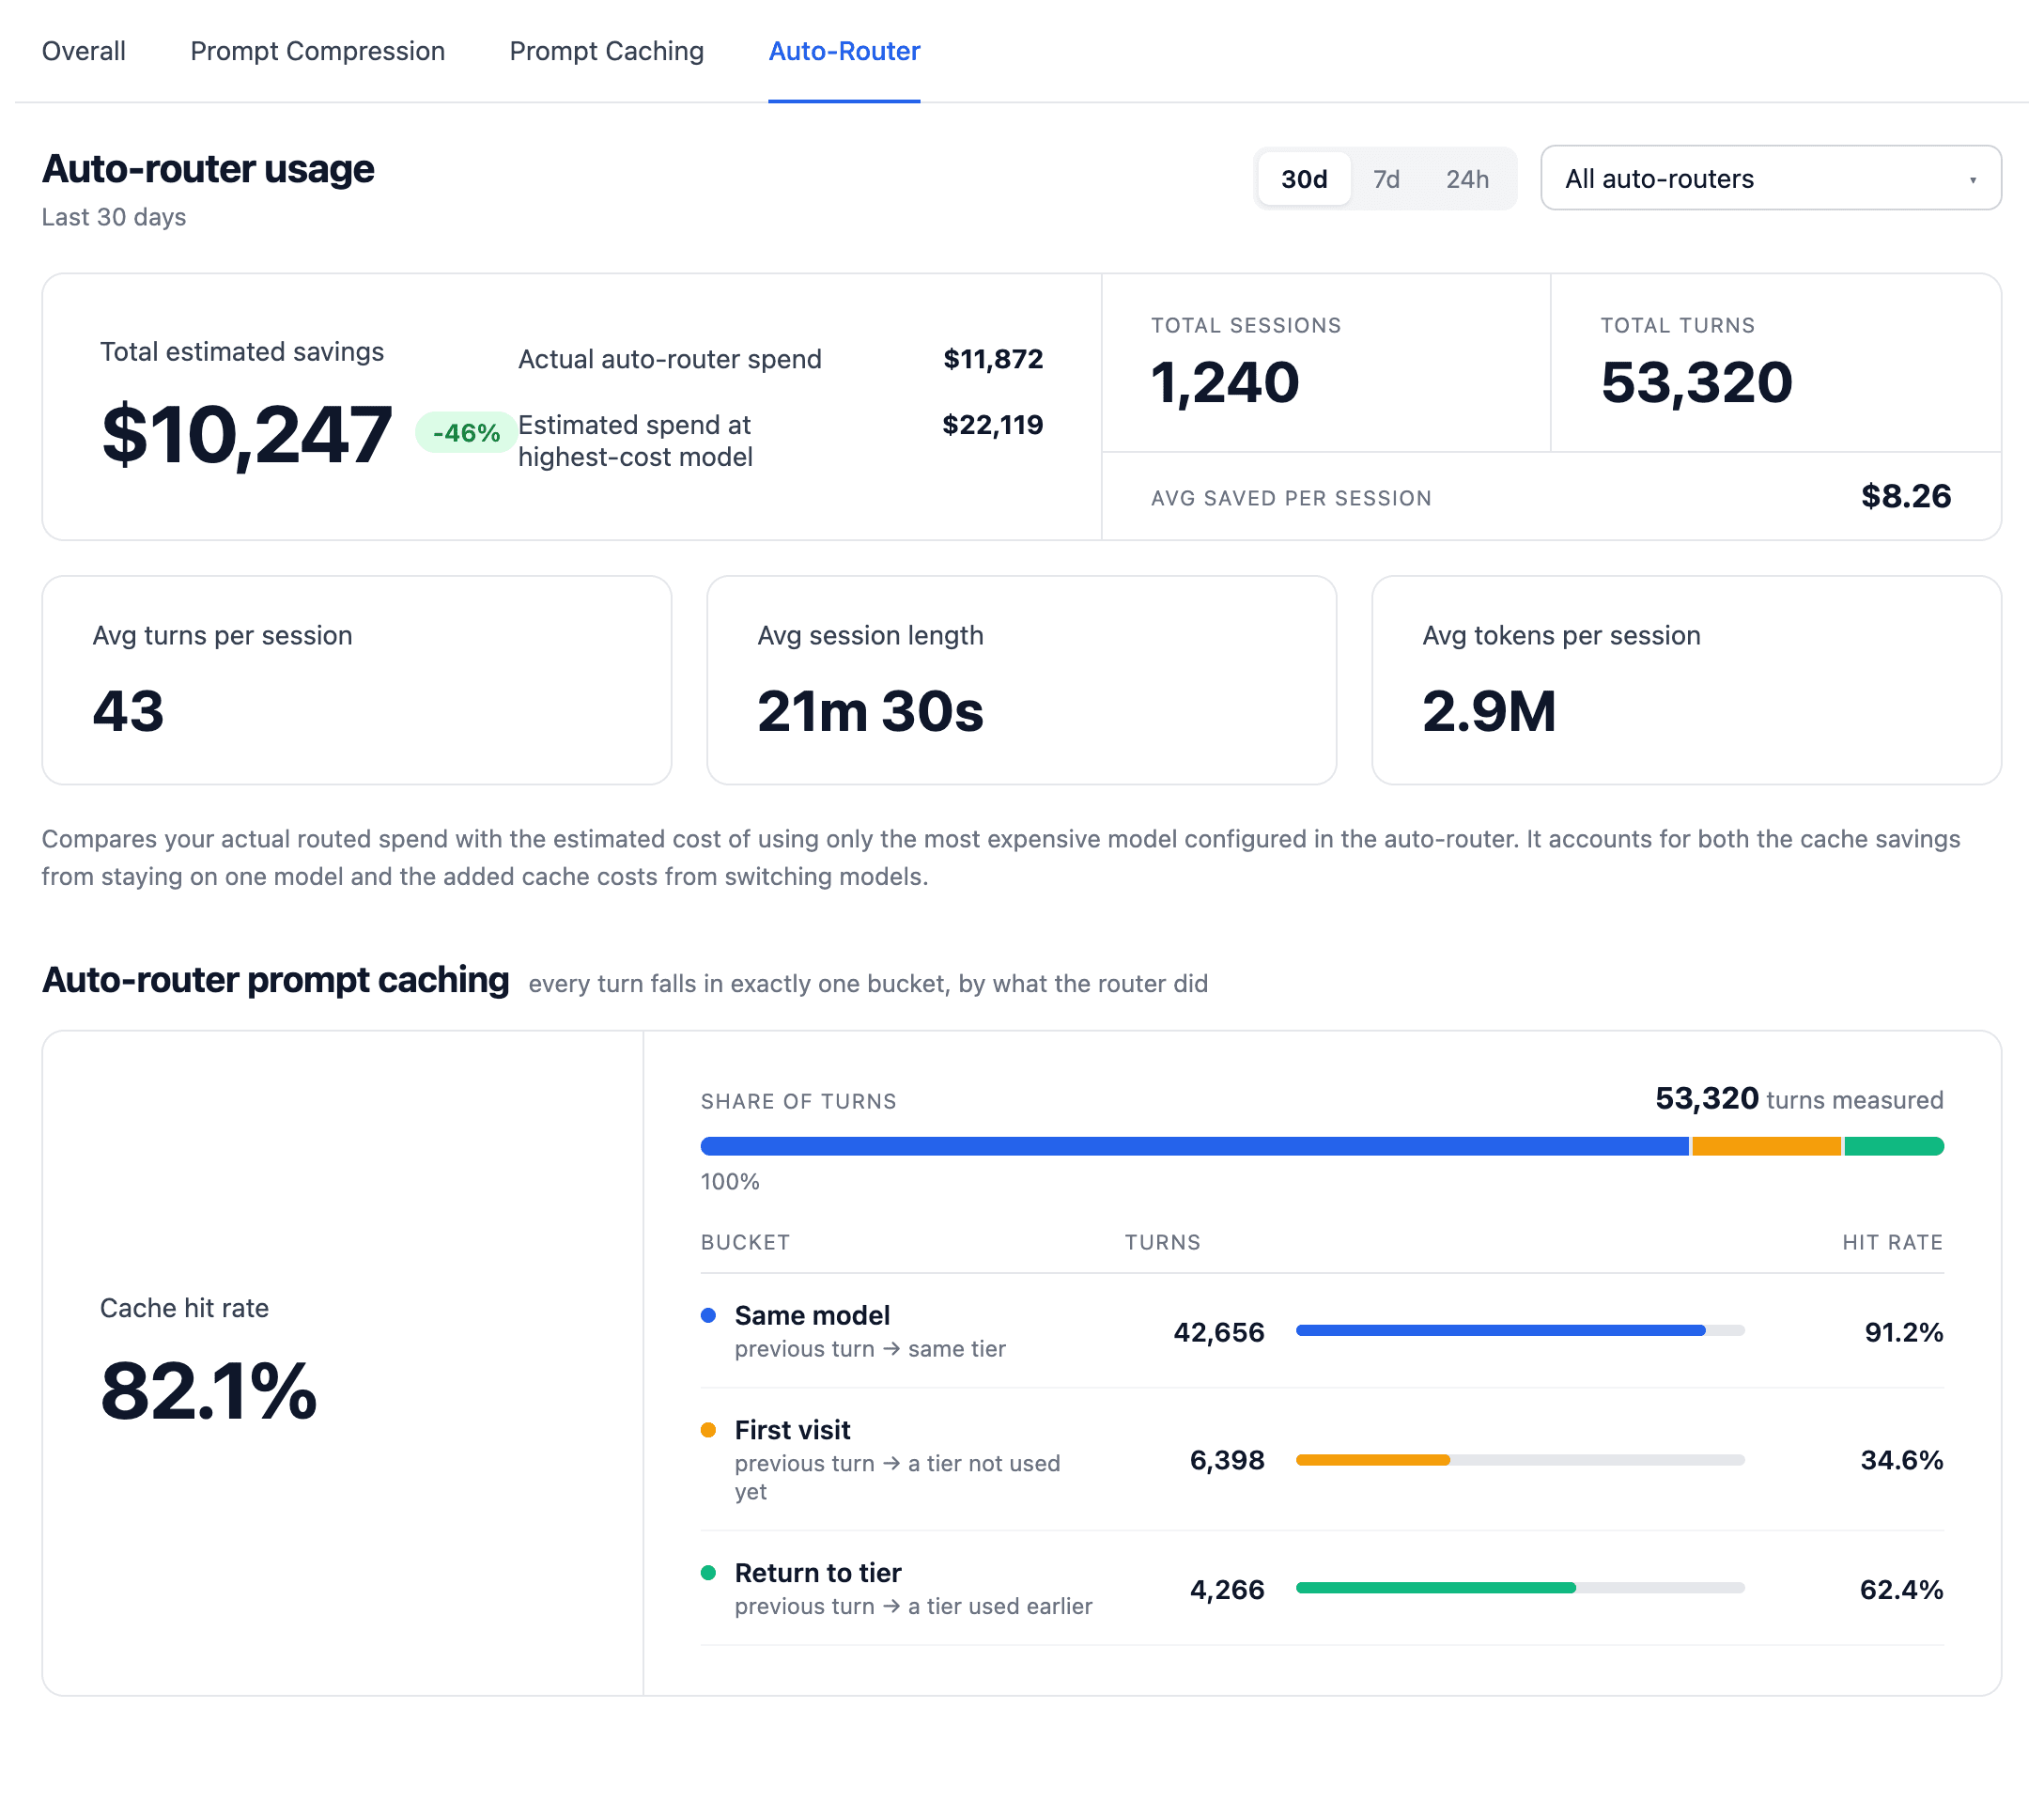
Cost Optimization 新增了 Auto-Router Usage 分頁。它涵蓋最近 24 小時、7 天或 30 天,可針對單一路由器或所有路由器合併顯示,並顯示:
- **總預估節省:**以美元與百分比呈現,將您實際的路由後支出,與若每個請求都送往該路由器中最昂貴模型時的相同流量成本相比。它是以取代「直接永遠使用最佳模型」這個設定來為路由器定價,而此預估已同時考量雙向快取
- **使用情況:**Auto-Router 上的總 session 數與 turn 數,以及每個 session 的平均支出、turn 數、持續時間與 token 數
- **Prompt caching:**整體快取命中率,並依路由器在每個 turn 上的動作拆分(維持在相同模型、首次造訪某個層級,或回到先前使用過的層級),讓您判斷更長的 cache TTL 或背景 cache warmer 是否值得
這些數字來自新的每個 session 彙總表,因此此分頁在大規模下仍能保持快速;在我們的負載測試中,涵蓋 40 萬個 session 的 30 天視窗讀取時間為 38 ms。
接下來:將 Auto-Router 的品質與 turn 數,和您組織的等效使用情況進行基準比較。
每個請求記錄 LLM 分類器成本
當複雜度路由器使用 LLM 分類器時,該分類器呼叫會產生費用,但直到現在,觸發它的請求上都看不到這筆費用。現在您可以按請求量化路由開銷。
- 分類器呼叫的成本會記錄在
routing_decision記錄中,作為classifier_cost,因此它會進入 spend-log 中繼資料以及每個StandardLoggingPayload消費者(Langfuse、OTel、S3,以及其他) - 新的
x-litellm-classifier-cost回應標頭會在/v1/chat/completions、/v1/messages和/v1/responses上按請求回報它,包含串流
現在預設會比對您的實際部署
一鍵 Anthropic 和 OpenAI 預設不再依賴您的部署名稱是否與預設所預期的一致。
- 預設現在會根據您部署底層的提供者模型 ID(
litellm_params.model,以及設定時的model_info.base_model)來解析,而不是直接比對名稱字串 - 以這種方式解析的預設會顯示「Matches your deployments」提示,排序會排在不可用項目之前,並保持設定開啟,讓您看見已對應到哪些內容
長提示詞現在不會再在路由步驟失敗
先前在使用語意路由時,長提示詞可能因為 embedding model 的短 context window 而失敗。
- 提示詞現在會在 embedding 前先截斷,預設為 2000 個字元,可透過
auto_router_max_input_chars針對每個部署調整。 - 截斷只會套用於路由步驟;防護欄與篩選器仍會看到完整提示詞
- 所有 no-match 與 route-failure 路徑現在都會解析為
default_model,而不是發生錯誤
以關鍵字為基礎的路由現在支援中文、日文和韓文字符
keyword_tier_rules 會依 regex 詞邊界比對,但 CJK 字元之間沒有詞邊界,因此針對 发票 的規則從未在 我需要开发票 內觸發。這些流量會默默流入複雜度評分。
- 含有 CJK 字元的關鍵字現在會以子字串方式比對
- 拉丁字元關鍵字仍維持詞邊界比對不變
試試看
資訊
完整參考請見 Auto Routing 文件頁面。