Published:
Tin LoAI Product Engineer, LiteLLM
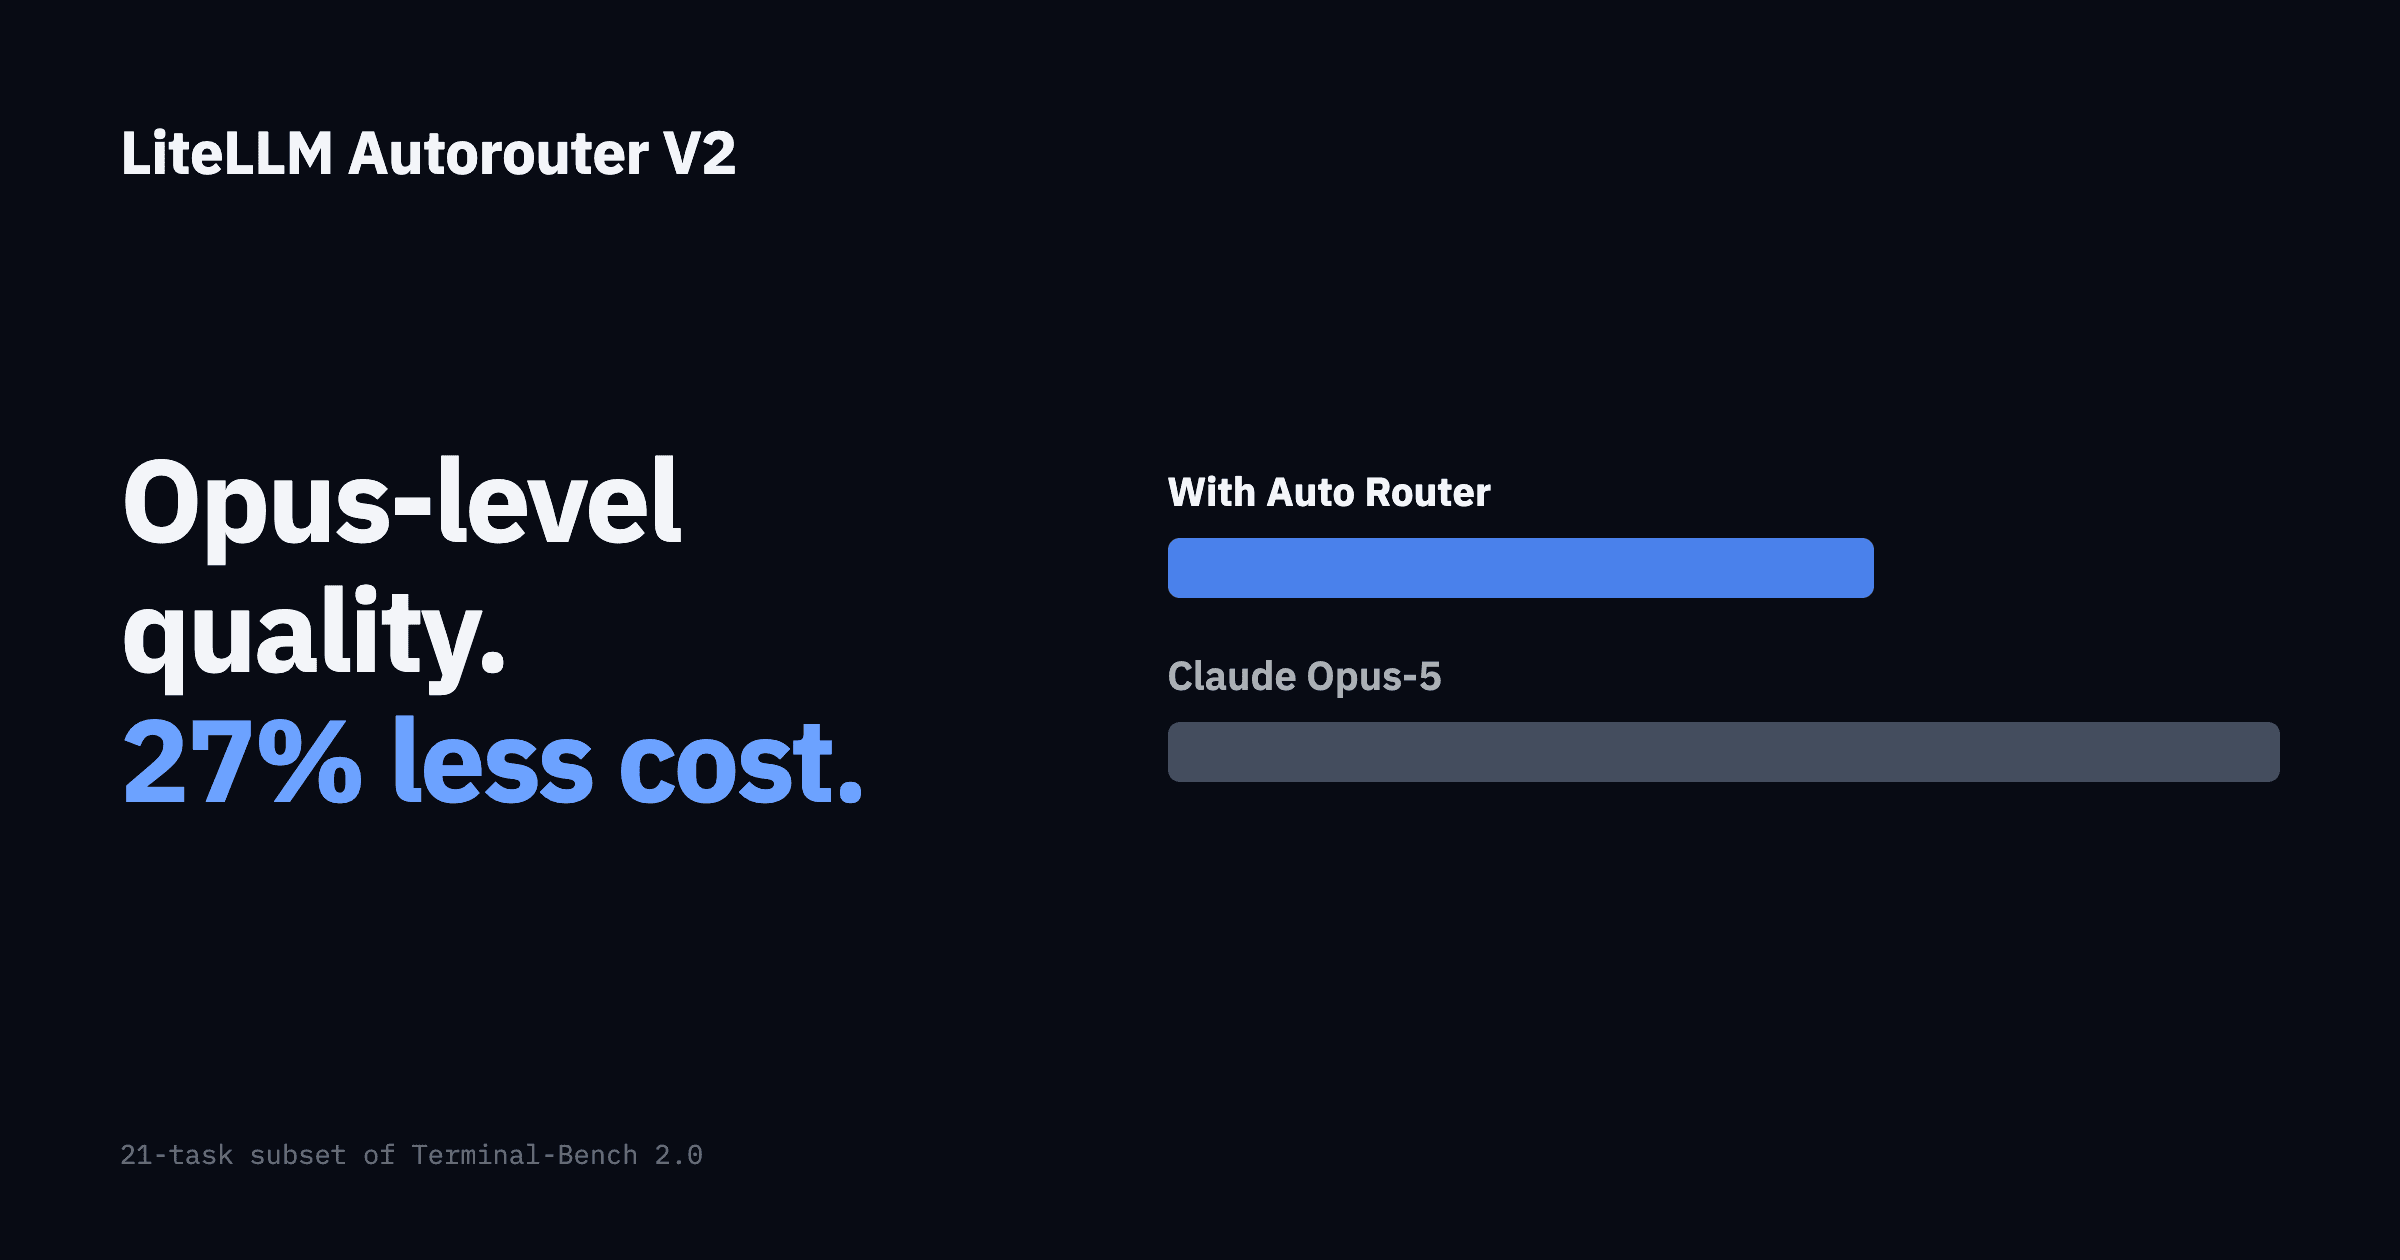
自動路由器在 Terminal-Bench 2.0 的 21 個任務子集上,以 27% 更低的成本達到與 Claude Opus-5 相同的解題率。 每個 arm 都執行相同的 21 個任務,因此比較是同類相較。
🚀 協助塑造 Auto-Router
主要發現
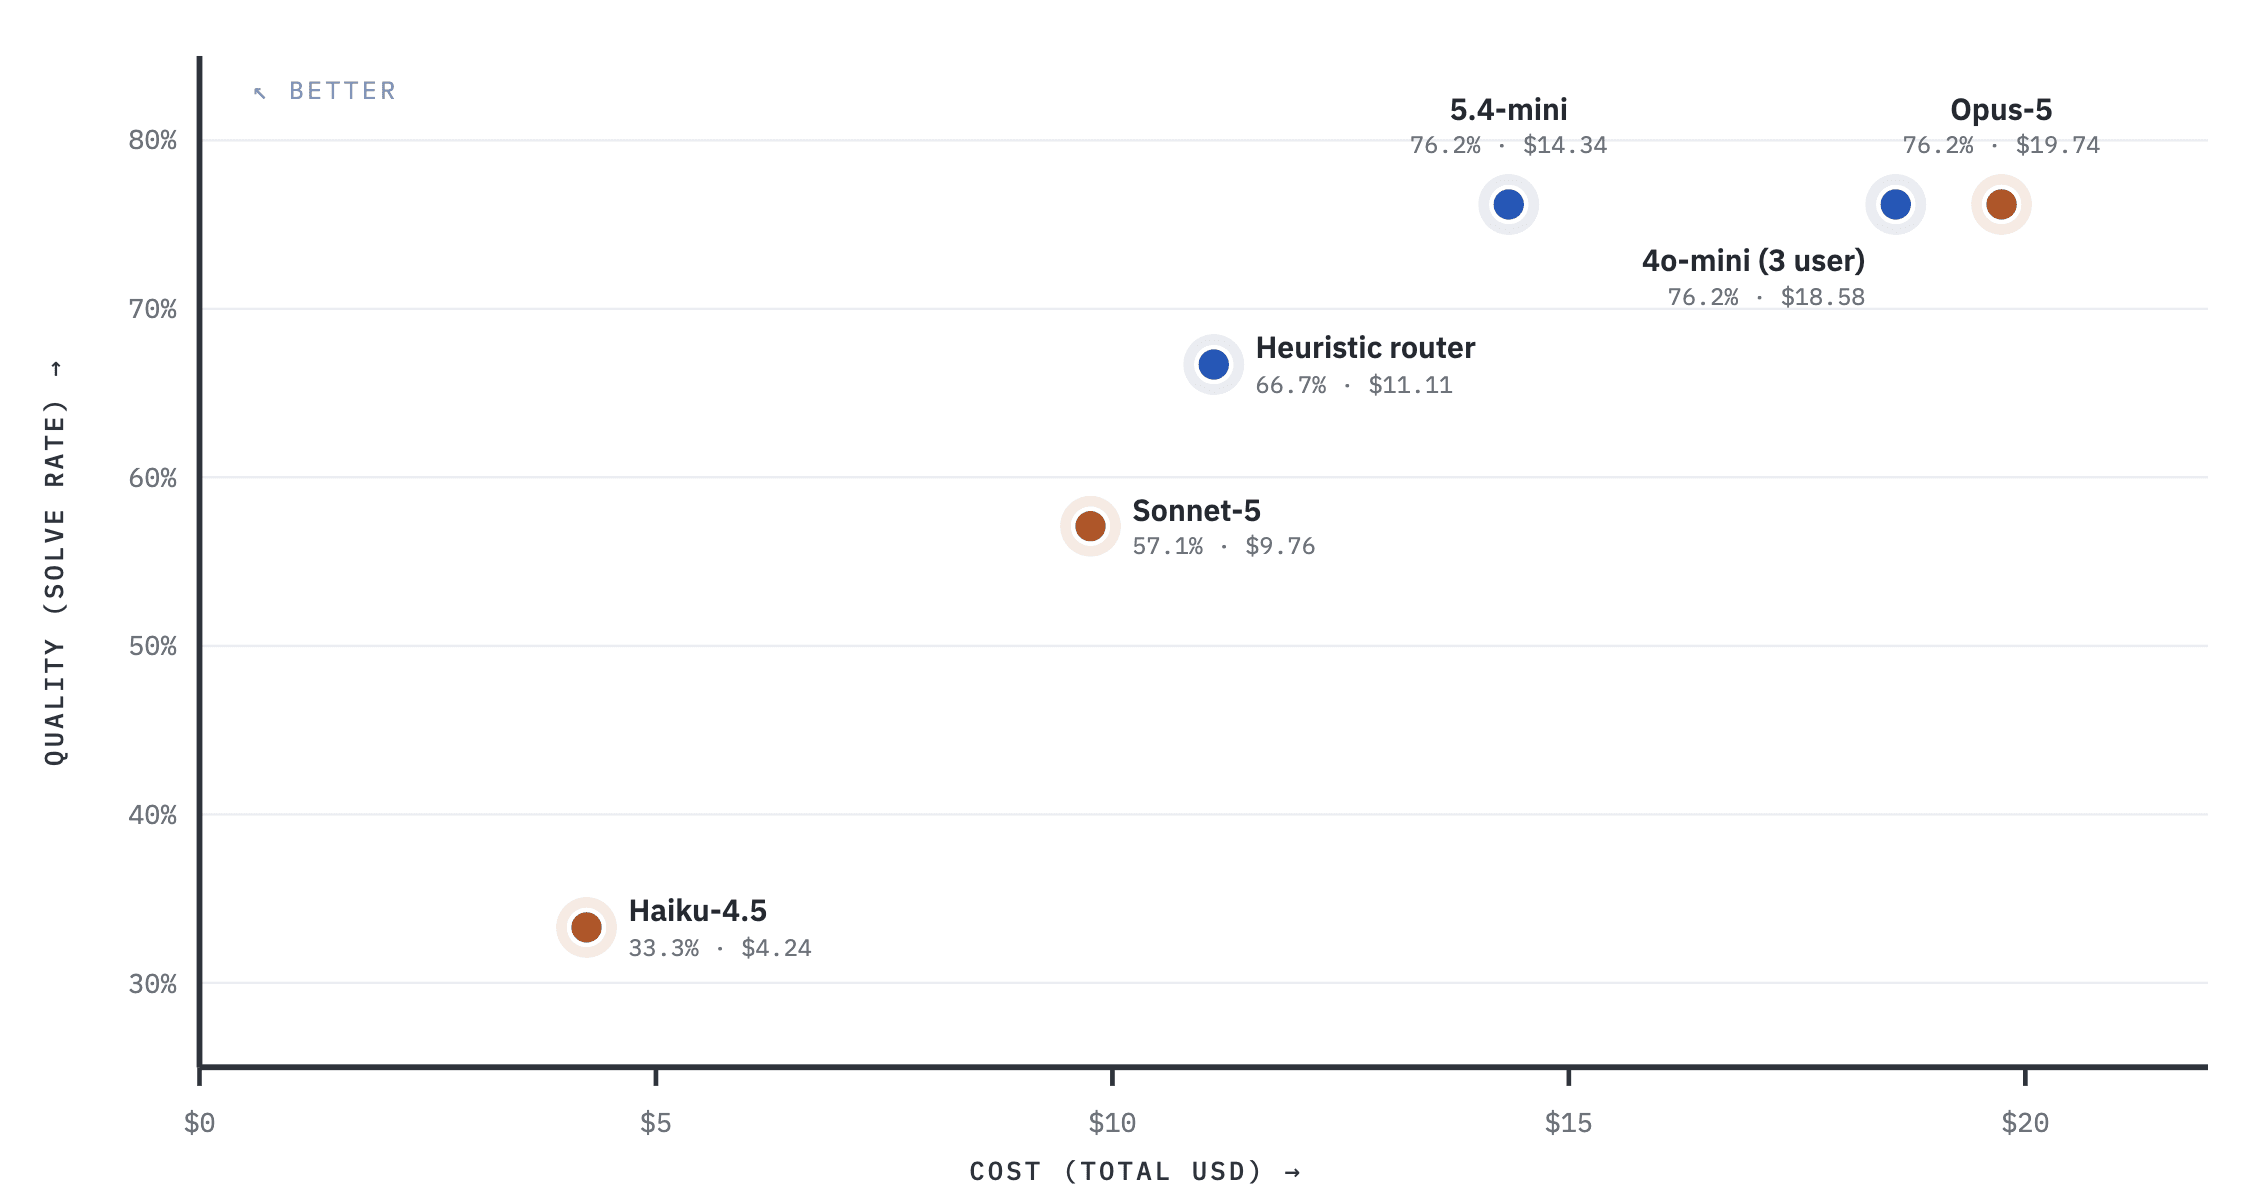
- 以 27% 更低成本達成 Opus 等級品質。 5.4-mini 分類器(單一訊息上下文)路由器解出 16/21 個任務,與 Opus-5 相同,成本為 $14.34,對比 $19.74
- 與其增加上下文視窗,不如考慮更好的模型 從 1 則訊息上下文提升到前 3 則使用者訊息,讓 4o-mini 路由器從 66.7% 提升到 76.2%,成本從 $12.86 增加到 $18.58:相對品質 +14%,成本 +44%。使用 1 則訊息上下文的 GPT 5.4-mini 分類器能以更低成本超越這些結果。
- 上下文會拖慢任務。 加入 3-6 則訊息作為上下文後,每個任務的中位數實際耗時從 6.8 分鐘變成 8.3 分鐘
- 加入助理回覆不值得。 包含 LLM 回覆的 6 則訊息視窗將相對品質降低 7%(66.7% 到 61.9%),並使成本增加 34%
- 啟發式路由器是高價值選項。 以 56% 的成本達到 Opus 品質的 87%,不需要分類器呼叫,且具備所有 arm 中最低的中位數實際耗時
結果
| 設定 | 解題率 | 解出數/總數 | 總成本 | 每解出一題成本 | 任務中位數實際耗時 | p95 turn | Haiku/Sonnet/Opus | 切換率 | 快取命中率 |
|---|---|---|---|---|---|---|---|---|---|
| 路由器:5.4-mini | 76.2% | 16/21 | $14.34 | $0.90 | 6.7 分鐘 | 62.8s | 20%/39%/40% | 54% | 78% |
| 路由器:4o-mini(3 則使用者) | 76.2% | 16/21 | $18.58 | $1.16 | 8.3 分鐘 | 67.9s | 18%/36%/45% | 55% | 78% |
| 僅 Opus-5 | 76.2% | 16/21 | $19.74 | $1.23 | 6.4 分鐘 | 94.6s | 0%/0%/99% | 4% | 89% |
| 路由器:啟發式 | 66.7% | 14/21 | $11.11 | $0.79 | 5.6 分鐘 | 43.3s | 32%/53%/14% | 48% | 83% |
| 路由器:4o-mini(1 則訊息) | 66.7% | 14/21 | $12.86 | $0.92 | 6.8 分鐘 | 53.1s | 33%/34%/34% | 58% | 79% |
| 路由器:4o-mini(6 則,使用者與助理) | 61.9% | 13/21 | $17.23 | $1.33 | 6.3 分鐘 | 112.3s | 5%/50%/44% | 46% | 80% |
| 僅 Sonnet-5 | 57.1% | 12/21 | $9.76 | $0.81 | 8.5 分鐘 | 60.5s | 0%/99%/0% | 1% | 93% |
| 僅 Haiku-4.5 | 33.3% | 7/21 | $4.24 | $0.61 | 4.9 分鐘 | 12.6s | 100%/0%/0% | 0% | 93% |
成本為全部 21 個任務的總計,且包含分類器呼叫;分類器呼叫的成本介於 $0.05 到 $0.34 之間,視分類器而定。
上下文視窗結果拆解
1-message 只將目前的使用者訊息傳送給分類器。3 user 會傳送前 3 則使用者訊息。6 both 會傳送包含助理回覆在內的前 6 則訊息。三者都使用相同的 4o-mini 分類器與相同的層級對應,因此唯一變數是分類器讀取的內容。沒有上下文的 5.4-mini 整體表現最佳。
| 上下文視窗 | 解題率 | 相對於 1 則訊息 | 總成本 | 相對於 1 則訊息 | 任務中位數實際耗時 |
|---|---|---|---|---|---|
| 1 則訊息 | 66.7% | 基準 | $12.86 | 基準 | 6.8 分鐘 |
| 前 3 則使用者訊息 | 76.2% | +14% | $18.58 | +44% | 8.3 分鐘 |
| 前 6 則訊息,使用者與助理 | 61.9% | -7% | $17.23 | +34% | 6.3 分鐘 |
先前的使用者回合會告訴分類器任務實際上是什麼,因此它會在需要 Opus 的回合升級到 Opus:Opus 的占比從 34% 升到 45%,而這正是大部分額外成本的來源。助理回覆會帶入工具輸出與長篇生成文字,這些內容看起來像複雜度訊號,卻沒有增加任務意圖;該 arm 幾乎沒有路由到 Haiku(5%),但表現仍是三者中最差。
如何衡量
- 基準測試: Terminal-Bench 2.0 的 21 個任務子集,由全部 8 個 arm 完成:adaptive-rejection-sampler、build-pmars、chess-best-move、cobol-modernization、crack-7z-hash、filter-js-from-html、gcode-to-text、install-windows-3.11、largest-eigenval、llm-inference-batching-scheduler、merge-diff-arc-agi-task、multi-source-data-merger、overfull-hbox、password-recovery、polyglot-c-py、prove-plus-comm、pypi-server、sparql-university、train-fasttext、winning-avg-corewars、write-compressor
- 路由器 arm: 一個模型群組,四個層級。SIMPLE 到
claude-haiku-4-5,MEDIUM 到claude-sonnet-5,COMPLEX 和 REASONING 到claude-opus-5。分類器不是啟發式就是 LLM(gpt-4o-mini、gpt-5.4-mini) - 基準 arm: 每個請求都送到同一個固定模型,且所有 arm 都開啟提示快取
- 成本: gateway 支出記錄中所有 21 個任務的 USD 總額,包含分類器呼叫
- 錯誤: 每個 arm 介於 0 到 4 個,來自 harness 與提供者失敗;僅在該任務對該 arm 未完成時,才從解題率分母中排除
設定
config.yaml
model_list:
  - model_name: claude-haiku-4-5
    litellm_params:
      model: anthropic/claude-haiku-4-5
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: claude-sonnet-5
    litellm_params:
      model: anthropic/claude-sonnet-5
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: claude-opus-5
    litellm_params:
      model: anthropic/claude-opus-5
      api_key: os.environ/ANTHROPIC_API_KEY

  - model_name: smart-router
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_config:
        tiers:
          SIMPLE:    claude-haiku-4-5
          MEDIUM:    claude-sonnet-5
          COMPLEX:   claude-opus-5
          REASONING: claude-opus-5
        classifier_type: llm
        classifier_llm_config:
          model: gpt-5.4-mini
        classifier_context_window_size: 0
      complexity_router_default_model: claude-sonnet-5
每個回應都會帶有 x-litellm-model-name 與 x-litellm-response-cost,每個路由器的成本與用量會顯示在 Auto-Router Benchmarks 分頁。完整參考請見 Auto Routing 文件頁面。
試用
資訊
將代理程式指向自動路由器,並在您自己的工作負載上將它與目前的單一模型比較。請在 discussion #32168 分享數據或問題。若要直接與我們一起進行這項工作,請 申請成為設計合作夥伴。