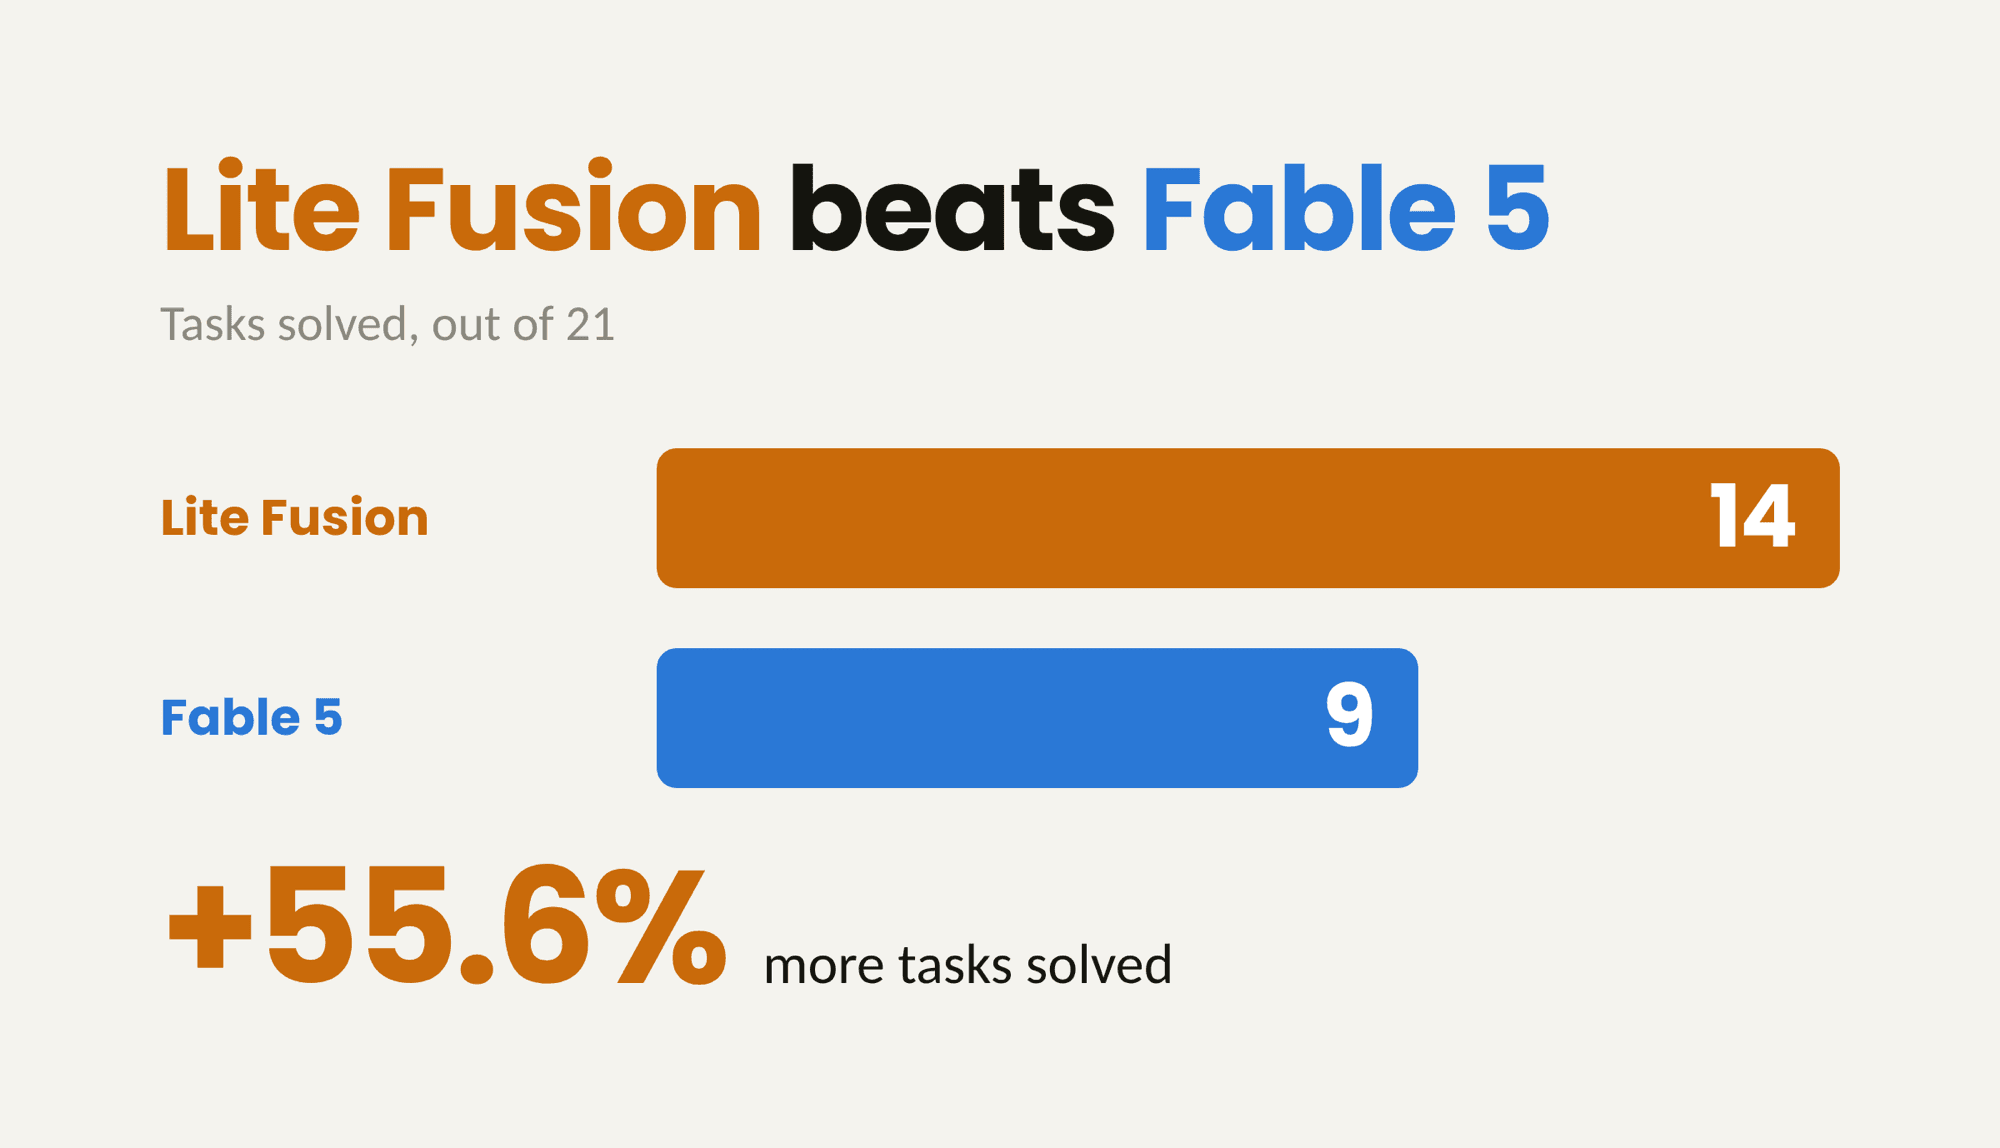
LiteLLM Auto Router Fusion 在 21 個 Terminal-Bench 任務中解決了 14 個;Claude Fable-5 單獨則解決了 9 個。 Fusion 會在多個模型上平行執行任務,並由其中一個模型將候選成果綜合成單一答案。兩個分支都執行了相同的 21 個任務。
主要發現
- Fusion 多解決了 5 個任務,14/21 對上 9/21,在這個子集上的解決率提升了 24 個百分點
- 總支出增加 36%($67.13 到 $91.64),同時 每個已解決任務的成本下降 12%($7.46 到 $6.55)
- 額外的模型很便宜;綜合步驟才不便宜。 Opus-5 和 Kimi-K3 合計占 Fusion 帳單的 $21.27。Fable-5 這一項本身就要 $70.37,比整個單模型分支還高
- 延遲才是真正的成本。 中位單輪時間從 6s 增加到 30s,p95 從 55s 增加到 237s,而每個任務的中位整體耗時則從 5 分鐘變成 8 分鐘
- Fusion 並非絕對更好。 它輸掉了一個單模型解決的任務,而且是因為逾時而非錯誤答案
結果
| 分支 | 解決率 | 已解決/n | 總成本 | $/已解決 | 中位單輪時間 | p95 單輪時間 | 任務中位整體耗時 | 代理程式輪次 |
|---|---|---|---|---|---|---|---|---|
| Fusion:Fable-5 + Opus-5 + Kimi-K3 | 66.7% | 14/21 | $91.64 | $6.55 | 30s | 237s | 8 分鐘 | 169 |
| 僅 Fable-5 | 42.9% | 9/21 | $67.13 | $7.46 | 6s | 55s | 5 分鐘 | 395 |
Fusion 需要少 57% 的代理程式輪次就能取得更多進展,因為綜合後的答案更接近正確,代理程式也花更少時間迭代。每一輪大約要多花 5 倍的整體時間,因此任務從頭到尾仍然更久。
額外任務從哪裡來
兩個分支都解決了 8 個任務。Fusion 額外拿下了單模型漏掉的 6 個:chess-best-move、crack-7z-hash、largest-eigenval、llm-inference-batching-scheduler、password-recovery 和 write-compressor。6 個任務兩邊都沒解決。唯一的回退,winning-avg-corewars,在 Fusion 下逾時。
| 任務 | Fable-5 | Fusion |
|---|---|---|
| adaptive-rejection-sampler | 失敗 | 失敗(逾時) |
| build-pmars | 已解決 | 已解決 |
| chess-best-move | 失敗(逾時) | 已解決 |
| cobol-modernization | 已解決 | 已解決 |
| crack-7z-hash | 失敗 | 已解決 |
| filter-js-from-html | 失敗 | 失敗 |
| gcode-to-text | 失敗(逾時) | 失敗(逾時) |
| install-windows-3.11 | 失敗 | 失敗 |
| largest-eigenval | 失敗 | 已解決 |
| llm-inference-batching-scheduler | 失敗(逾時) | 已解決 |
| merge-diff-arc-agi-task | 已解決 | 已解決 |
| multi-source-data-merger | 已解決 | 已解決 |
| overfull-hbox | 已解決 | 已解決 |
| password-recovery | 失敗 | 已解決 |
| polyglot-c-py | 失敗 | 失敗 |
| prove-plus-comm | 已解決 | 已解決 |
| pypi-server | 已解決 | 已解決 |
| sparql-university | 已解決 | 已解決 |
| train-fasttext | 失敗 | 失敗(逾時) |
| winning-avg-corewars | 已解決 | 失敗(逾時) |
| write-compressor | 失敗 | 已解決 |
Fusion 拿下的這 6 個任務,正是第二個意見會改變答案的類型:破解雜湊、找特徵值、寫壓縮器。不同模型會以不同方式處理這些問題,而綜合步驟可以選擇真正有效的攻擊路線,而不是一開始就押定單一路線。
錢花到哪裡去了
| 模型 | Fusion 分支支出 | 佔比 |
|---|---|---|
| claude-fable-5 | $70.37 | 76.8% |
| claude-opus-5 | $17.37 | 19.0% |
| kimi-k3 | $3.90 | 4.3% |
將 Opus-5 和 Kimi-K3 加入作為候選生成器,在 21 個任務上共花了 $21.27。Fable-5 這一項之所以超過整個單模型基準,是因為 Fable 同時在 169 次輪次中的 167 次負責生成候選與綜合。如果您想降低 Fusion 帳單,槓桿點在綜合器,而不是候選池的大小。
如何量測
- 基準: 與我們先前的 自動路由器基準 相同的 Terminal-Bench 2.0 21 任務子集
- 基準分支: 對
claude-fable-5的每個請求都使用高努力等級 - Fusion 分支:
claude-fable-5、claude-opus-5和kimi-k3各自以高努力等級產生候選工作;claude-fable-5綜合最終答案。綜合在 169 次輪次中的 167 次執行 - 成本: 來自 gateway 支出記錄、涵蓋所有候選呼叫與綜合呼叫的全部 21 個任務總美元支出
- 失敗: 代理程式逾時都算失敗。Fusion 分支出現 5 筆逾時紀錄,而基準分支為 3 筆,這與其較高的每輪延遲一致
- 提供者錯誤: 各模型群組的失敗列數分別為 Fable-5 7 筆、Opus-5 6 筆、Kimi-K3 4 筆,外加雙方各 2 筆分支層級失敗。Fusion 分支也記錄了 21 筆
content_filter紀錄,全部都發生在候選生成階段
每個分支在 21 個任務上跑一次,只能算是方向性結果,不能當成信賴區間。這表示 Fusion 值得在您自己的工作負載上量測;但它並不能建立 Terminal-Bench 整體的解決率,而且這些數字也不應與先前文章中的分支相比,因為前者使用了不同的配置。
何時該使用它
Fusion 以延遲和總支出換取完成的任務。當您付費是為了把任務完成時,這種取捨才成立;這涵蓋遷移、困難除錯、離線代理程式執行,以及評估框架。若在互動式請求後方使用,237s 的 p95 單輪時間會讓使用者直接感受到。若您已經在高努力等級下執行前沿模型,卻仍看到任務失敗,值得問的問題是:第二個與第三個候選是否能解決它們;而這個子集顯示,約四分之一的情況下答案是可以。
試試看
讓代理程式在同一任務上指向多個模型、綜合結果,並比較每美元完成的任務數與您目前的單一模型。請在 討論串 #32168 分享數字或問題。若要直接與我們一起做這件事,請 申請成為設計夥伴。
相關閱讀:在提示快取之上疊加自動路由 與 自動路由在生產環境中節省了什麼。