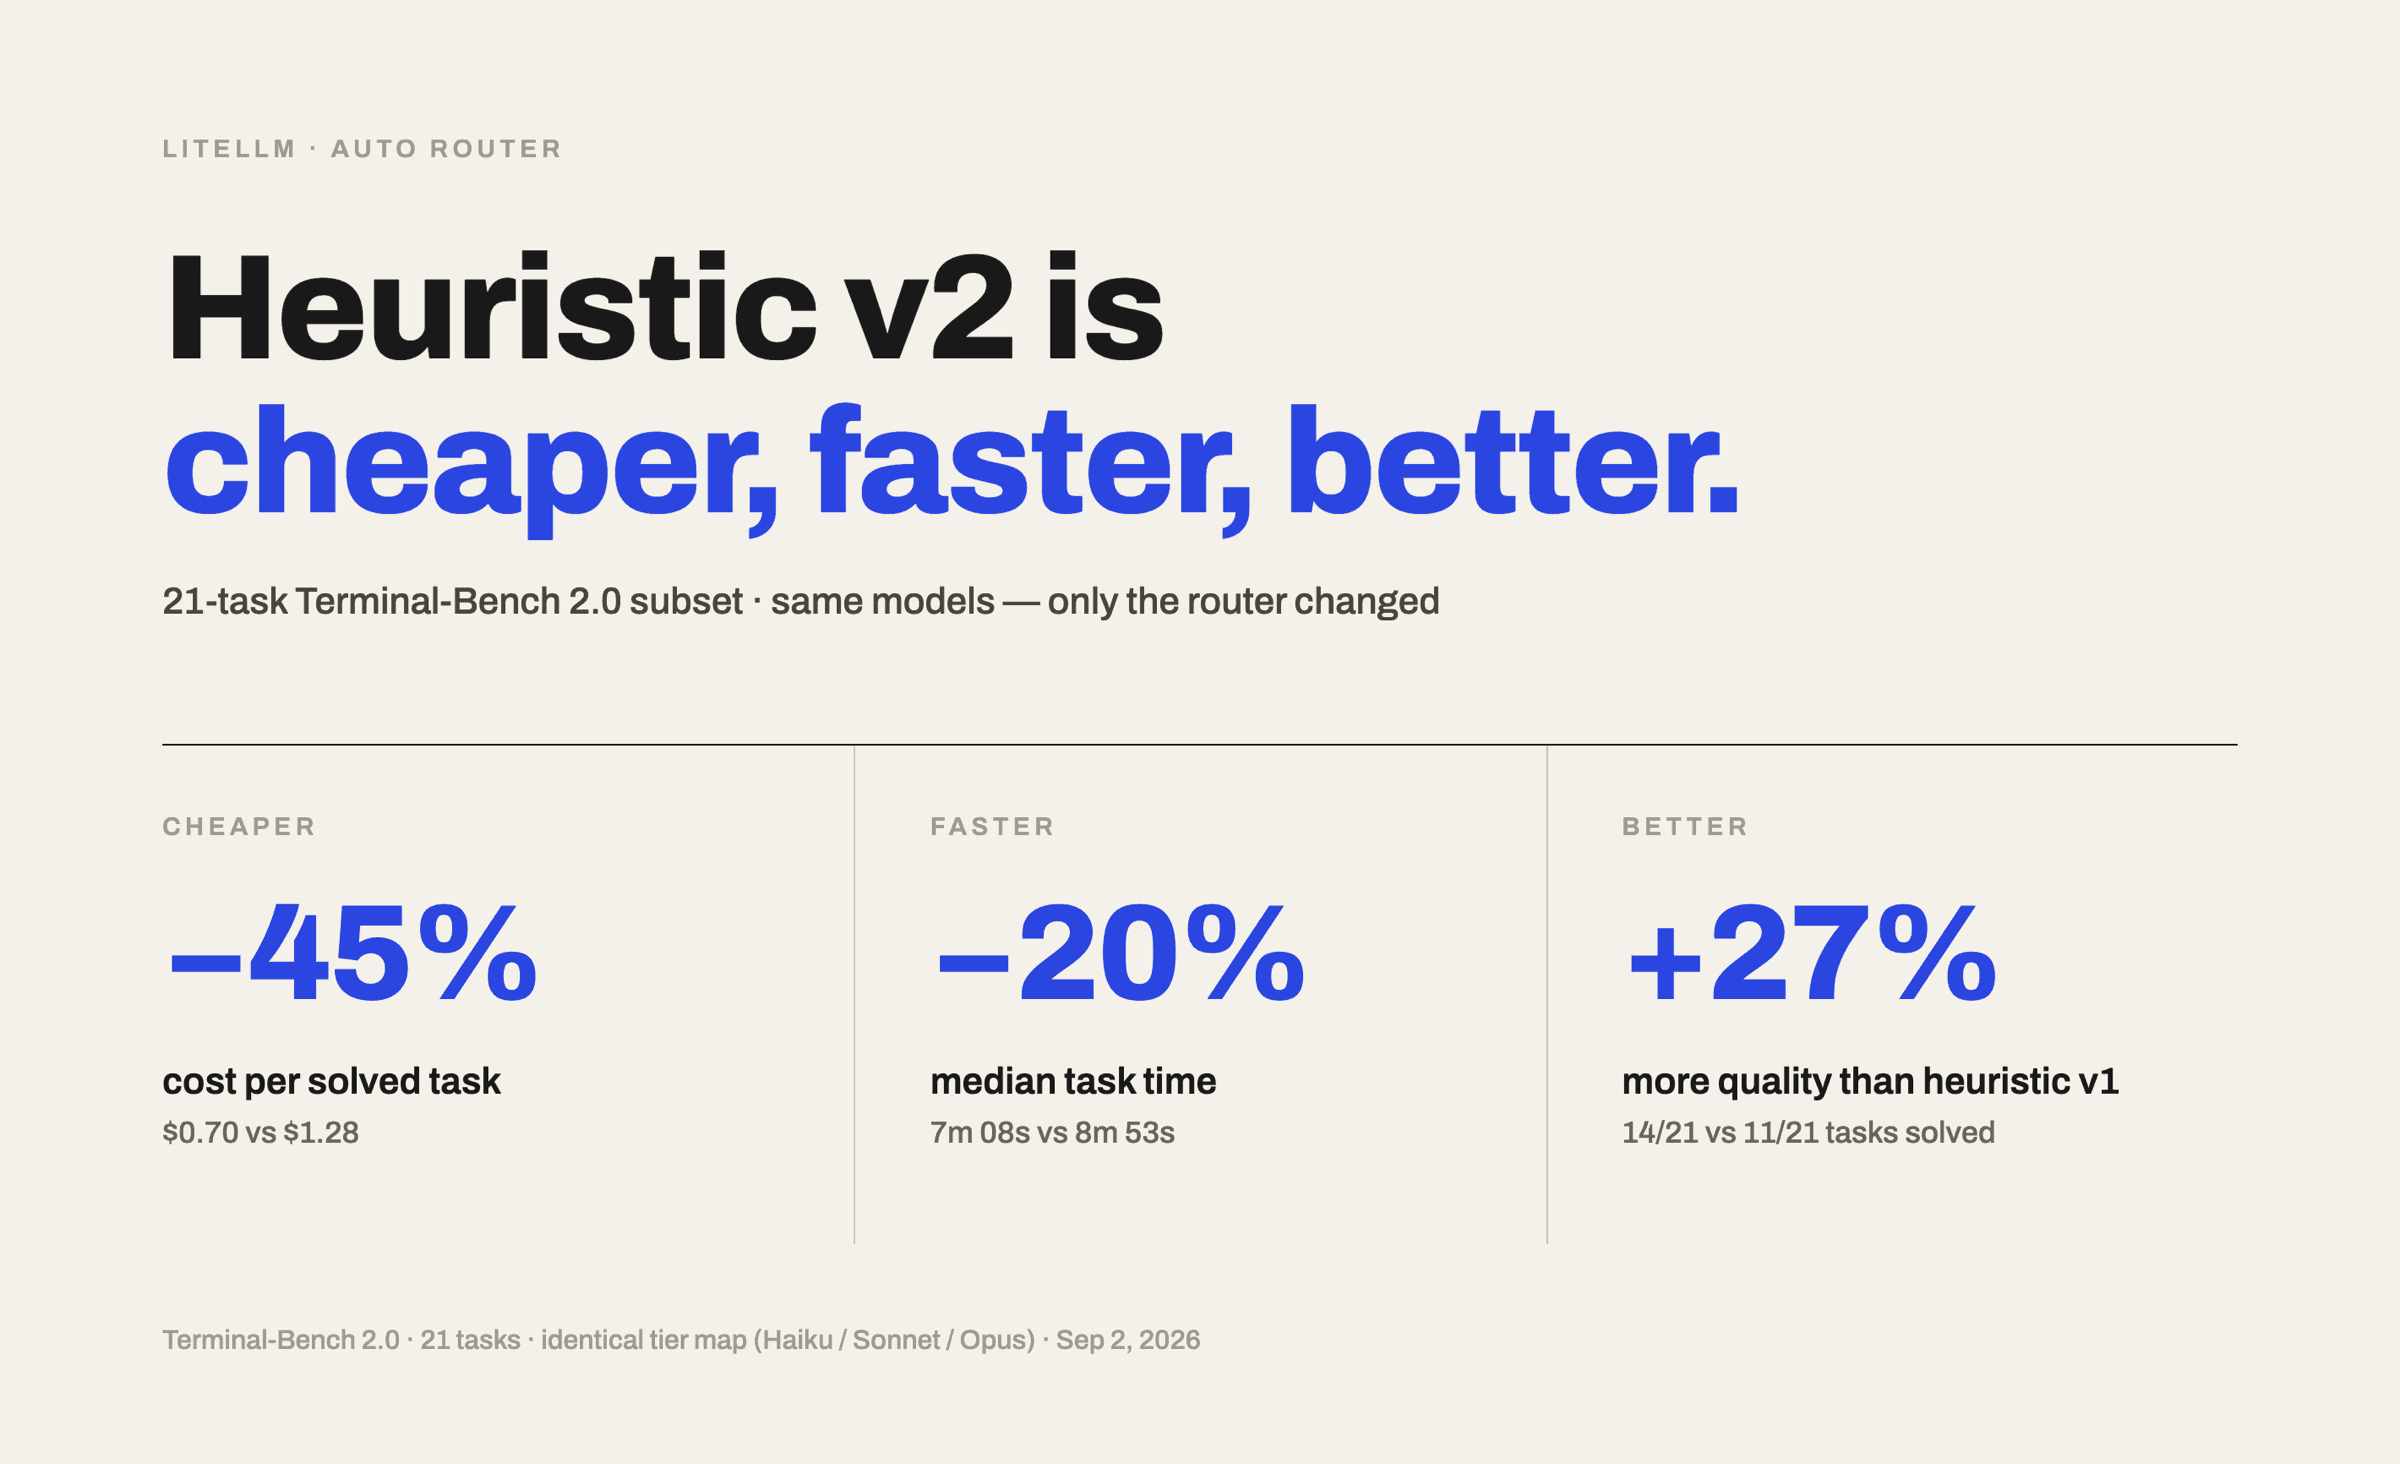
Heuristic v2,LiteLLM 的新 AutoRouter 分類器,效率最高可比 Heuristic v1 高 45%:以更低成本,在更短時間內解決更多任務。 只有分類器改變了。
主要發現
- 沒有冷啟動。 Heuristic v2 以多輪分級回應資料預先訓練,因此在看到您的第一個提示之前,就已經知道應該信任哪個層級
- 多解決 3 個任務。 14/21 對 11/21,在這個子集上的解決率提升 27%
- 每個已解決任務成本低 45%。 $0.70 對 $1.28,整個執行過程的總支出也低 30%($9.78 對 $14.06)
- 速度也更快。 平均 LLM 呼叫延遲下降 10%(13.1s 對 14.5s)、p90 下降 10%(30.7s 對 34.1s),任務完成中位時間也從 8m53s 降到 7m08s
- 更穩定的層級選擇代表更少的快取未命中。 87% 的輸入 token 是快取讀取,而 Heuristic v1 為 82%
- 同樣可靠。 兩個組別在 933 次合計 LLM 呼叫中皆無請求失敗
有哪些變更
Heuristic v1 會為提示詞的複雜度評分,並將分數對應到某個層級。Heuristic v2 則估計每個層級在該請求上成功的機率,並路由到能通過機率門檻的最便宜層級,而不是匹配難度分數的層級。
Prompt
  -> Detect request type and similarity cohort
  -> Estimate success probability for all four tiers
  -> Make probabilities monotonic
  -> Select the first tier with at least 75% predicted success
  -> Route to a model configured in that tier
機率估計結合了三個層次的證據:
- 整體層級表現: 該層級在所有請求上的表現
- 請求類型表現: 它在這類請求上的表現(程式碼、技術設計、分析推理、寫作、事實查詢或一般類型)
- 相似請求表現: 它在與這個請求最相似的請求上的表現
證據不足時,會回退到較廣泛的估計;樣本量足夠大時,則以其為準。較強的層級不應看起來比較弱的層級還沒能力,因此路由器會先把四個機率校正為單調遞增,然後選擇第一個通過門檻的層級:
raw:       [0.60, 0.72, 0.69, 0.91]
corrected: [0.60, 0.72, 0.72, 0.91]
           SIMPLE MEDIUM COMPLEX REASONING
與先前相同的四個抽象層級,SIMPLE、MEDIUM、COMPLEX、REASONING。您仍可決定每一層要放哪些模型。
預先訓練,零冷啟動
自適應路由之所以能取得優勢,是因為它會觀察您的流量:採樣自 Thompson 的層級池在學會哪個模型會贏之前,會先在錯誤的模型上輸掉幾輪。Heuristic v2 省略了這一步。它的成功機率表是在分類器正式發佈前,先以多輪分級回應資料校準完成,因此在看到您的第一個提示之前,就已經知道應該信任哪個層級,不需要在您的流量上進行暖機期。
結果
| 分類器 | 解決率 | 已解決/21 | 總成本 | $/已解決 | 平均呼叫延遲 | p90 呼叫延遲 | 任務中位時間 |
|---|---|---|---|---|---|---|---|
| Heuristic v2 | 66.7% | 14/21 | $9.78 | $0.70 | 13.1s | 30.7s | 7m08s |
| Heuristic v1 | 52.4% | 11/21 | $14.06 | $1.28 | 14.5s | 34.1s | 8m53s |
節省來自哪裡
| 分類器 | SIMPLE (Haiku) | MEDIUM (Sonnet) | COMPLEX (Opus) | REASONING (Opus, high effort) |
|---|---|---|---|---|
| Heuristic v2 | 45% ($1.61) | 55% ($8.17) | 0% | 0% |
| Heuristic v1 | 39% ($1.15) | 45% ($5.18) | 15% ($7.43) | 1% ($0.29) |
Heuristic v2 在這個基準上從未升級到 Opus。Heuristic v1 則將 16% 的輪次送往 Opus,而這些輪次佔了其總支出的 55%。這次執行中,這種升級沒有換來額外的解答:Heuristic v2 解決而 v1 漏掉的四個任務(adaptive-rejection-sampler、crack-7z-hash、install-windows-3.11、password-recovery)全都只靠 Haiku 和 Sonnet 就解決了。v1 其中一個任務還先送到 Opus,最後仍然失敗。
Heuristic v1 也更常在輪次之間切換層級,這使它損失了一些提示快取命中:其輸入 token 的 82% 是快取讀取,而 Heuristic v2 為 87%。
試用
model_list:
  - model_name: claude-haiku-4-5
    litellm_params:
      model: anthropic/claude-haiku-4-5
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: claude-sonnet-5
    litellm_params:
      model: anthropic/claude-sonnet-5
      api_key: os.environ/ANTHROPIC_API_KEY
  - model_name: claude-opus-5
    litellm_params:
      model: anthropic/claude-opus-5
      api_key: os.environ/ANTHROPIC_API_KEY

  - model_name: smart-router
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_config:
        tiers:
          SIMPLE:    claude-haiku-4-5
          MEDIUM:    claude-sonnet-5
          COMPLEX:   claude-opus-5
          REASONING: claude-opus-5
        classifier_type: heuristic_v2
      complexity_router_default_model: claude-sonnet-5
免費試用涵蓋一個 auto router 上的 Heuristic v2。如果您想在多於一個 auto router 上使用,請 申請成為設計夥伴,我們會直接與您處理。
Heuristic v2 在請求路徑上不會呼叫 LLM 分類器,並且重用與 Heuristic v1 或 LLM 分類器相同的層級設定。將 classifier_type 替換後,與您目前的設定比較。完整參考請見 Auto Routing 文件頁面。
量測方式
- 基準測試: Terminal-Bench 2.0 的 21 任務子集,兩個分類器透過同一個 LiteLLM proxy 並行執行,harbor 0.20.0 + terminus-2,
max_turns=50、-n 6每個組別各 1 次試驗,每個任務 1 次 trial - 層級: 兩個組別完全相同,SIMPLE 到
claude-haiku-4-5、MEDIUM 到claude-sonnet-5、COMPLEX 和 REASONING 到高 effort 的claude-opus-5。只有classifier_type不同 - 成本: 來自 gateway 支出記錄的 21 個任務總美元支出
- 延遲: 在 proxy 端量測每次 LLM 呼叫的延遲,Heuristic v1 為 437 次呼叫,Heuristic v2 為 496 次呼叫
- 注意事項: 每個組別在 21 個任務上各跑一次。Heuristic v1 在前兩次較早的執行中曾得到 12-13/21,而此處為 11/21,因此預期會有少數任務的執行間雜訊,3 個任務的差距屬於提示性而非定論性。整體執行的實際牆鐘時間中,Heuristic v2 較長(46m30s 對 37m55s,兩個組別各有 6 個任務並行執行),原因是尾端有長時間執行的任務以及
chess-best-move發生一次逾時;這是本次執行中最慢任務的特性,不是每次請求延遲回退,因此上方標題數字採用的是每次呼叫延遲與任務中位時間
相關閱讀
27% 更低成本達到 Opus 等級品質、LiteLLM Fusion:比 Fable 5 多解決 56% 的任務,以及在正式環境中自動路由節省了什麼。