達成次毫秒級 Proxy 額外負擔


簡介
我們第一季的效能目標,是在單一具備 4 顆 CPU 與 8 GB RAM 的執行個體上,積極朝次毫秒級 Proxy 額外負擔邁進,並持續擴大這個界線。我們更廣泛的目標,是讓 LiteLLM 具備低部署成本、輕量且快速的特性。本文說明支撐這項努力的架構方向。
Proxy 額外負擔指的是 LiteLLM 本身所引入的延遲,與上游提供者無關。
為了衡量它,我們以相同的 QPS(例如 1,000 QPS)直接對提供者與透過 LiteLLM 發出相同工作負載,並比較延遲差異。為了降低雜訊,負載產生器、LiteLLM 與模擬 LLM 端點都在同一台機器上執行,確保差異反映的是 Proxy 額外負擔,而不是網路延遲。
我們的起點
在 TensorZero 最初進行的相同基準測試下,LiteLLM 先前在大約 1,000 QPS 時會失敗。
如今已不再如此。現在,LiteLLM 可在不失敗的情況下承受 1,000 QPS 的壓力測試,並且在 4 顆 CPU、8 GB RAM 的單一執行個體設定下,能擴充到 5,000 QPS 而不失敗。
這建立了更近期的基準,也在我們持續改善 Proxy 額外負擔與整體效能時,提供了有用的背景。
設計選擇
要以 Python 為基礎的系統達成次毫秒級 Proxy 額外負擔,就必須有意識地決定工作發生的位置。
Python 非常適合彈性與可擴充性:提供者抽象、以設定驅動的路由,以及豐富的回呼生態系。這些領域中,開發速度與正確性比原始吞吐量更重要。
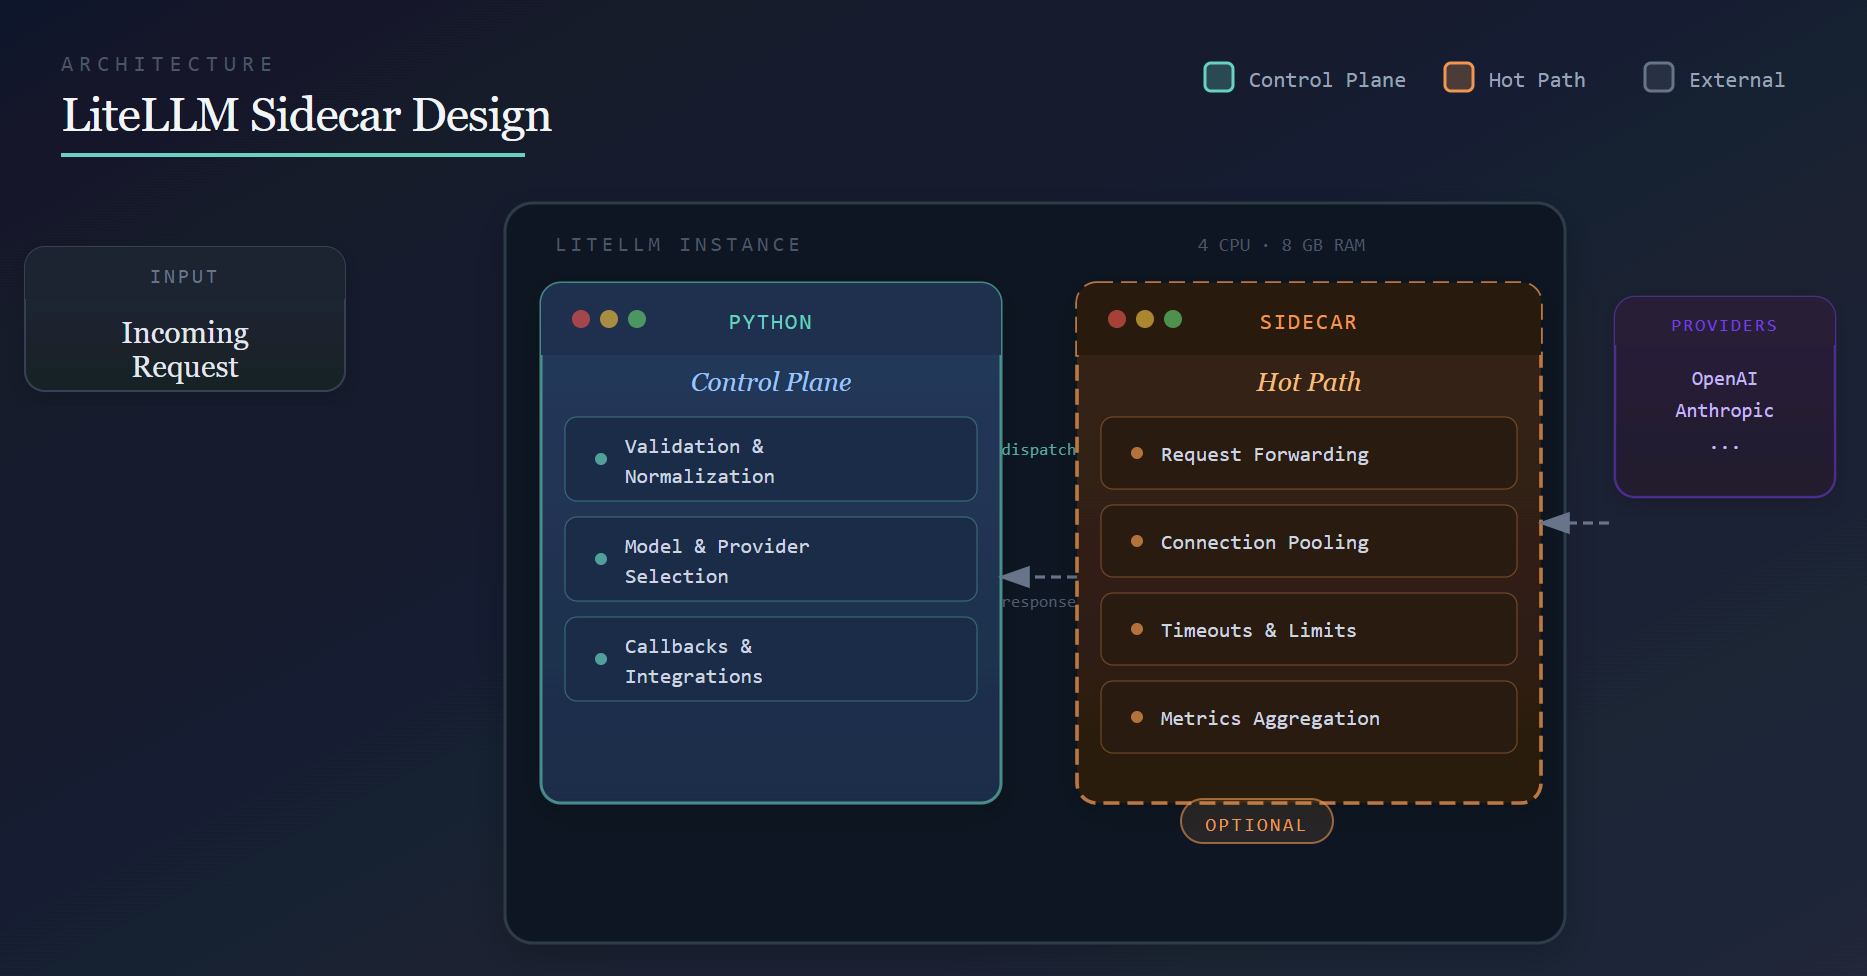
然而,在較高的請求速率下,某些類型的工作若在每個請求都於 Python 程序內執行,成本會變得很高。我們不是重寫 LiteLLM 或引入複雜的部署需求,而是採用可選的 sidecar 架構。
這項架構變更,就是我們打算讓 LiteLLM 永久快速 的方式。雖然它能支援我們的近期效能目標,但這是一項長期投資。
Python 仍然負責:
- 請求驗證與標準化
- 模型與提供者選擇
- 回呼與整合
sidecar 負責 效能關鍵執行,例如:
- 高效的請求轉送
- 連線重用與連線池
- 強制執行逾時與限制
- 彙總高頻指標
這種分工讓每個元件都專注於自己最擅長的部分:Python 作為控制平面,而 sidecar 處理熱路徑。
為什麼 sidecar 是可選的
sidecar 是刻意設計為 可選 的。
這讓我們能逐步推出它、在真實世界工作負載下驗證它,並避免在它尚未於所有 LiteLLM 功能上經過完整實戰驗證前,就將其設為硬性相依。
同樣重要的是,這確保自行託管 LiteLLM 仍然保持簡單。sidecar 會被打包並自動啟動,不需要額外基礎架構,也可以完全停用。從使用者的角度來看,LiteLLM 會持續像單一服務一樣運作。
截至目前,sidecar 是一項最佳化,而非必要條件。
結論
次毫秒級 Proxy 額外負擔不是靠單一最佳化達成的,而是透過架構變更。
透過讓 Python 專注於協調與可擴充性,並將效能關鍵的執行卸載到 sidecar,我們建立了一個基礎,使 LiteLLM 長期維持快速,即使在像 1 CPU、2 GB RAM 的執行個體這類較為平實的硬體上也是如此,同時保持部署與自架簡單。
這項工作將延續到第一季之後,我們會隨著架構演進持續分享基準測試與更新。