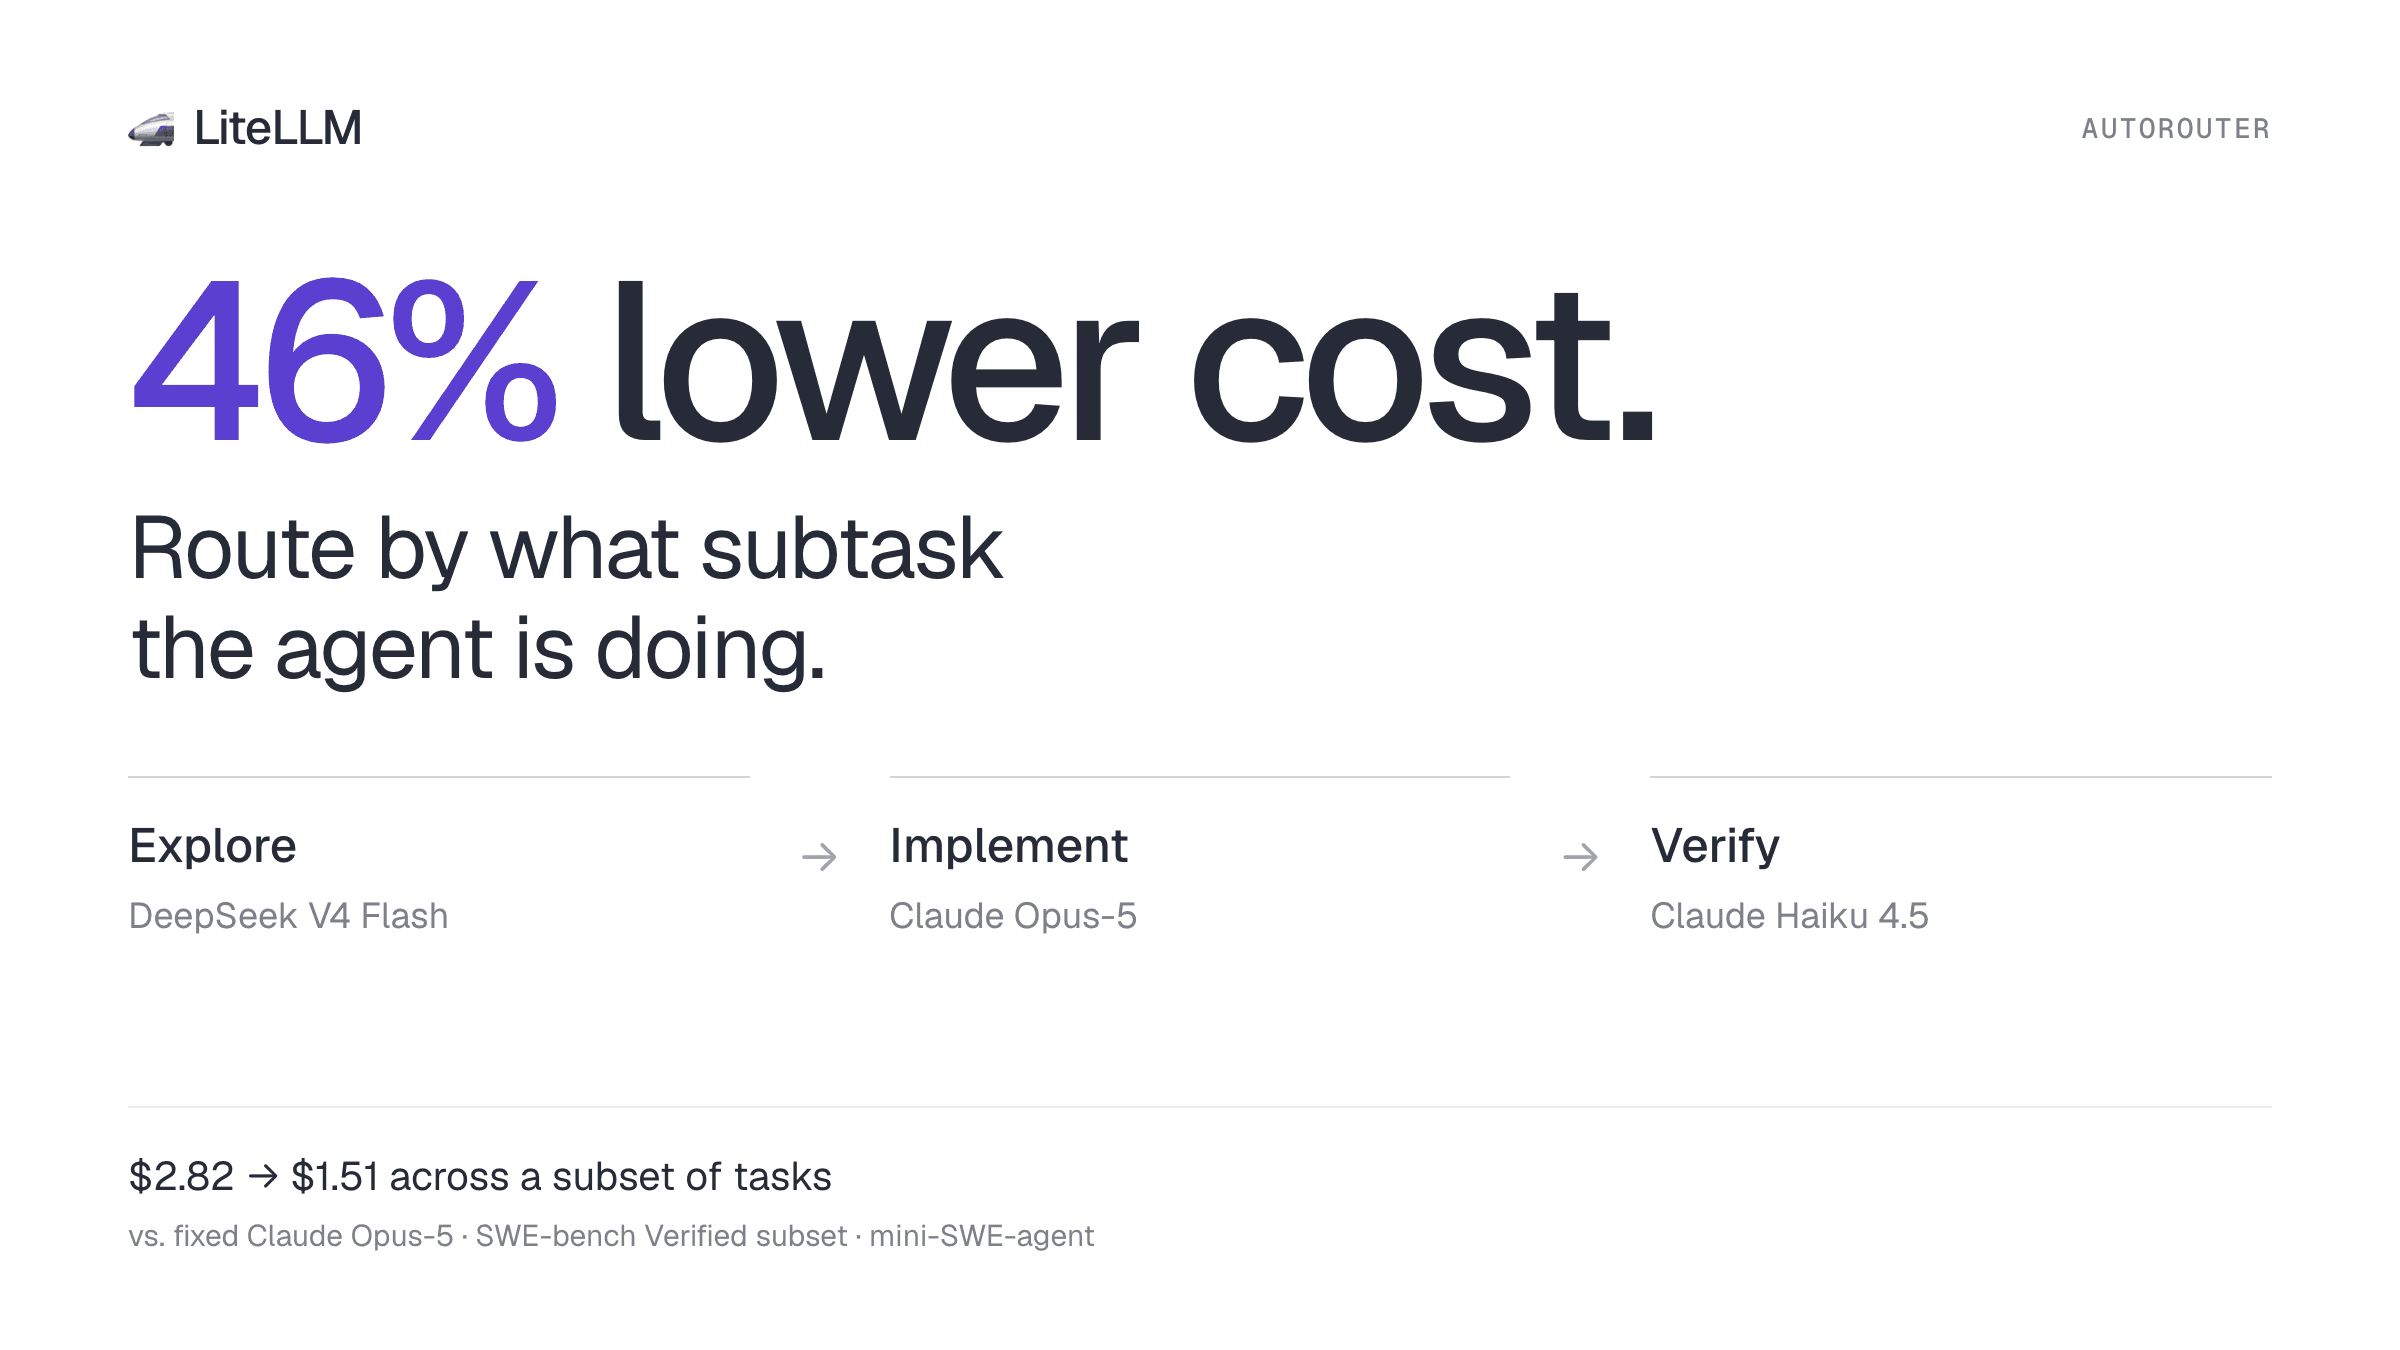
這個實驗性的路由器會依代理程式所處的階段為每個回合選擇模型,在 SWE-bench Verified 子集合上,以比固定 Claude Opus-5 低 46% 的成本,達到相同品質。
前沿模型很擅長 coding agent。它們也很昂貴,而代理程式在一次工作階段中做的大多數事情其實都不需要它。代理程式大部分回合都在讀取檔案、grep,以及執行測試。真正的編輯只佔其中一小部分,而困難的推理就藏在那裡。
這個實驗正是基於這個觀察。它不為整個工作階段選一個模型,而是查看代理程式此刻正在做什麼,並將每個回合路由到該階段應得的模型。
運作方式
代理程式送往閘道的每個請求都會帶上完整對話歷史,包括到目前為止做過的每一次工具呼叫。路由器會讀取該歷史,並將每個工具呼叫分類為以下三個階段之一:
- 探索:讀取與搜尋。
grep、find、cat、head、git diff、python -c這類檢查狀態的單行指令,或像Read、Glob、Grep這類專用工具 - 實作:變更檔案。
sed -i、重新導向與 heredoc、tee、patch、git apply、將內容寫入磁碟的 Python、mv/cp/rm,或像Edit、Write這類專用工具 - 驗證:執行程式碼。
pytest、tox、runtests.py、make test、unittest、針對即時服務的curl
工具名稱會以不區分大小寫的方式比對,而任何類 shell 工具(bash、shell、exec、terminal)都以相同方式處理,因此這個分類器可與 Claude Code、mini-SWE-agent,以及任何其他使用 OpenAI 或 Anthropic 工具呼叫的系統搭配運作。
單一呼叫會有雜訊。正在編輯中的代理程式可能會 cat 檔案來檢查成果。因此路由器不會對單次呼叫做出反應:它會將已分類的呼叫視為連續區段來遍歷,只有當新的階段連續出現兩次呼叫時,才會切換目前階段。結果是一個穩定的訊號,可判斷代理程式正處於哪個子任務,且每個請求的計算時間遠低於一毫秒,沒有額外的 LLM 呼叫,也沒有分類器成本。
接著,該階段會對應到一個層級,而每個層級都有自己的模型:
- model_name: subtask-type-router
  litellm_params:
    model: auto_router/complexity_router
    complexity_router_default_model: anthropic/claude-sonnet-5
    complexity_router_config:
      classifier_type: custom
      classifier_plugin: subtask_type_classifier.subtask_type_classifier
      classifier_fallback: default_model
      deployment_affinity: true
      tiers:
        SIMPLE:                          # explore
          - fireworks_ai/deepseek-v4-flash
        MEDIUM:                          # verify
          - anthropic/claude-haiku-4-5
        COMPLEX:                         # implement
          - model_name: anthropic/claude-opus-5
            litellm_params:
              reasoning_effort: high
探索會送往快速、便宜的模型。驗證階段中,模型主要只需要讀取測試記錄並決定下一步該怎麼做,則送往 Haiku。實作階段,也就是實際寫入變更的地方,則以高推理力度送往 Opus。工作階段的開頭,在任何工具呼叫建立出階段之前,會送往預設模型 Sonnet。
結果
我們在 12 個 SWE-bench Verified 任務上執行 mini-SWE-agent,一次對固定的 anthropic/claude-opus-5,一次對上方的路由器,並使用官方 SWE-bench 工具組評分兩者。成本是閘道回報的每次 LLM 呼叫總和。固定 Opus 只解決了 12 個中的 9 個,因此以下的一對一比較僅限於這 9 個,以求公平。
在兩種設定都成功解出的 9 個任務中:
| 固定 Opus | 子任務路由器 | |
|---|---|---|
| 已解決任務數 | 9 / 9 | 9 / 9 |
| LLM 總成本 | $2.82 | $1.51 |
| 每個已解決任務成本 | $0.31 | $0.17 |
| LLM 回合數 | 112 | 205 |
相同品質,節省 $1.31(46%)。路由器每個任務用了更多回合,因為探索模型比 Opus 更具漸進性,但每個回合都便宜得足以讓總成本仍約為一半。
在完整 12 任務執行的全部 382 回合中,路由器的花費分布如下:
| 模型 | 回合數 | 回合占比 | 成本 |
|---|---|---|---|
| deepseek-v4-flash(探索) | 277 | 73% | $0.14 |
| claude-haiku-4-5(驗證) | 38 | 10% | $0.34 |
| claude-sonnet-5(開頭) | 12 | 3% | $0.08 |
| claude-opus-5(實作) | 55 | 14% | $2.56 |
86% 的代理程式回合從未碰到 Opus。那 14% 會碰到的回合正是編輯,這恰好就是前沿模型應該負責的工作。值得特別看第一列:所有回合中有 73% 的總成本只有 $0.14。只要放到正確的模型上,探索幾乎是免費的。
為什麼是階段,而不是難度
大多數自動路由器會判斷一個提示有多難,然後送一個 LLM 分類器去回答。在代理程式迴圈中,這個問題幾乎總是會被回答為「很難」,因為提示是一個附帶工具的 coding 任務,而分類器每個回合都要花錢。
階段路由問的是另一個問題:代理程式現在正在做什麼?這個問題已經有一個便宜、可確定性的答案,存在於工具呼叫歷史中;而且和難度不同,它會在單一任務中多次變化。省錢的地方就在這裡。
這仍然是一個實驗。十二個任務只是小樣本,mini-SWE-agent 也是比大多數 production agent 更簡單的迴圈,而階段分類法只是第一版,對於工具詞彙與這些完全不像的代理程式,還需要調整。我們會在更多流量上持續測試,再下更確定的結論。