我們如何將長提示的首字回應時間縮短 94%
LiteLLM 一直在長對話中數算每一個 token,只為了回答一個是或否的路由問題。
移除這項不必要的工作後,在我們本機 44 萬 token 的基準測試中,首字回應時間中位數從 553 毫秒降到 35 毫秒:降低 94%。
LiteLLM 一直在長對話中數算每一個 token,只為了回答一個是或否的路由問題。
移除這項不必要的工作後,在我們本機 44 萬 token 的基準測試中,首字回應時間中位數從 553 毫秒降到 35 毫秒:降低 94%。
LiteLLM Auto Router 現在支援 Laya 和 Bespoke Nimble 作為自架分類器。在您的基礎架構上執行任一模型,以選擇由哪個 completion model 處理每個請求。您的應用程式仍會呼叫相同的 router endpoint。
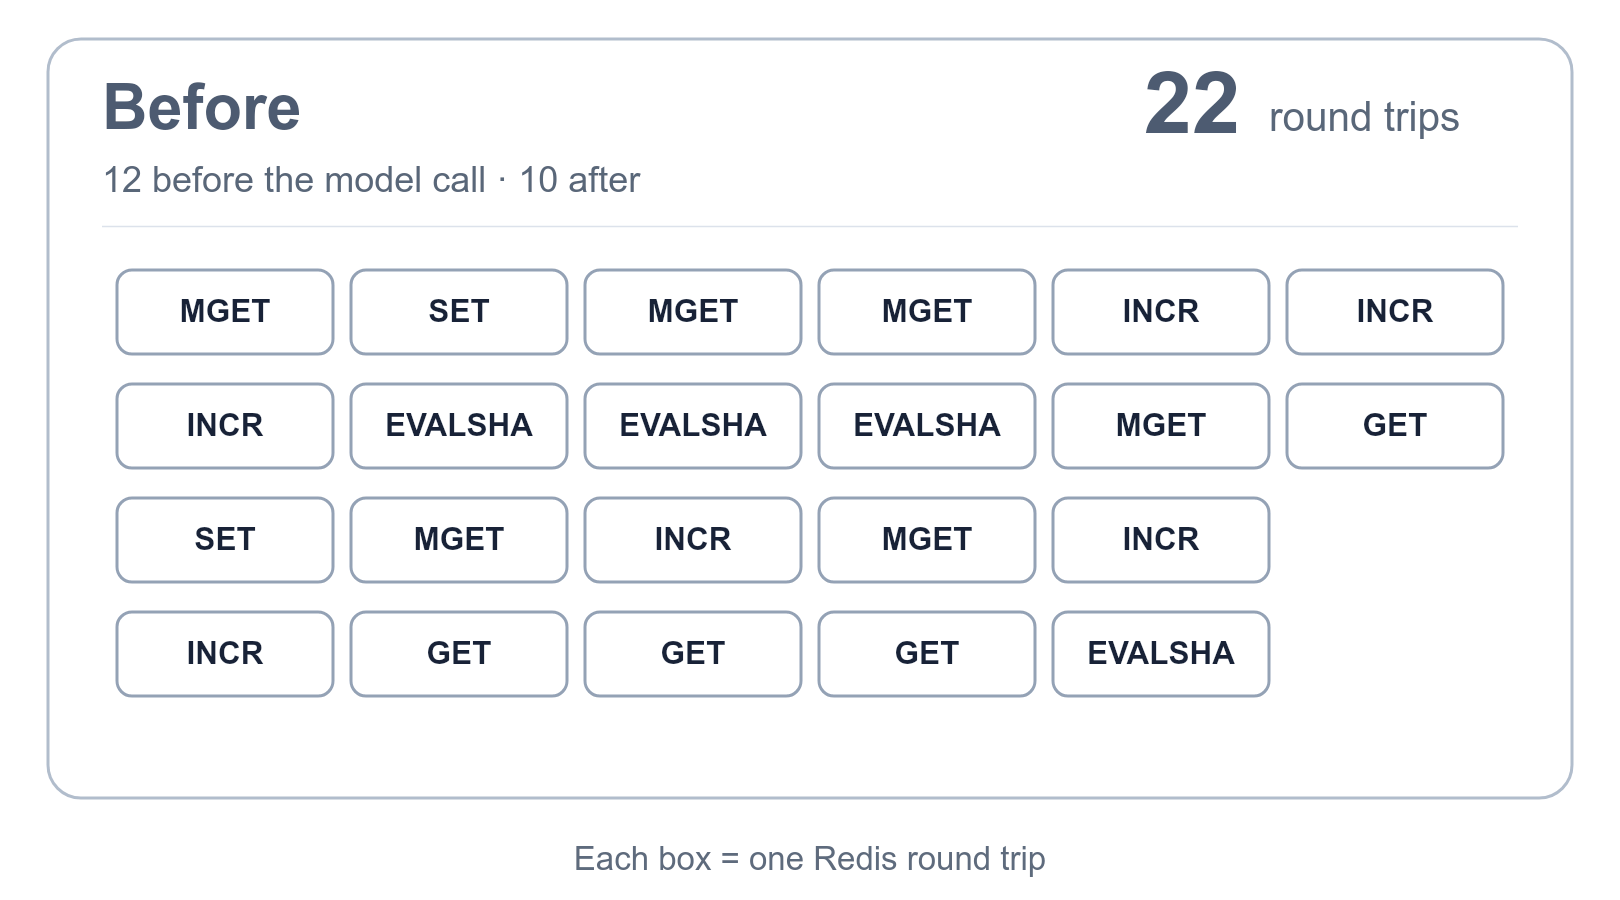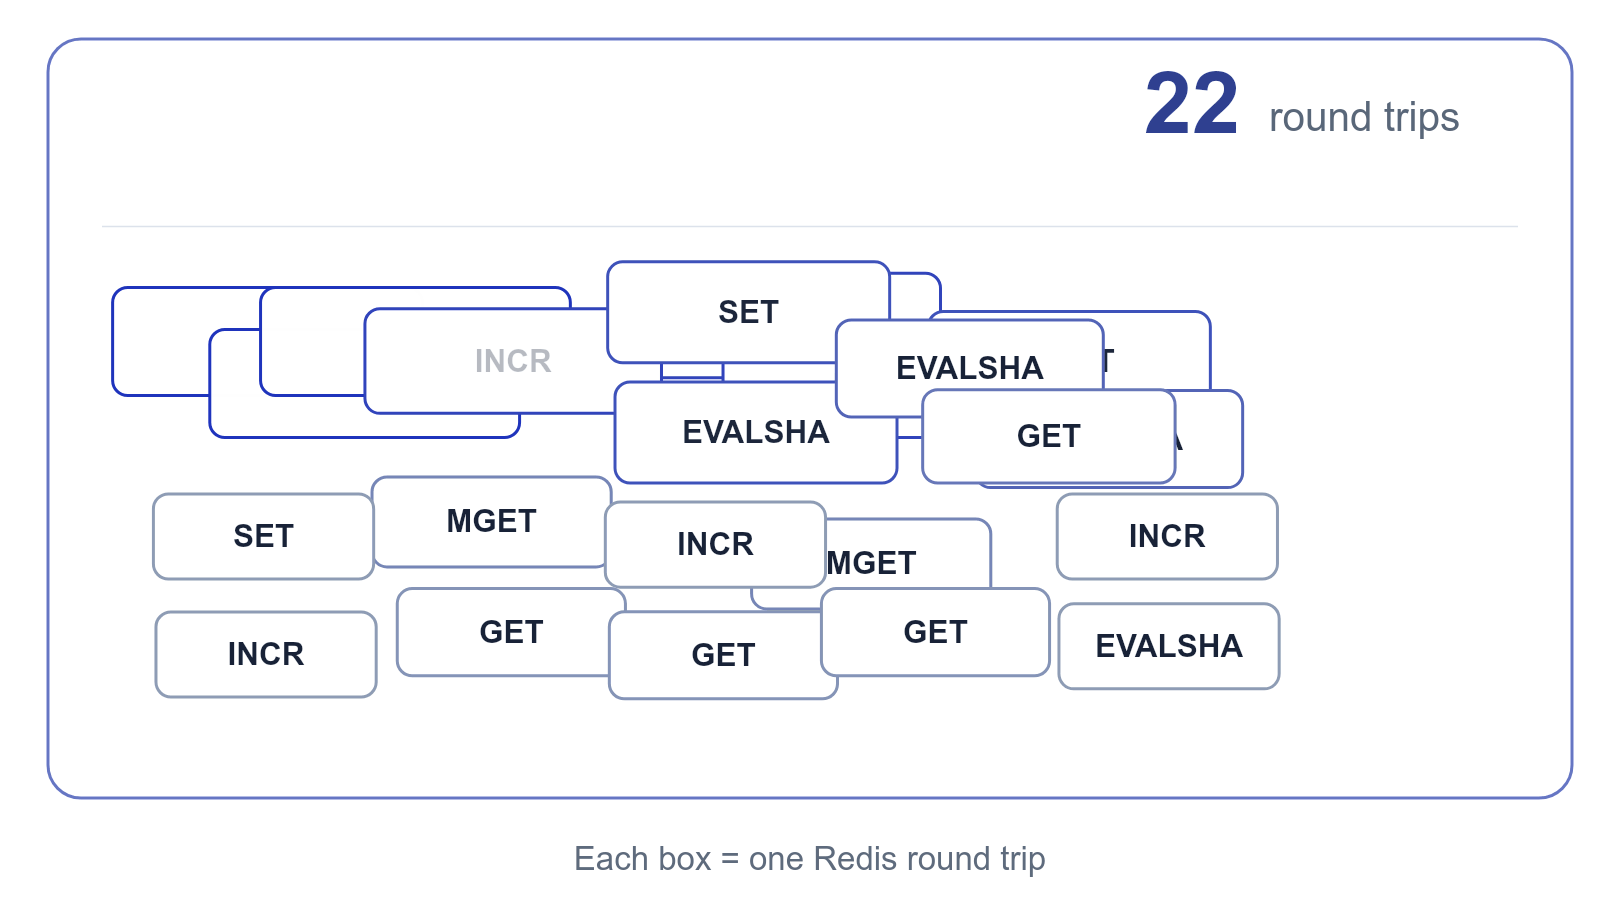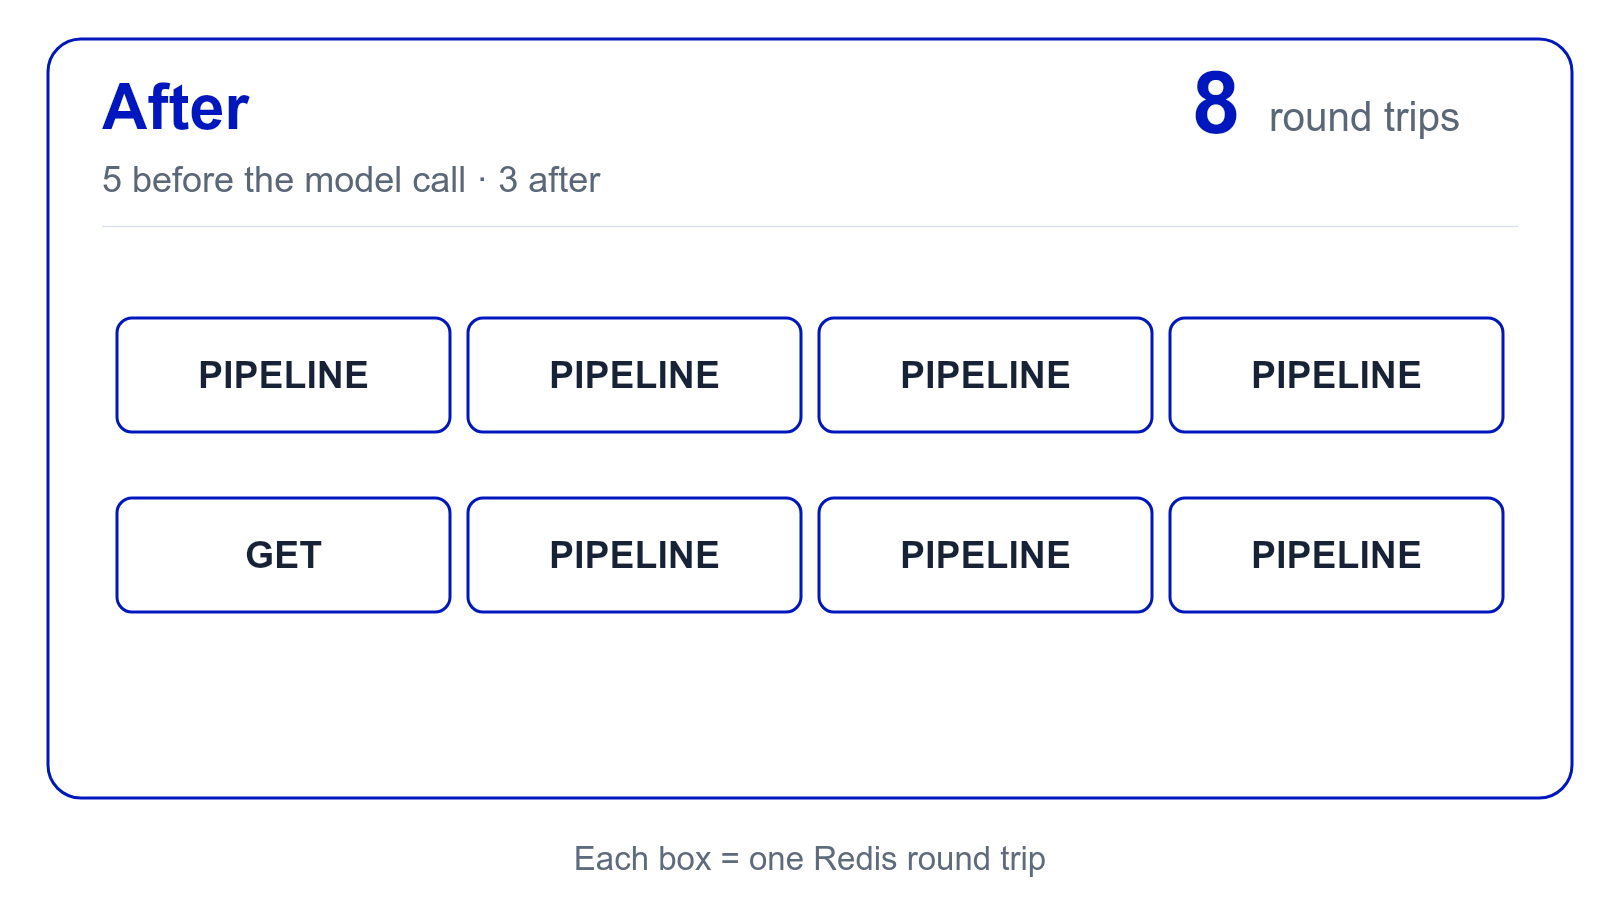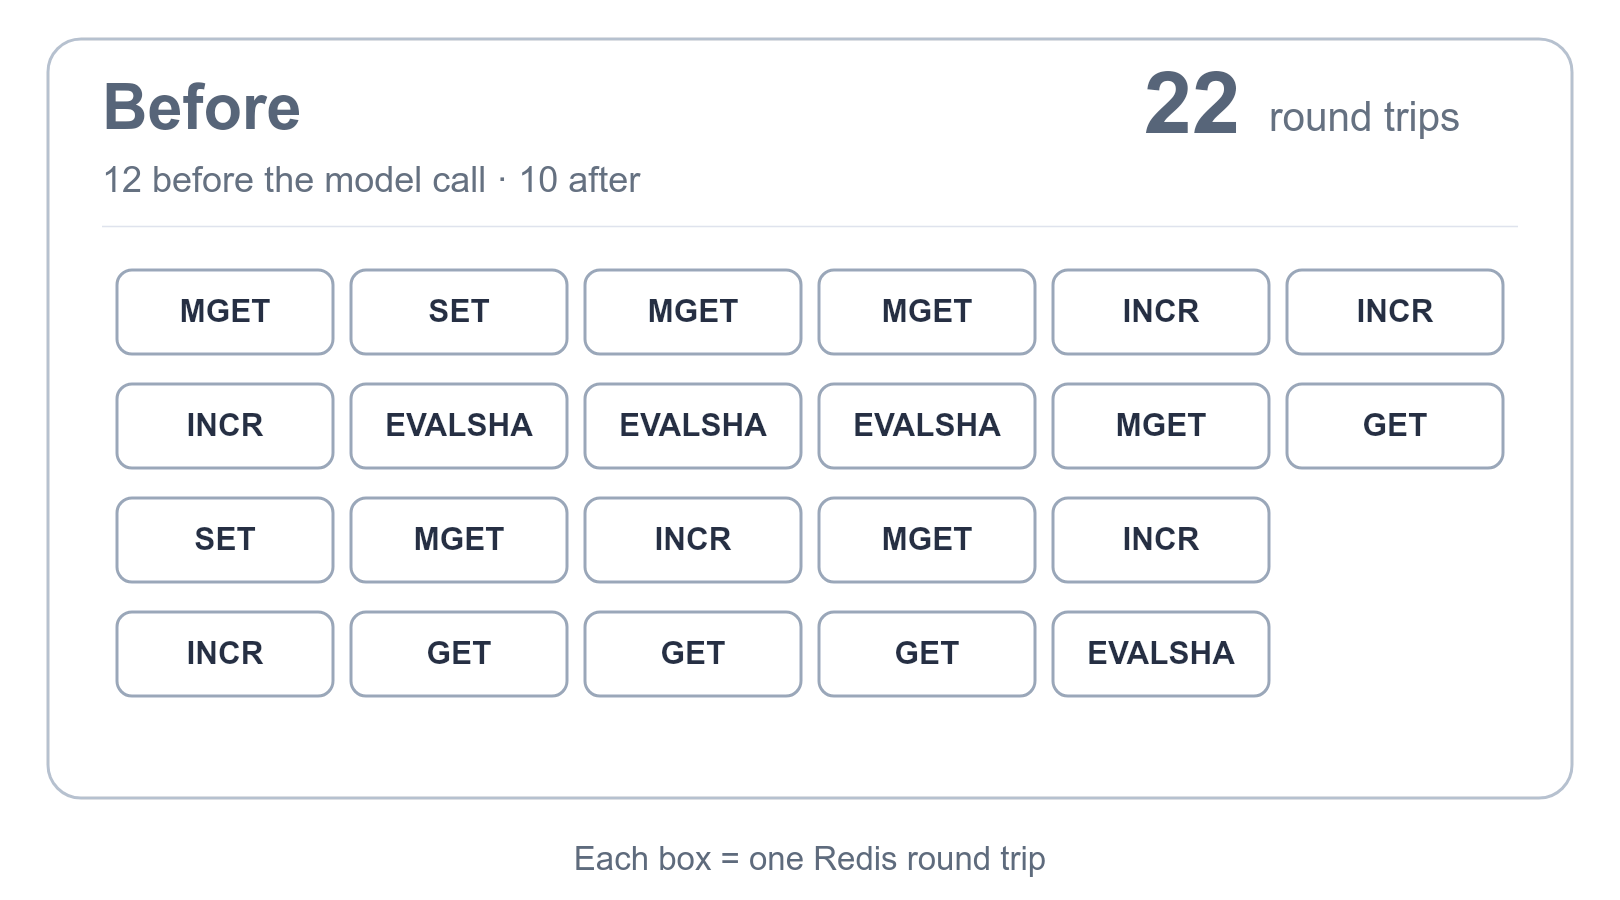
本週,我們將 LiteLLM proxy 上一個請求等待 Redis 的次數從 22 次降到 8 次。
一個來自具有預算之金鑰、位於具有預算與 TPM/RPM 限制之團隊、針對採用依使用量路由與 Redis 回應快取之模型群組的請求,原本會造成 22 次 Redis 往返:模型呼叫前 12 次、之後 10 次。相同的請求、相同的檢查與相同的寫入,現在只需 前 5 次、後 3 次。
本週,我們將 LiteLLM Usage 頁面大約加快了 120 倍。
在 5,000 個 API 金鑰的情況下,我們的 Usage 頁面顯示 30 天總計所花的時間超過六分鐘。我們重新設計了資料載入方式,並在我們的基準測試中將其縮短到3.2 秒。這大約是快了 120 倍。
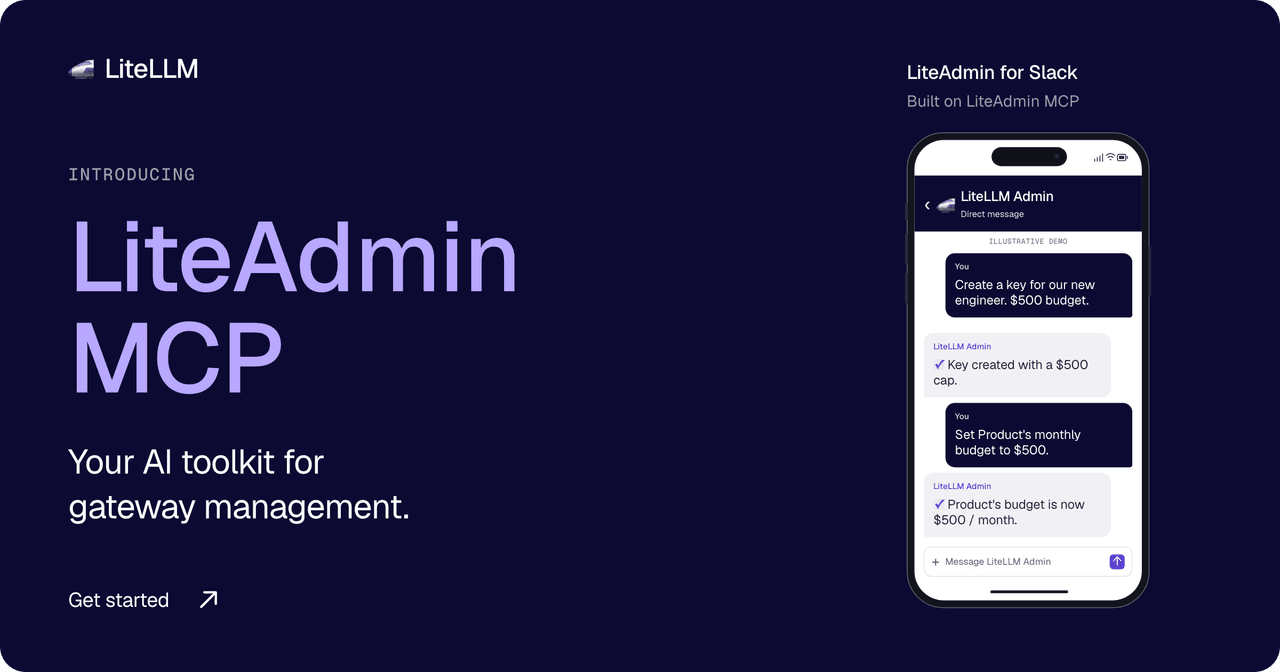
一位工程師為新專案索取一組 API 金鑰。您需要為它選擇模型、設定預算,並將其指派給某個團隊。隨著使用量成長,您需要檢查支出並調整那些限制。
LiteAdmin MCP 讓您的代理程式透過閘道的管理 API 處理這些工作。將它連接到一個 MCP 用戶端或自訂代理程式。我們也用同一個連接器建立了 LiteAdmin——我們的 Slack 管理代理程式。
最後更新:2026 年 10 月 6 日
Anthropic 正將 Claude Code 自動模式的安全分類器從用戶端移至 Claude API。自 2026 年 9 月 19 日發布的 Claude Code v2.1.278 起,Enterprise 方案與 Claude API 帳戶中的工作階段會要求伺服器在各自的模型請求中執行這些檢查,而 Anthropic 不會對伺服器執行的檢查收費。Anthropic 告訴我們,這項推行自 9 月 18 日開始且採漸進式推出,先從 Claude Code CLI 與 VS Code 擴充功能開始,接著在隔週於桌面應用程式與網頁版 Claude Code 推出,並且在 9 月 25 日時,自動模式會成為 Claude Code 的預設權限模式。如今,內建預設值在 Pro、Max 與 Team 方案上為 auto,在 Enterprise 方案與 Claude API 金鑰上為 Manual;依 Anthropic 的 權限模式參考,這些帳戶通常位於閘道之後。
伺服器端自動模式依賴 Claude Code 與 API 之間的一項契約,而有些閘道並未保留這項契約,LiteLLM 也包含在內。此修正最早於 9 月 22 日星期二的開發版釋出中推出,現在已包含在 v1.104.0 穩定版以及較早版本線的修補版中。這篇文章說明 Claude Code 對 AI 閘道的需求、LiteLLM 原本做錯了什麼、有哪些變更、哪些版本包含這項修正,以及如何確認您的部署已就緒。
最後更新:2026 年 9 月 18 日
Auto Router 在選定的模型能回應之前,必須先為分類付費。在我們的基準測試中,TypeSafe JEV 分類請求的速度比 Haiku 快 5.43 倍,比較的是分類器中位延遲:126.81 ms 對 688.40 ms。依登錄表定價的分類器成本低 96.12%,在標題中四捨五入為 96%
JEV 與我們基準測試中預期的層級相符率為 95.00%,Haiku 則為 73.75%。此結果取決於此處使用的提示、層級定義、指示與上下文。預期層級是以合成提示撰寫,未經獨立審查。此比較不代表一般分類準確度,亦不代表最終答案的品質

最後更新:2026 年 7 月
我們正在推出 LiteLLM AI Gateway 的 Rust 早期 beta 版,並建立了 AIGatewayBench 來將其與 Portkey、Bifrost 以及目前的 LiteLLM Python proxy 進行比較。四者之中,LiteLLM Rust 閘道具有最低的 p99 額外延遲與明顯最小的記憶體占用:相較於下一個最接近的閘道(Bifrost),額外負擔大約低 7x、記憶體少 9x,且具有最低的成本占用,以及對 coding agents 而言最快的整體工作階段時間。它在原始持續吞吐量上表現不遜色,並在額外負擔、記憶體與成本方面明顯領先。
最後更新:2026 年 6 月
在過去一年中,我們從使用者與社群聽到同樣的聲音:他們想要能執行的最快、最輕量的 AI 閘道。我們聽到了。現在我們正透過將 LiteLLM 遷移到 Rust 來回應,並承諾將額外負擔降到低於 1ms、記憶體低於 100MB 的可部署二進位檔。到了這次遷移完成時,您將擁有一個純 Rust 伺服器,能承載您 100% 的 AI 流量,且每個熱路徑操作(包含驗證與速率限制)都在 Rust 中執行。
我們正在開放早期 beta,並希望直接與重視快速、輕量閘道的團隊合作。如果您正是這樣,請在此註冊,我們會讓您在自己的堆疊中測試 Rust 閘道,並直接與我們團隊聯繫。
之所以重要,是因為在真實負載下,CPU 與記憶體會隨著並行度上升,而 pods 會在最糟糕的時候被 OOM-kill。今天 LiteLLM Python proxy 在負載下的記憶體峰值約為 359MB,而這個成本會隨著您執行的每個 pod、區域與重試而倍增。
我們已經在基準測試中看到成效。Rust 閘道的吞吐量約為 15x(每秒 453 到 6,782 個請求),使用的記憶體約少 11x(359MB 到 32MB),且將每次請求的額外負擔從 Python 路徑上的約 7.5ms 降到約 0.05ms,遠低於我們承諾的 1ms。
您部署單一 Rust 二進位檔。它使用約 65MB 的記憶體,閘道額外負擔維持在 1ms 以下,而您的設定中沒有任何東西會改變:相同的 config.yaml、相同的資料庫、相同的用戶端 API、相同的提供者。您保留 LiteLLM 對 100+ 個 LLM 提供者的涵蓋,並透過一個 OpenAI 相容 API 提供,包含 /chat/completions、/messages、/responses,以及 LiteLLM 今天支援的其他每個 LLM 端點,如今成為您能自行主機部署的最快、最輕量 LLM 閘道。
這不是 v2,也不是重寫。沒有新的主要版本需要遷移,也沒有任何東西要您更改。熱路徑下的執行階段會變得更快、更輕量,而您的設定會維持完全不變。
我們會以謹慎的方式發布。每條路由只有在通過我們完整的對等與端到端測試套件後才會移到 Rust,且會先在正式環境執行,然後下一條路由才開始。穩定性是優先事項,我們以每次發佈零回歸為目標。

最後更新:2026 年 6 月
代理程式基礎架構已經開始分成三層:模型、harnesses,以及 runtime。我們認為第四層即將出現:統一的代理程式控制平面。這將能從一個地方呼叫存在於不同代理程式 runtime 中的代理程式。
Harness 是提供者鎖定的下一個前沿。LiteLLM 的設計初衷是讓模型提供者之間能夠輕鬆切換。然而,隨著模型越來越飽和,下一個競爭領域就會變成 harness 與受管理的代理程式。為了讓您更容易在 harness 層切換提供者,我們推出 Lite-Harness SDK。這是一個簡單的 TypeScript+Python SDK,讓開發者能像切換模型一樣切換 harness。
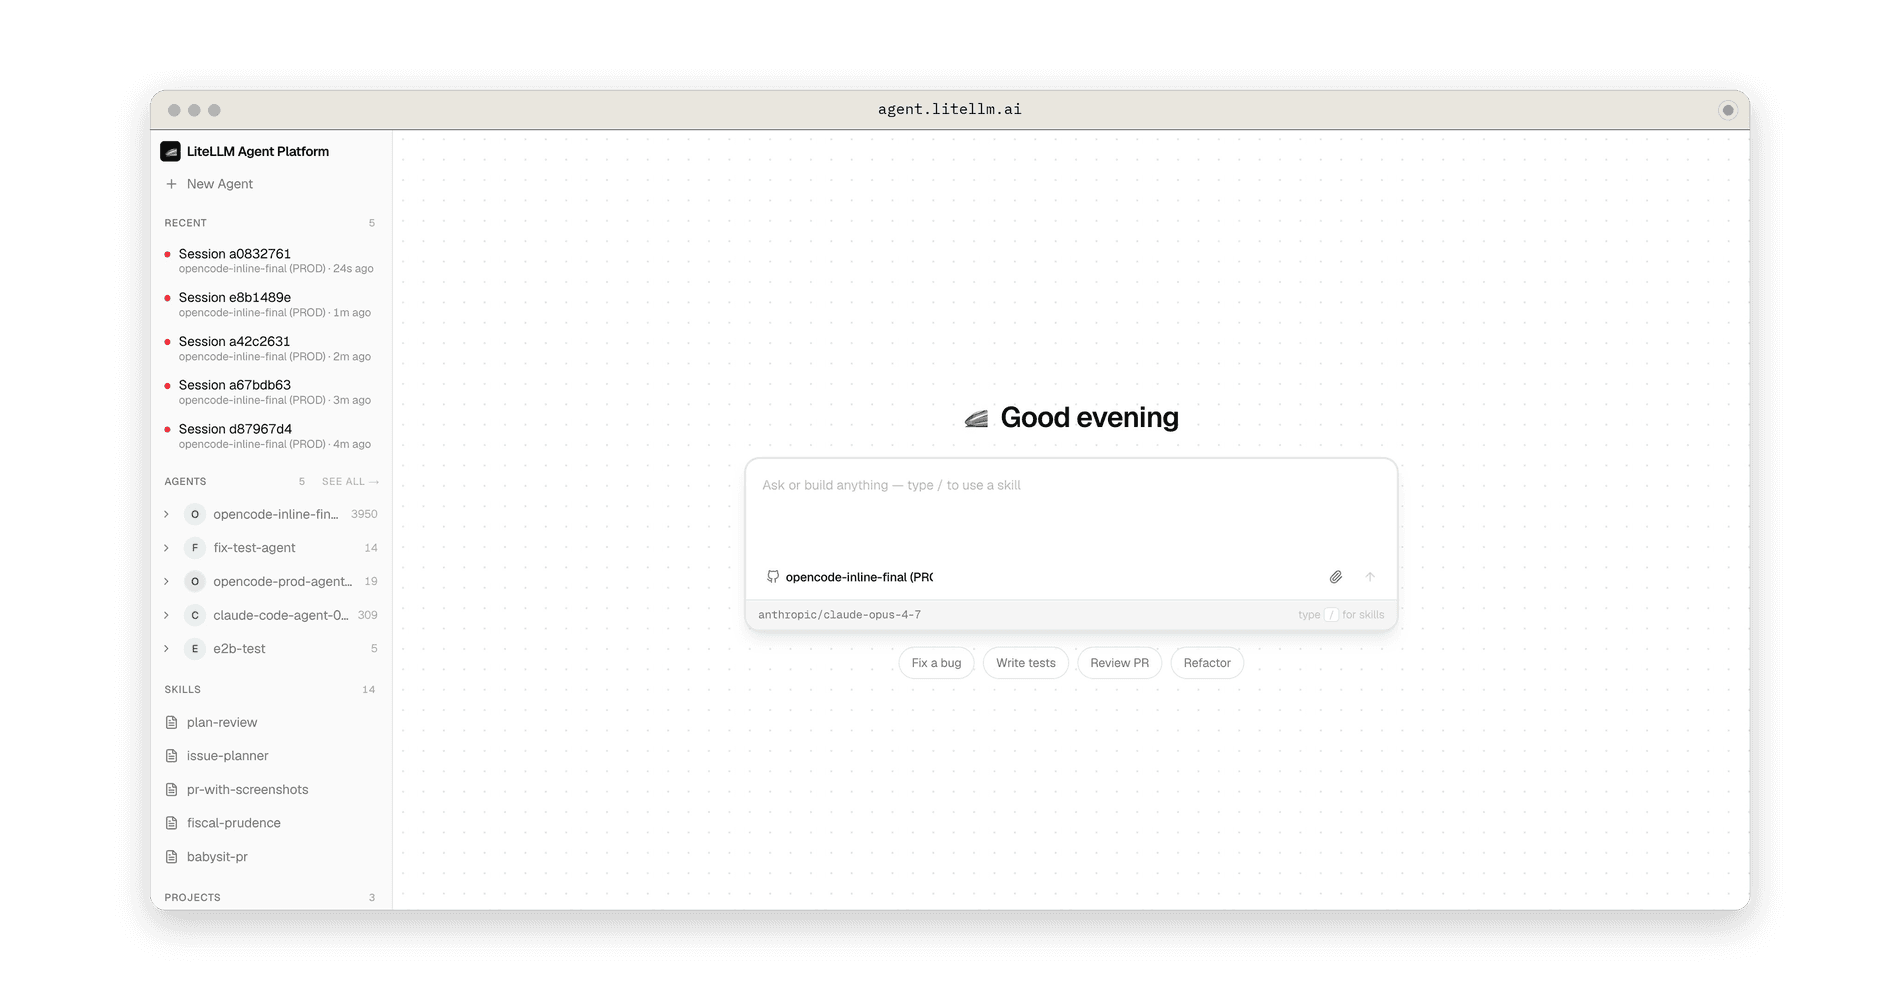
我們打造的平台是開源的。請查看 litellm-agent-platform。可替換的 harness 層是 lite-harness。
想在貴公司內部打造相同的東西嗎?
我們的目標是用代理程式將公司的生產力提升 10 倍。
三週前,我們開始打造一個能夠承接 30% 工程票券的代理程式。以下是截至目前我們的所學。
最後更新:2026 年 5 月
LiteLLM proxy 容器做兩件非常不同的事。它既是 LLM data plane,/chat/completions、/v1/messages、embeddings、passthroughs,這些工作的延遲開銷以個位數毫秒計算,而且流量量大且具突發性。它同時也是金鑰、團隊、SSO、稽核記錄,以及支撐儀表板的支出/使用量分析的 管理控制平面,其中單一請求就可能掃描數百萬列資料。
把兩者跑在同一個 event loop 上,控制平面做得最慢的事情,就會決定資料平面最快的事情能達到的可靠性下限。這篇文章說明我們如何透過提供 componentized deployment 模型,提升 LiteLLM 在大規模下的可靠性。
最後更新:2026 年 4 月
企業級 AI 閘道部署將 Redis 放在幾乎每個請求的熱路徑上:速率限制、快取查詢、支出追蹤。當 Redis 正常時,延遲影響僅有個位數毫秒,終端使用者幾乎察覺不到。當它劣化時,正式環境中的 AI 閘道就必須不受影響地持續運作。
在 100+ 個 Pod 上大規模執行 LiteLLM,意味著必須在失敗模式出現之前先為其設計。簡單的情況是 Redis 完全當機:快速失敗,回退到資料庫,繼續提供請求服務。困難的情況,也是會拖垮閘道的情況,是 緩慢 的 Redis:仍然接受連線、仍然回應,但每次操作都會在 20 到 30 秒後逾時。