LiteLLM ROI 計算器介紹
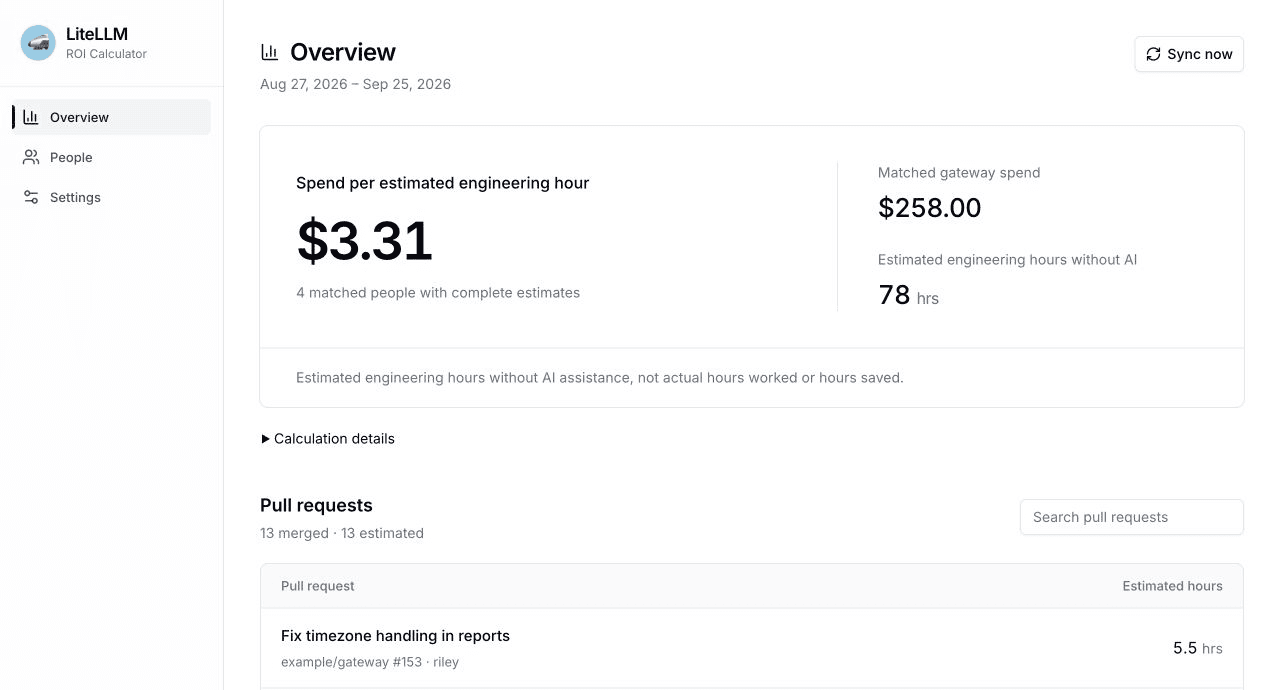
您的閘道會告訴您團隊在 AI 上花了多少錢。它不會告訴您這些支出產生了什麼。
**LiteLLM ROI 計算器 會比較閘道支出與團隊交付的工程工作。**它會從 LiteLLM 讀取每位使用者的支出、使用您選擇的模型估算每個已合併拉取請求的工時,並依電子郵件配對對象。結果只會得到一個數字:每個預估工程時數的支出。
您的閘道會告訴您團隊在 AI 上花了多少錢。它不會告訴您這些支出產生了什麼。
**LiteLLM ROI 計算器 會比較閘道支出與團隊交付的工程工作。**它會從 LiteLLM 讀取每位使用者的支出、使用您選擇的模型估算每個已合併拉取請求的工時,並依電子郵件配對對象。結果只會得到一個數字:每個預估工程時數的支出。
我們透過結合複雜度與能力評估來改進 Fuse V2,以了解每個模型在哪些情況下成功、失敗,以及何時需要升級。


我們使用 LiteLLM 的實驗性能力路由器,以 $11.15 解決了 25 個 SWE-bench Verified 任務中的 23 個。若所有 solver 請求都使用 Opus 5,我們以 $20.27 解決了 23 個任務。包含分類器請求在內,兩次執行皆啟用提示快取,我們總共少花了 45%。
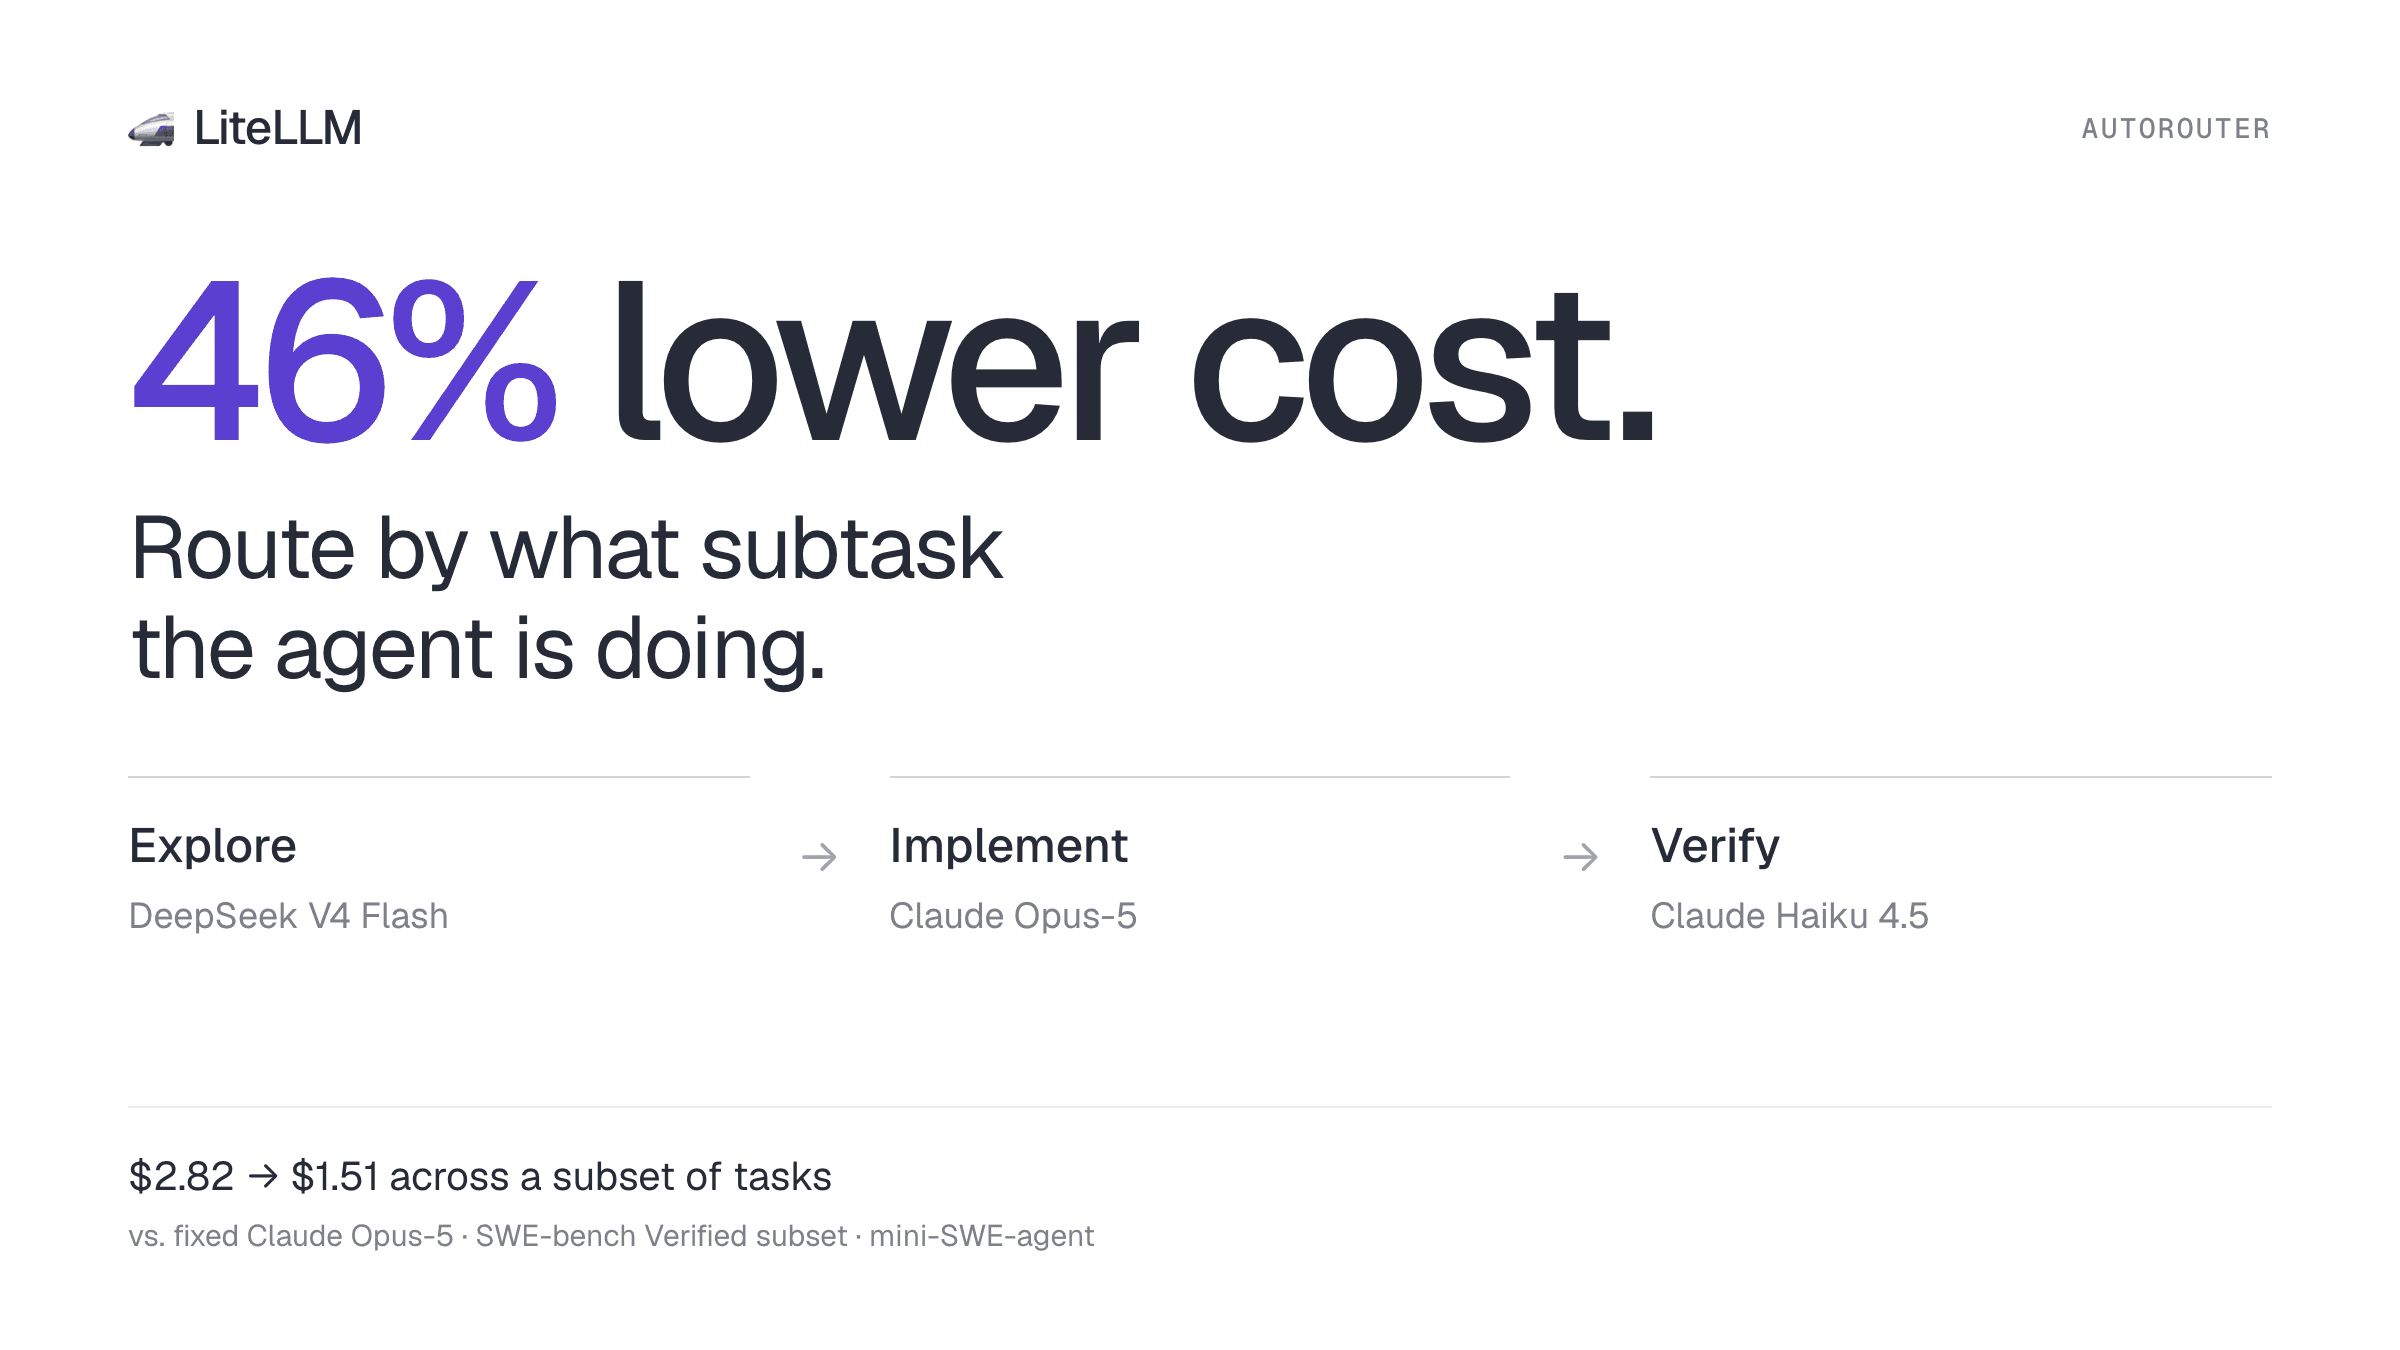
這個實驗性的路由器會依代理程式所處的階段為每個回合選擇模型,在 SWE-bench Verified 子集合上,以比固定 Claude Opus-5 低 46% 的成本,達到相同品質。
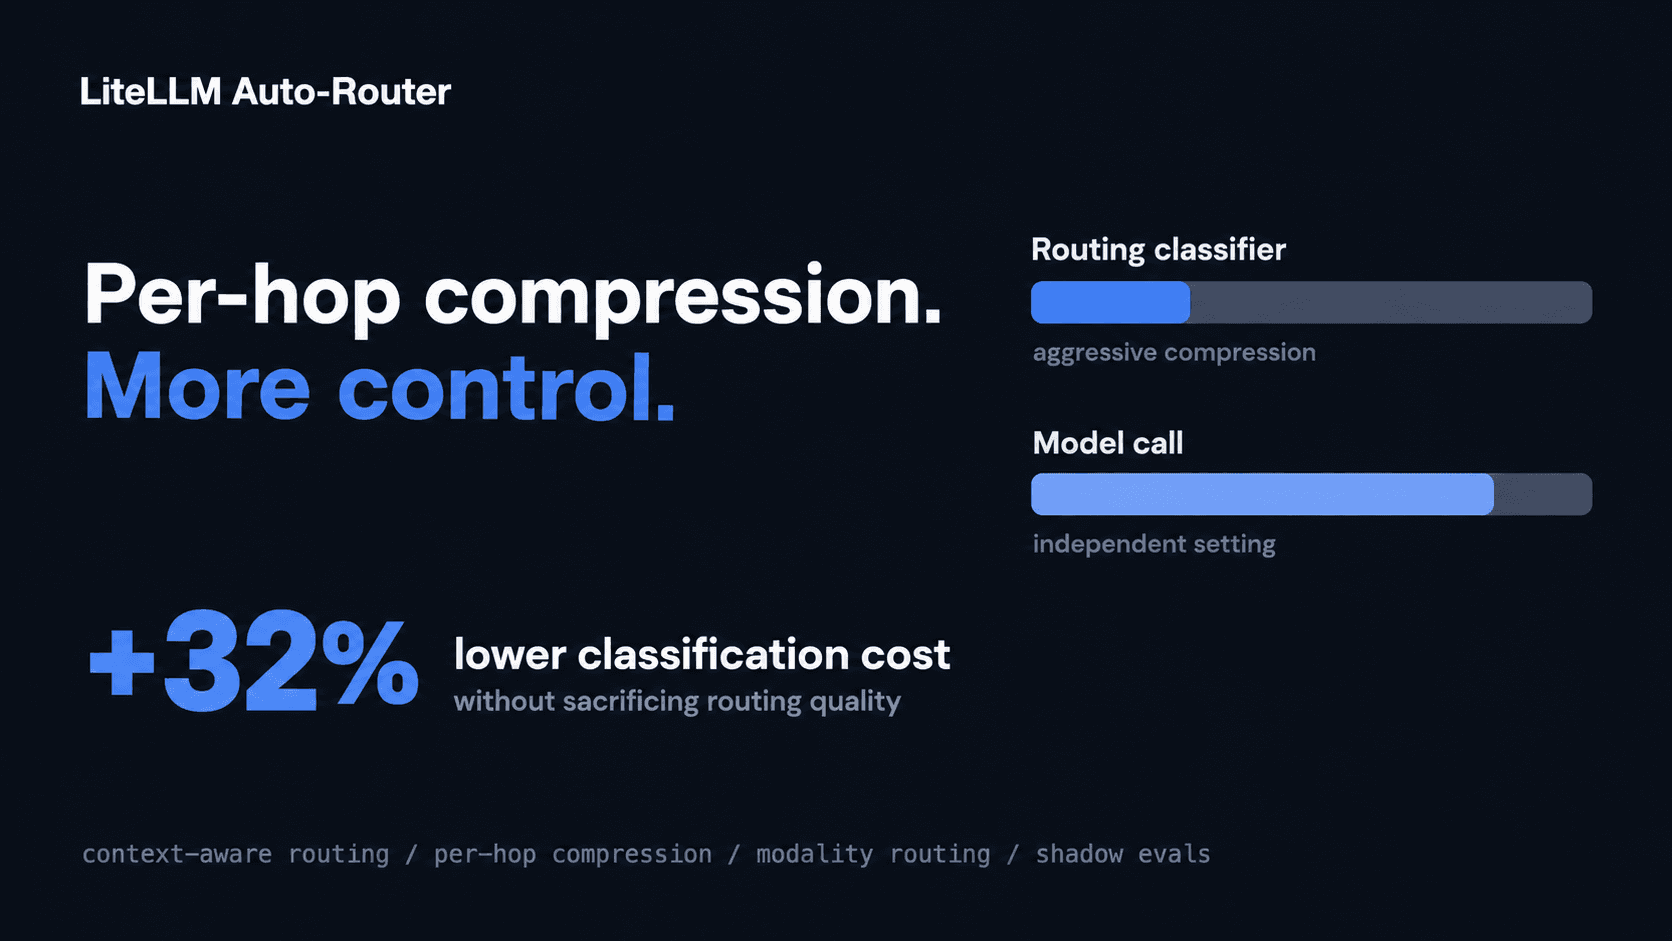
complexity router 的 LLM 分類器現在可以比您的模型呼叫更積極地壓縮。在內部測試中,這讓分類成本在共享壓縮原本已節省的基礎上再降低 32%,且路由準確度沒有變化。
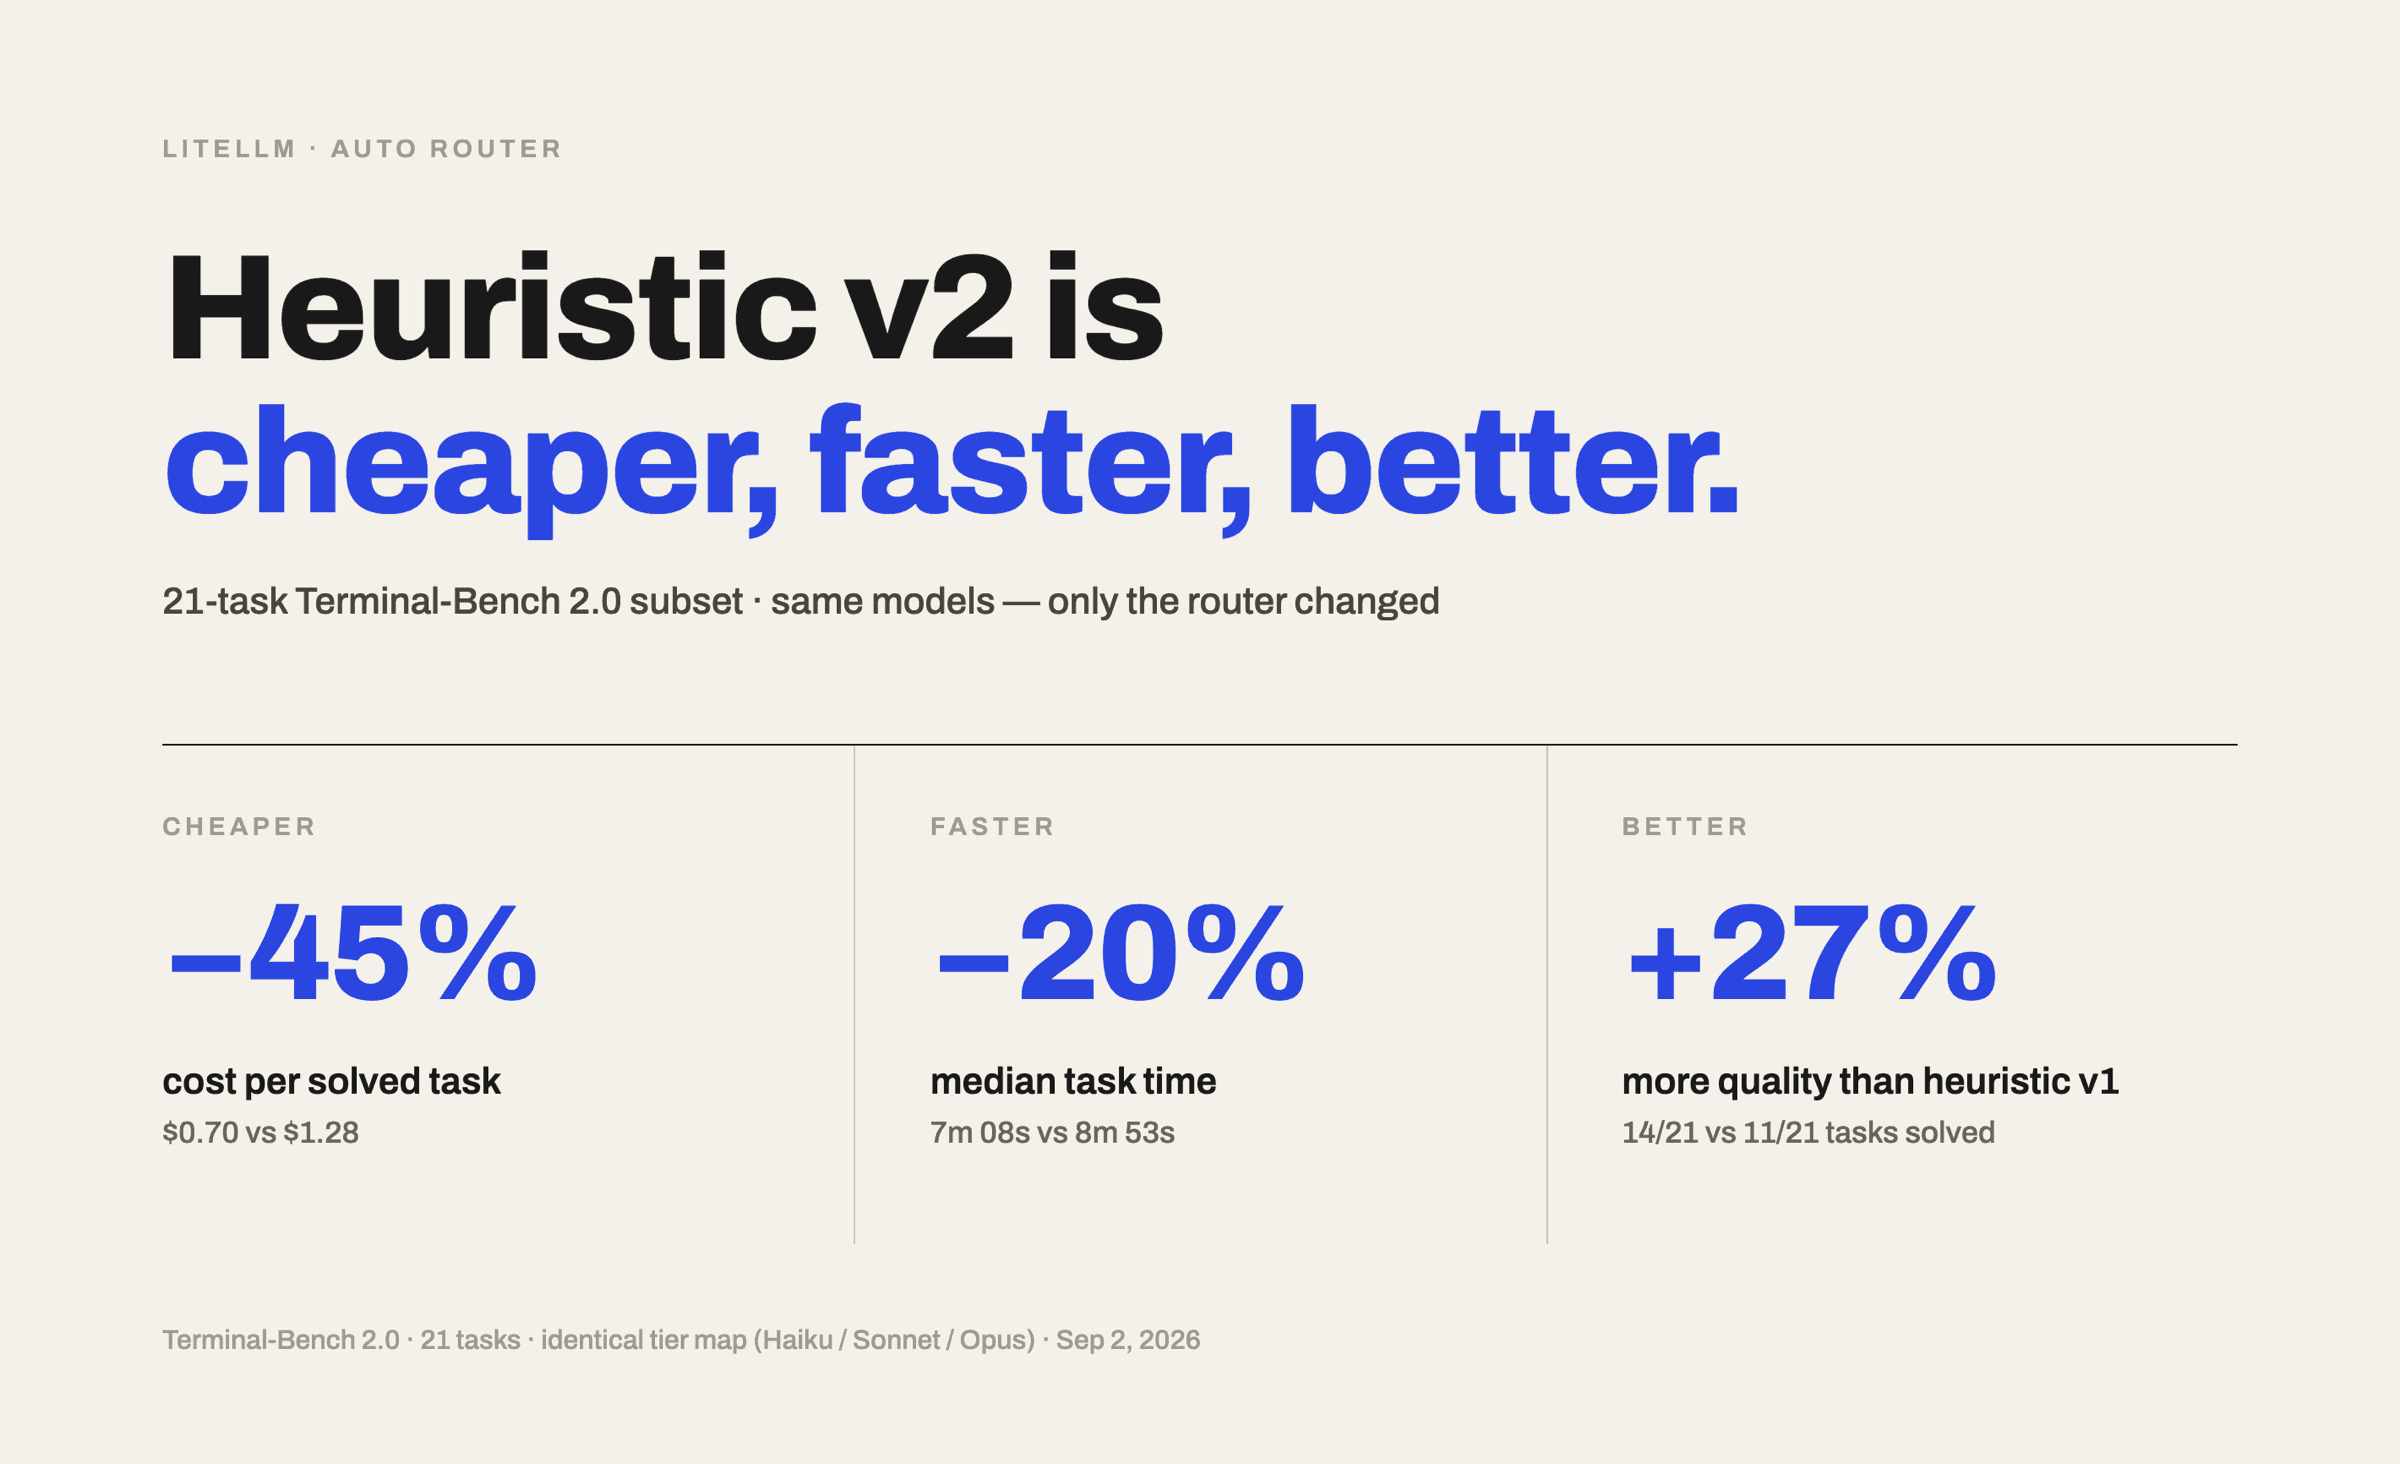
Heuristic v2,LiteLLM 的新 AutoRouter 分類器,效率最高可比 Heuristic v1 高 45%:以更低成本,在更短時間內解決更多任務。 只有分類器改變了。
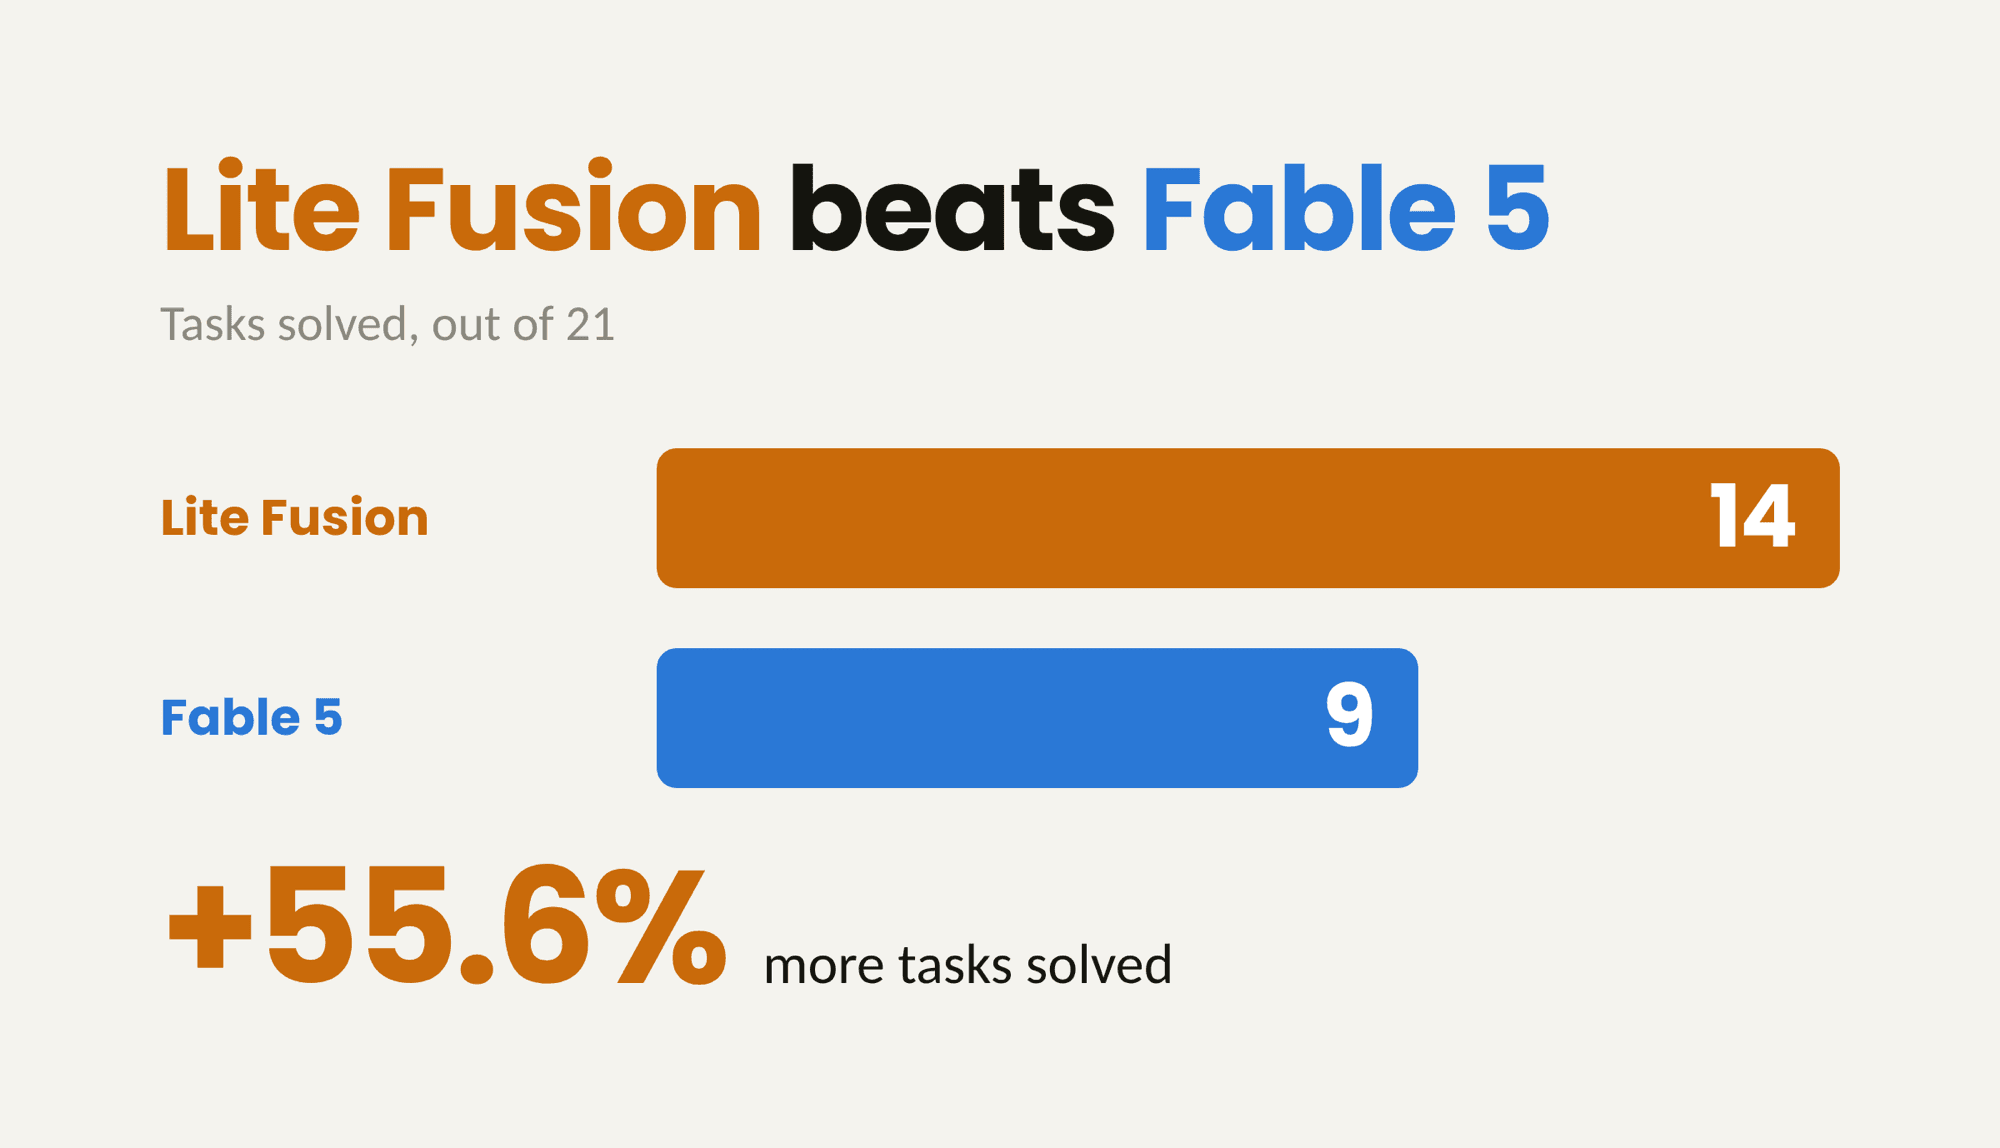
LiteLLM Auto Router Fusion 在 21 個 Terminal-Bench 任務中解決了 14 個;Claude Fable-5 單獨則解決了 9 個。 Fusion 會在多個模型上平行執行任務,並由其中一個模型將候選成果綜合成單一答案。兩個分支都執行了相同的 21 個任務。
您可以預期從第一天起使用 Auto Router 大約可減少 40% 的成本,隨著 tier maps 的調整還會更多。我們的一位正式環境使用者分享了他的統計數據,展示在大規模下會是什麼樣子。
他們將 Auto-Router 部署到 dev、staging 和 prod 執行個體中的 450+ 位使用者,並節省了 $12,249,涵蓋 270k+ 次請求。
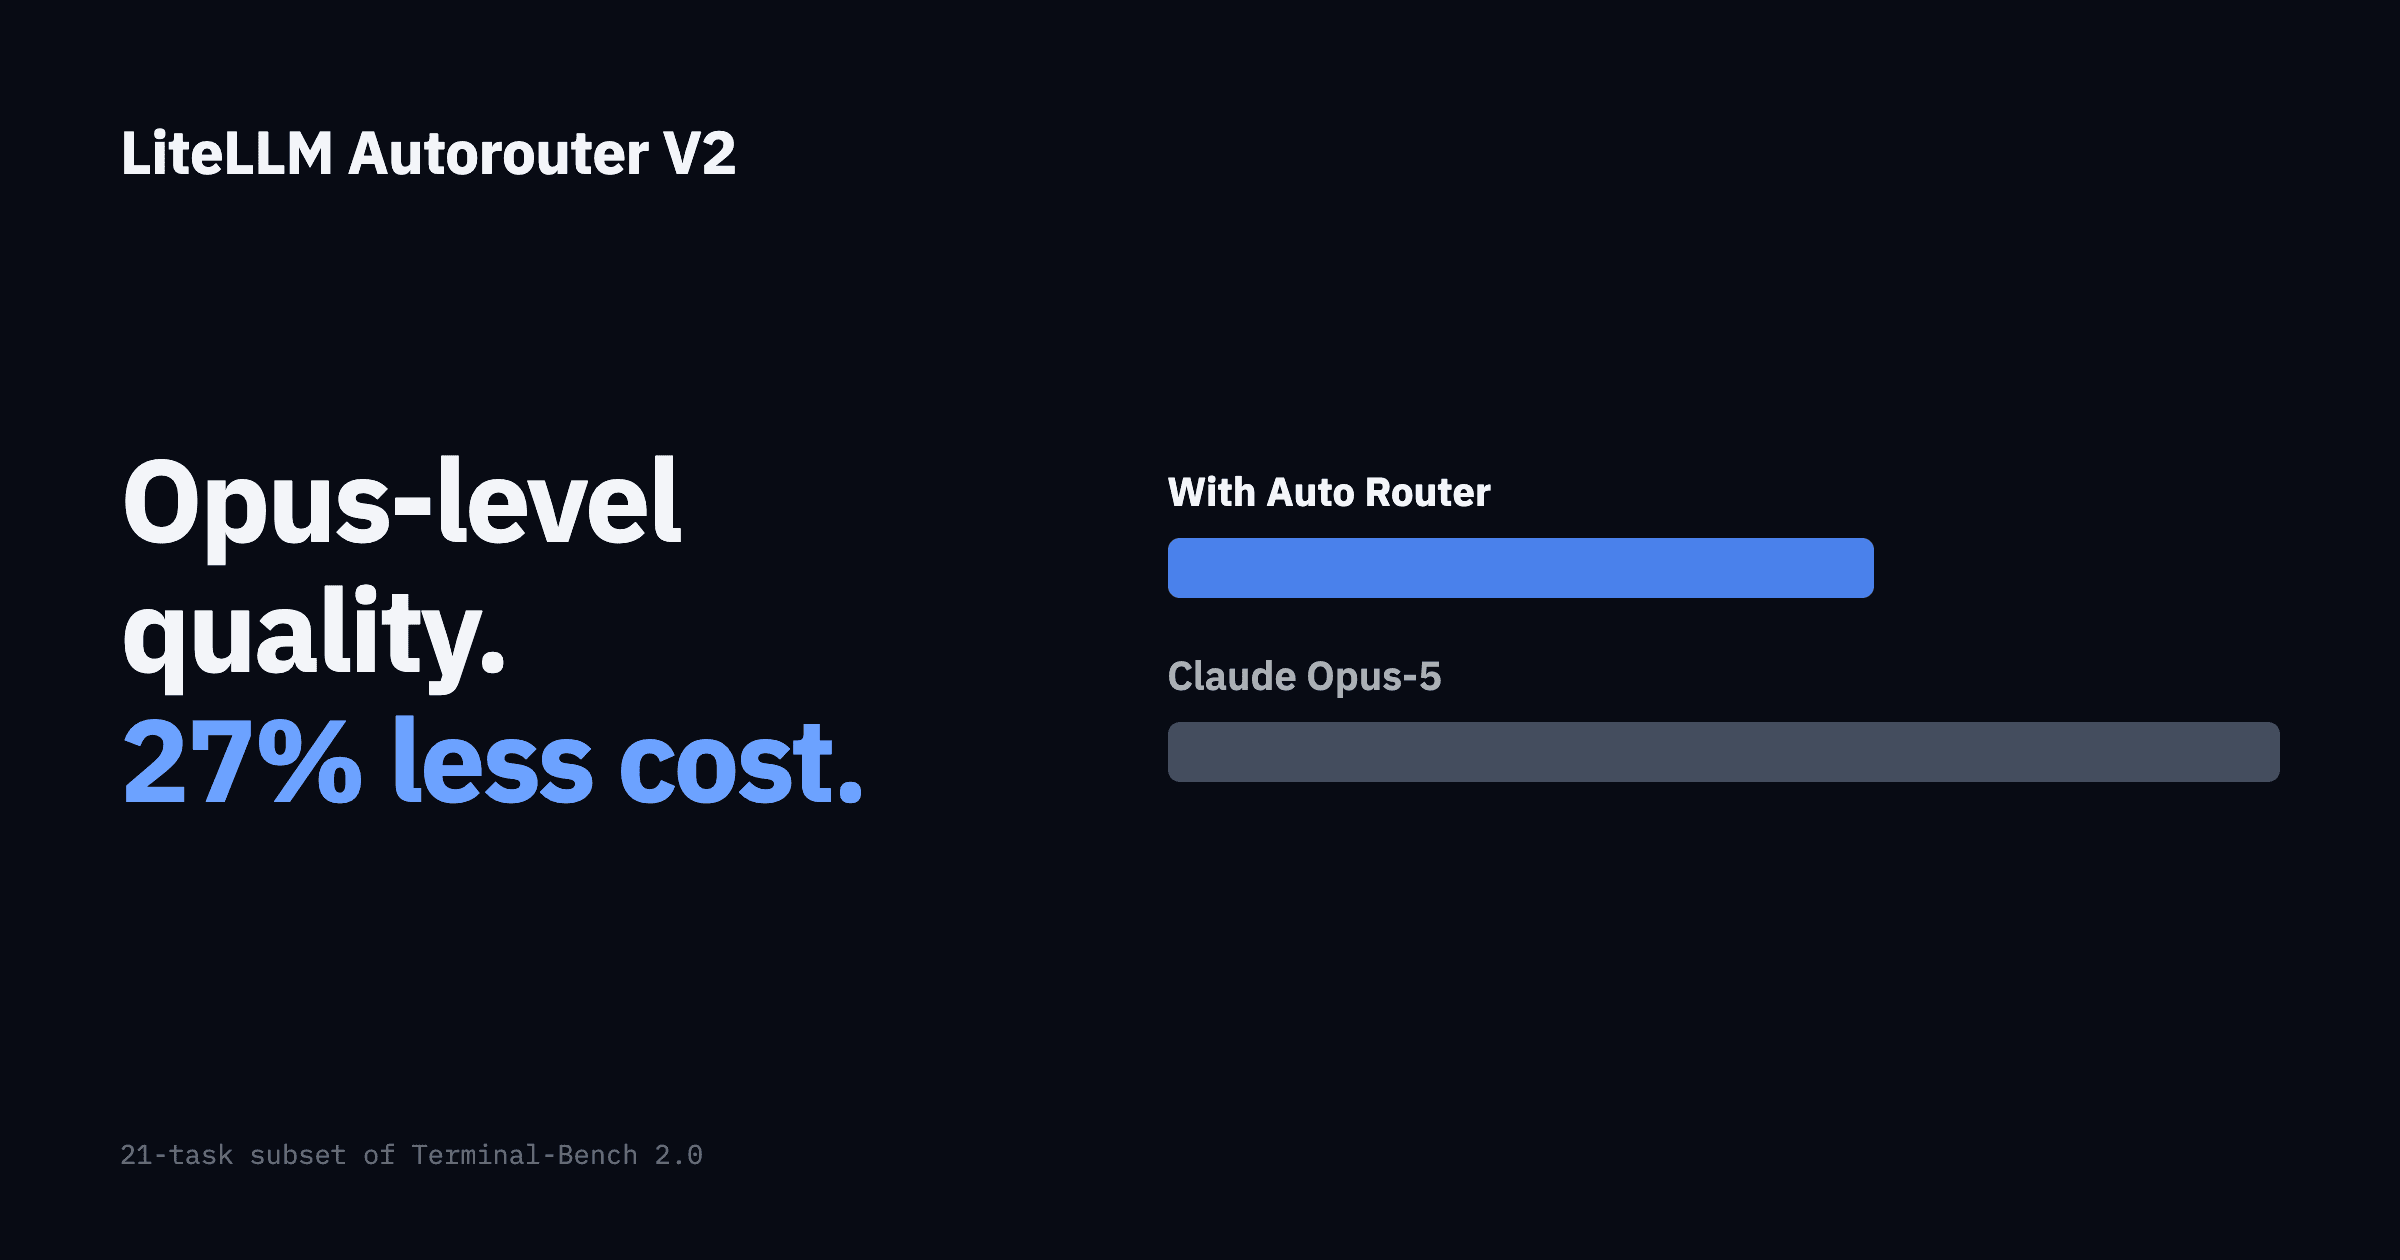
自動路由器在 Terminal-Bench 2.0 的 21 個任務子集上,以 27% 更低的成本達到與 Claude Opus-5 相同的解題率。 每個 arm 都執行相同的 21 個任務,因此比較是同類相較。
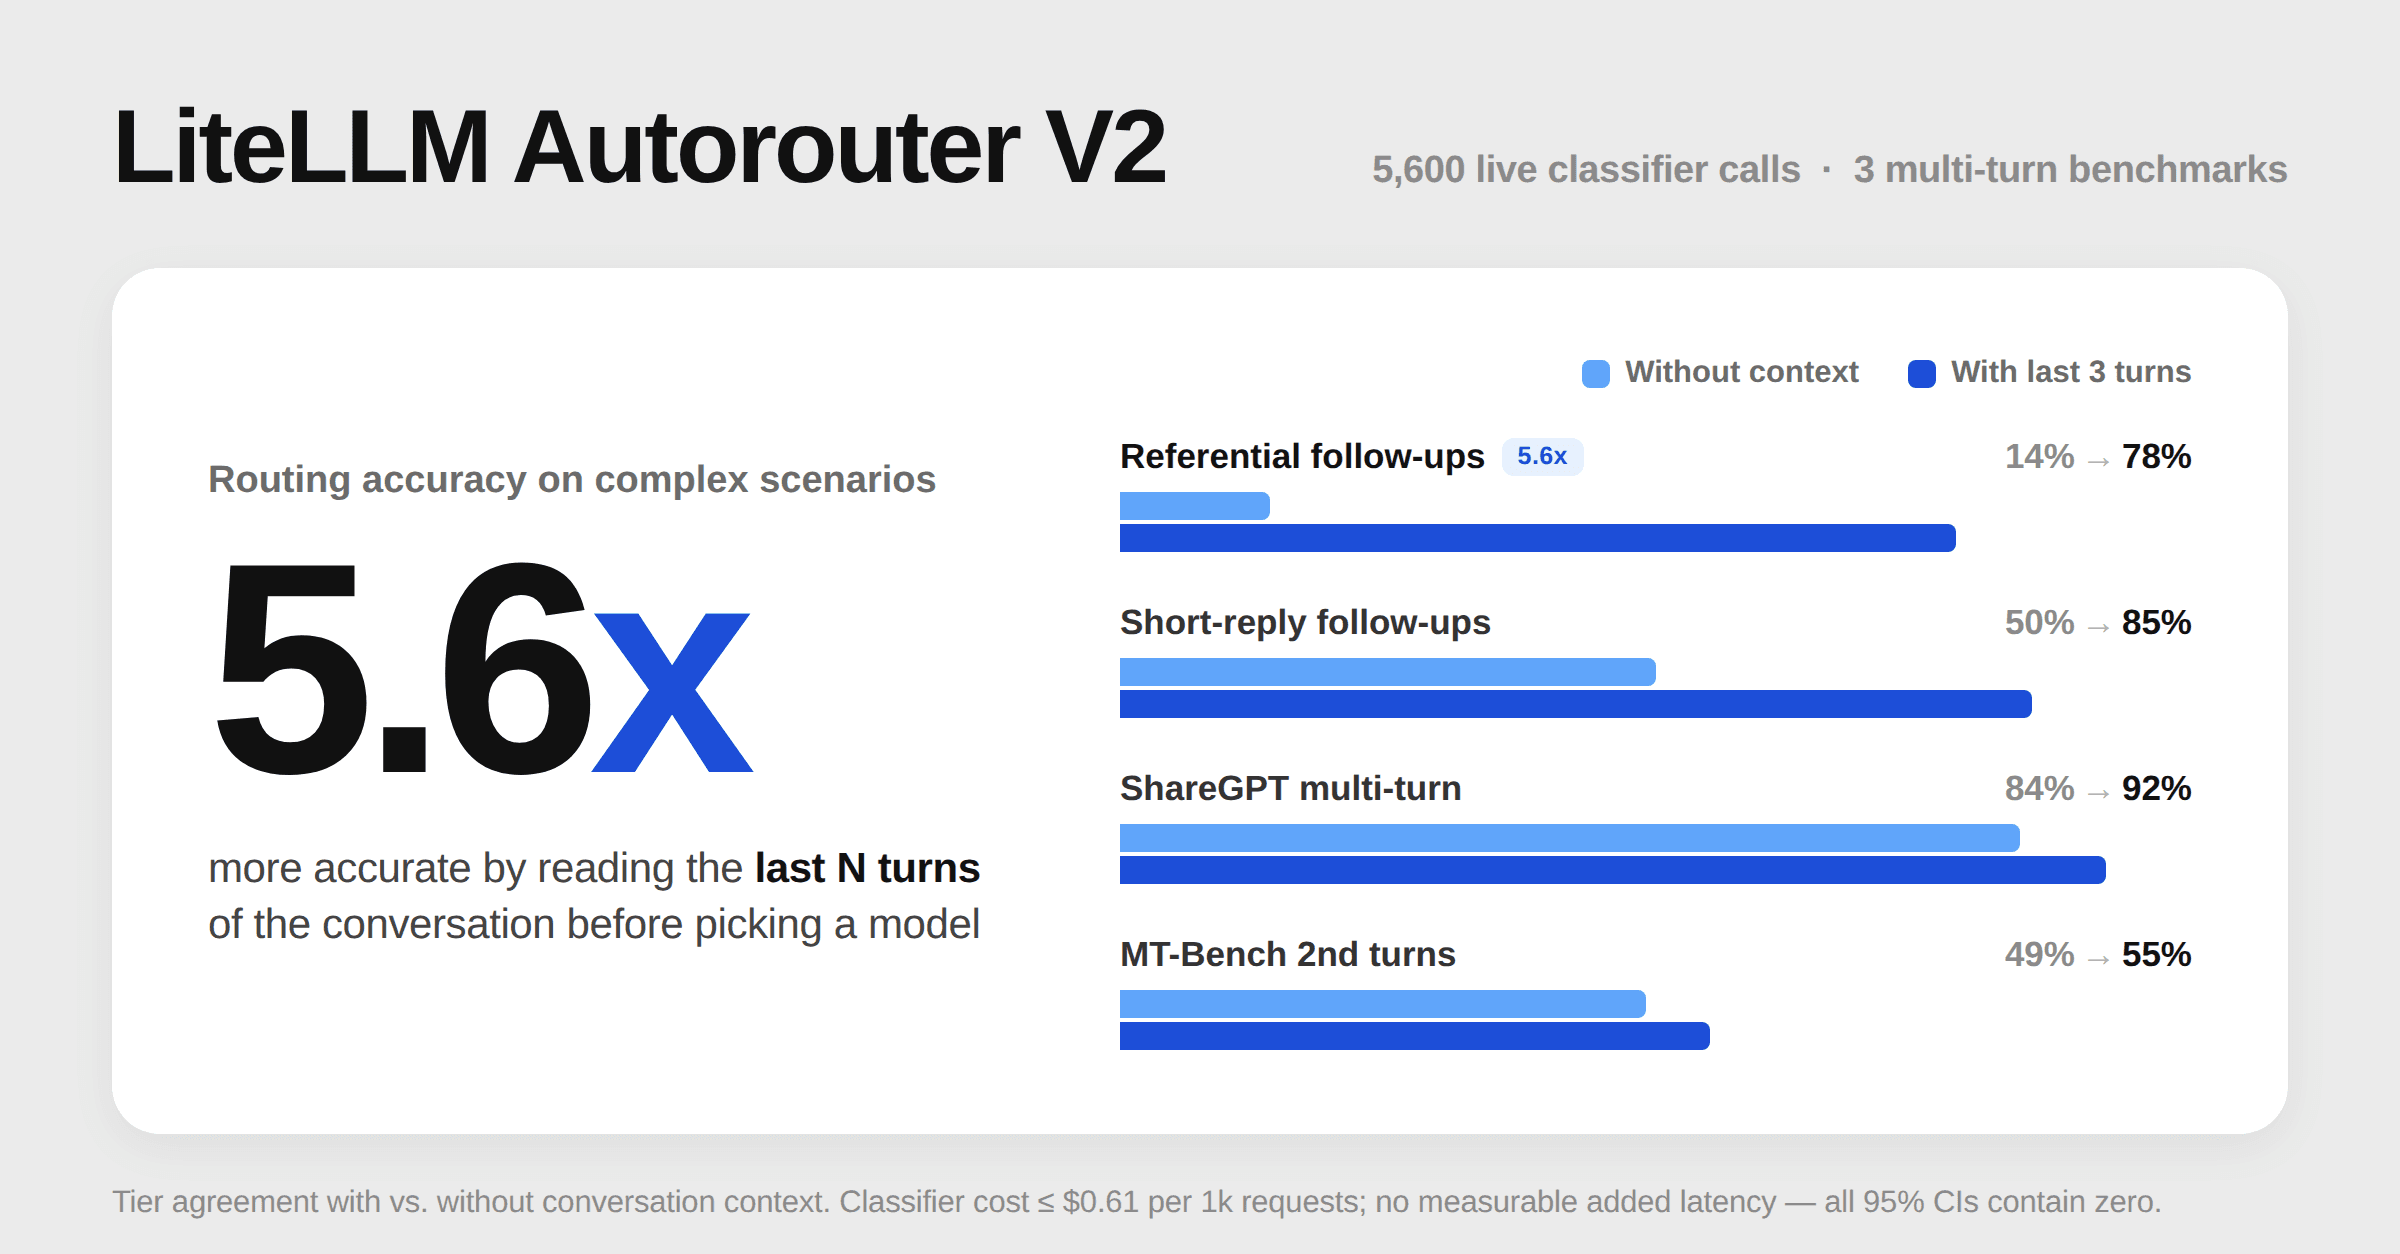
v1.97 對 auto router 做了三項變更。
classifier_context_window_size 現在預設為 3(僅 LLM 分類器),而 session_affinity 現在預設為 false(所有 routers)。設定檔不會被修改,但新預設值會套用到任何尚未設定的鍵,因此從未提及 session_affinity 的設定,在升級後會重新分類每一輪。明確設定任一鍵值的設定不受影響。
是的,您可以在 Auto-Routing 中使用 prompt 快取。 兩者是相輔相成,而非彼此抵消。我們在五個資料集上進行了測量,其中兩個會回報提供者的快取實際做了什麼。
自動路由承諾在不降低答案品質的前提下,讓帳單更小。我們以把每個請求都送往 claude-opus-5 的基準來衡量兩個面向:8,619 個評分過的提示,以及對 14,000 則真實對話的成本模擬。

Claude Code 是現代工程組織中最重度消耗輸入 token 的工具之一。冗長的工具迴圈、龐大的檔案讀取,以及包含數百個工具的 MCP 目錄,會讓每個請求都推到 context window 的頂端,而帳單也隨之攀升。
如果 Claude Code 已經透過 ANTHROPIC_BASE_URL 指向 LiteLLM proxy,平台管理員可以透過五個槓桿來降低成本。這些方法都不需要在用戶端做任何變更。