我們如何將長提示的首字回應時間縮短 94%
LiteLLM 一直在長對話中數算每一個 token,只為了回答一個是或否的路由問題。
移除這項不必要的工作後,在我們本機 44 萬 token 的基準測試中,首字回應時間中位數從 553 毫秒降到 35 毫秒:降低 94%。
LiteLLM 一直在長對話中數算每一個 token,只為了回答一個是或否的路由問題。
移除這項不必要的工作後,在我們本機 44 萬 token 的基準測試中,首字回應時間中位數從 553 毫秒降到 35 毫秒:降低 94%。
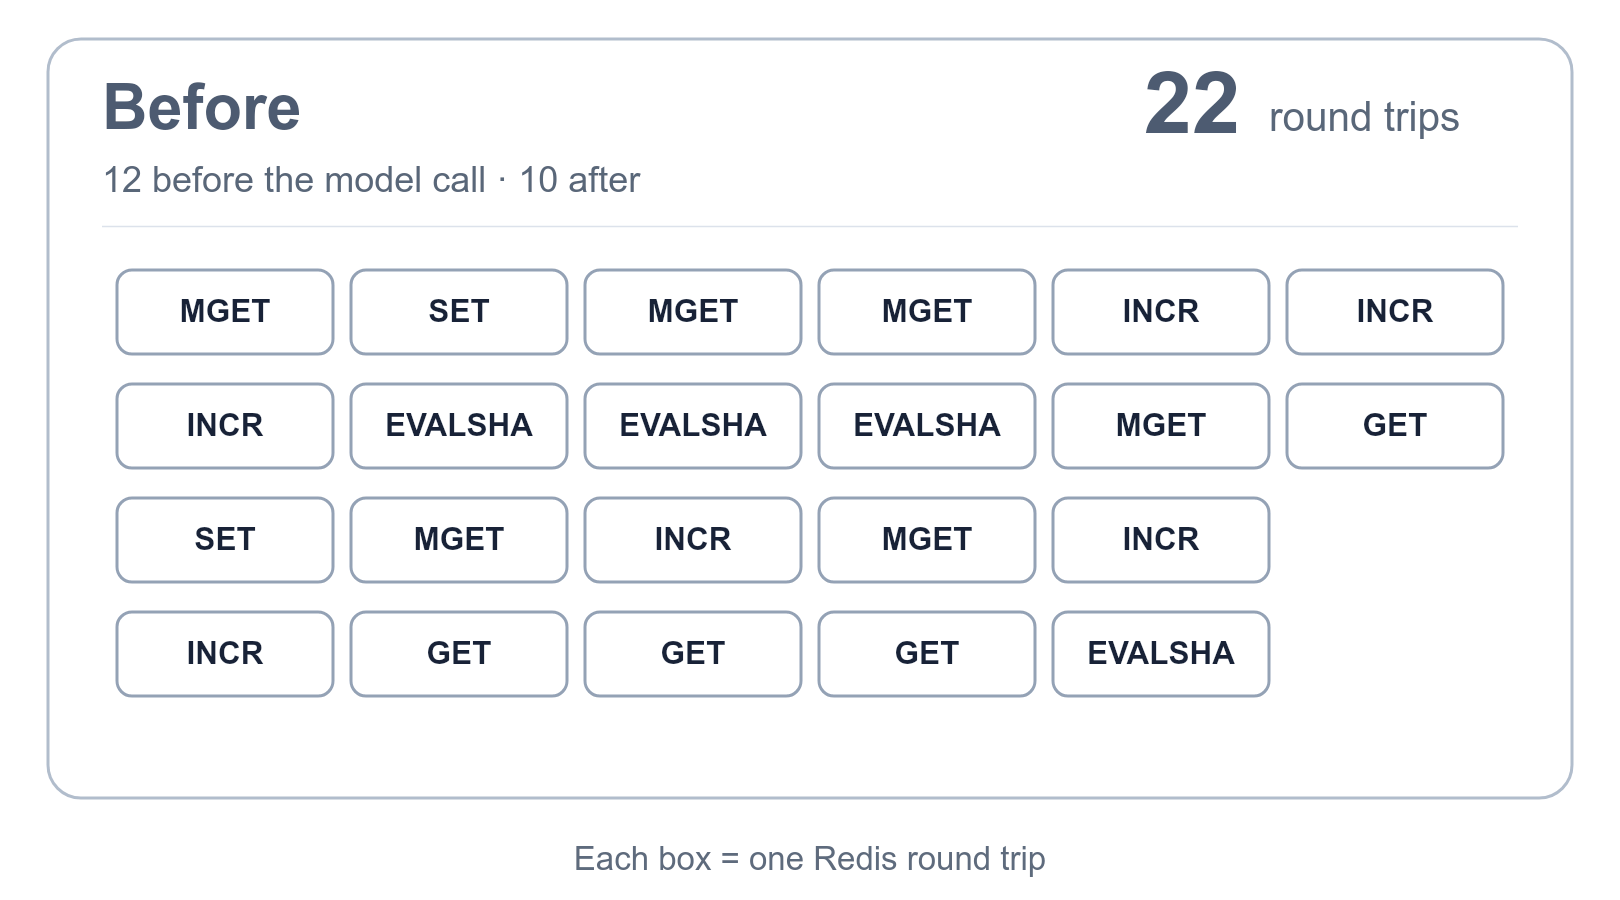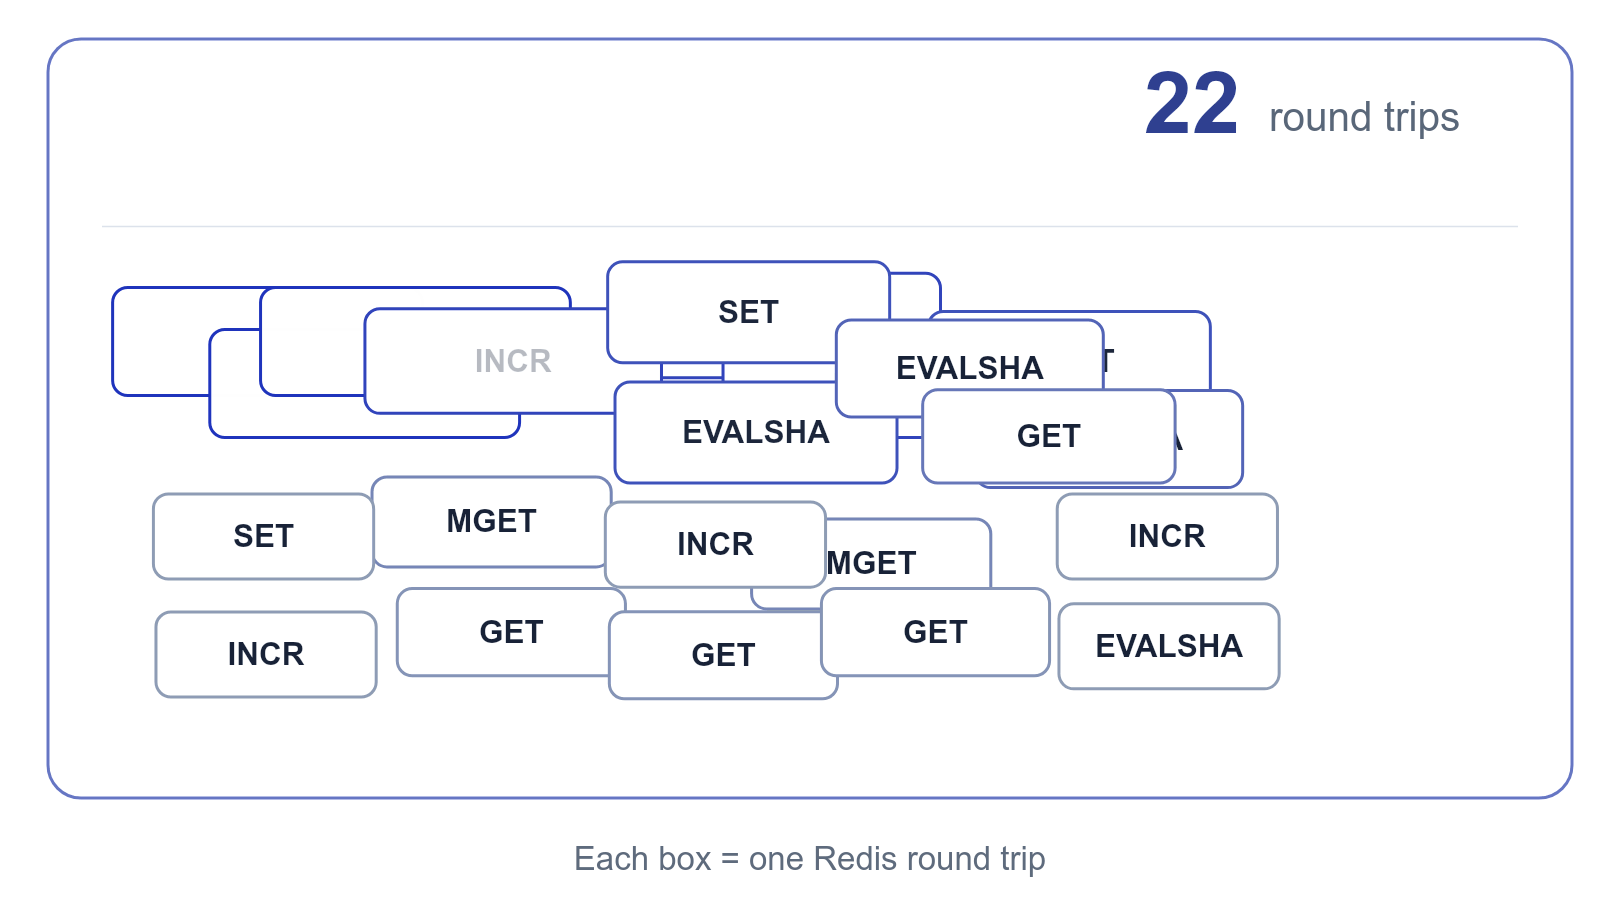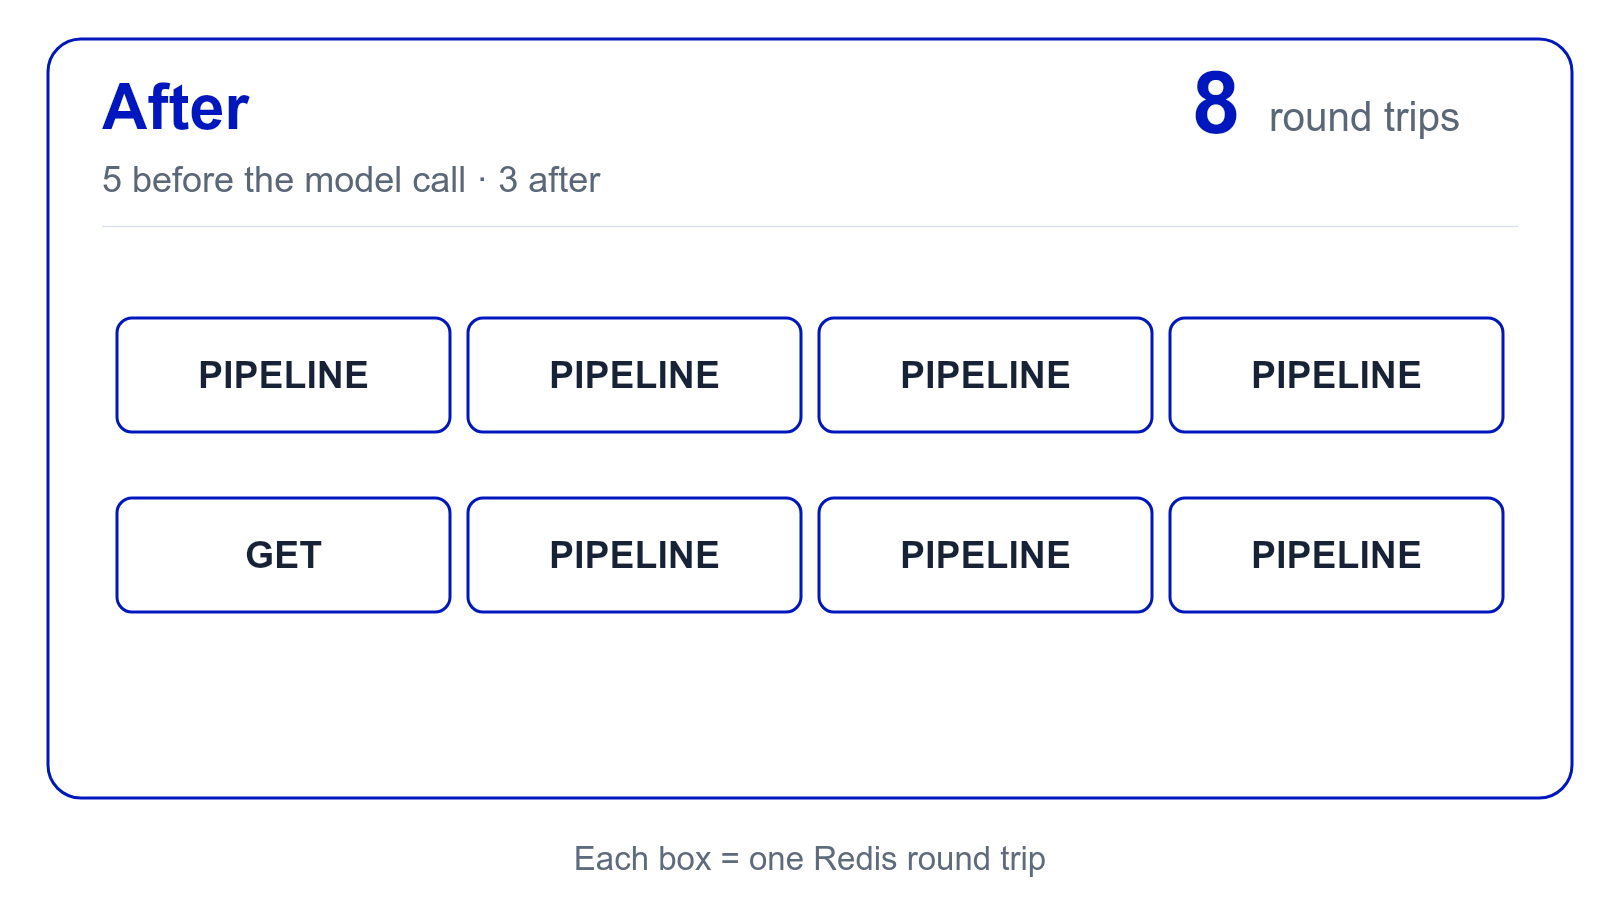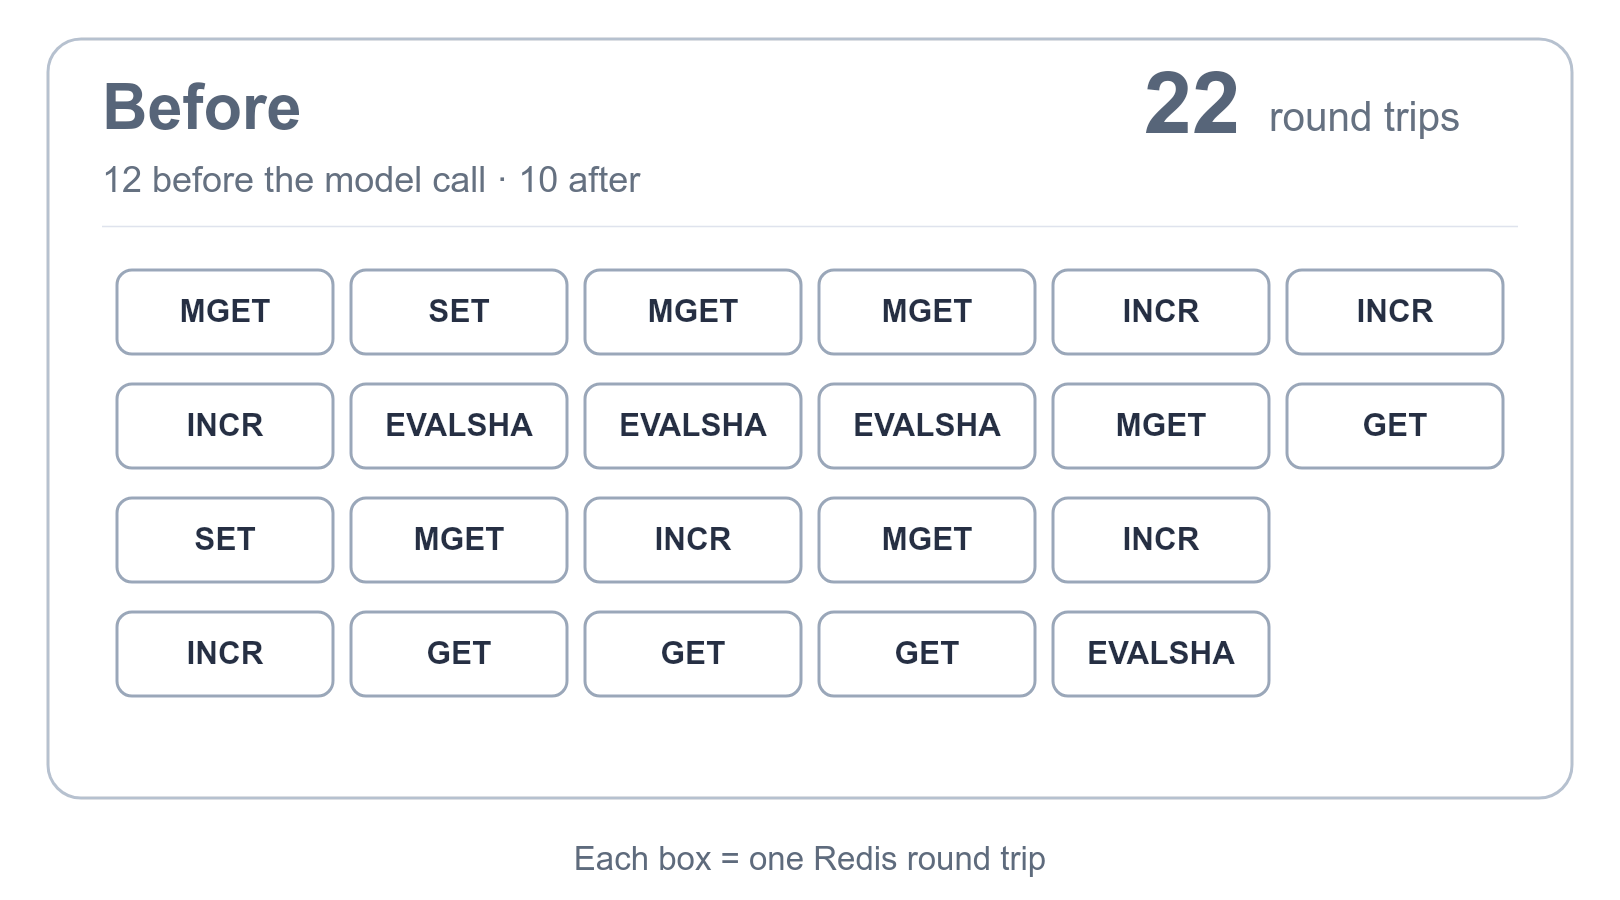
本週,我們將 LiteLLM proxy 上一個請求等待 Redis 的次數從 22 次降到 8 次。
一個來自具有預算之金鑰、位於具有預算與 TPM/RPM 限制之團隊、針對採用依使用量路由與 Redis 回應快取之模型群組的請求,原本會造成 22 次 Redis 往返:模型呼叫前 12 次、之後 10 次。相同的請求、相同的檢查與相同的寫入,現在只需 前 5 次、後 3 次。

Router plugins 自 v1.94.x 起可在 proxy 上運作。此設計仍在演進中;歡迎告訴我們您會如何使用它,以及您接下來希望看到什麼,請參閱 GitHub 上的 autorouter 討論(#32168)。
Router plugins 現已可在 LiteLLM 上使用。每個插件都會接收路由內容、加以擴充,然後在 router 做出最終決策之前將其傳給下一個插件。
這股推動力來自 autorouter 討論(#32168):團隊希望將自己的訊號(語言偵測、網域分類、租戶政策、預算上限)層疊到路由之上,而不必等待每一項都進入核心。這個插件擴充功能讓團隊能在維持 LiteLLM 路由核心穩定的同時完成這些變更。


LiteLLM 現在支援影片 character、edit 與 extension API。
從瀏覽器/行動用戶端透過 WebRTC 連線到 Realtime API。LiteLLM 負責驗證與金鑰管理。
日期: 2026 年 2 月 24 日
期間: 持續進行中(直到修正部署)
嚴重性: 高(適用於在不同 API 金鑰之間對 Responses API 進行負載平衡的使用者)
狀態: 已解決
當在具有不同 API 金鑰的部署之間對 OpenAI 的 Responses API 進行負載平衡時(例如,不同的 Azure 區域或 OpenAI 組織),包含加密內容項目(例如 rs_... reasoning items)的後續請求會失敗,錯誤如下:
{
  "error": {
    "message": "The encrypted content for item rs_0d09d6e56879e76500699d6feee41c8197bd268aae76141f87 could not be verified. Reason: Encrypted content organization_id did not match the target organization.",
    "type": "invalid_request_error",
    "code": "invalid_encrypted_content"
  }
}
加密內容項目在密碼學上與建立它們的 API 金鑰所屬組織綁定。當路由器將後續請求負載平衡到使用不同 API 金鑰的部署時,解密就會失敗。
日期: 2026 年 2 月 23 日
期間: 約 3 小時
嚴重性: 高(適用於具有提供者萬用字元存取規則的使用者)
狀態: 已解決
當將一個新的 Anthropic 模型(例如 claude-sonnet-4-6)加入 LiteLLM 模型成本對照表,並觸發成本對照表重新載入時,對新模型的請求會被拒絕,並顯示:
key not allowed to access model. This key can only access models=['anthropic/*']. Tried to access claude-sonnet-4-6.
重新載入正確更新了 litellm.model_cost,但從未重新執行 add_known_models(),因此 litellm.anthropic_models(供萬用字元解析器使用的記憶體內集合)仍然是舊資料。即使成本對照表已知曉該新模型,對 anthropic/* 萬用字元而言,它仍然是不可見的。
openai/*、gemini/*)都存在相同的錯誤類別。