我們如何將 LiteLLM 每次請求的 Redis 往返次數降低 64%
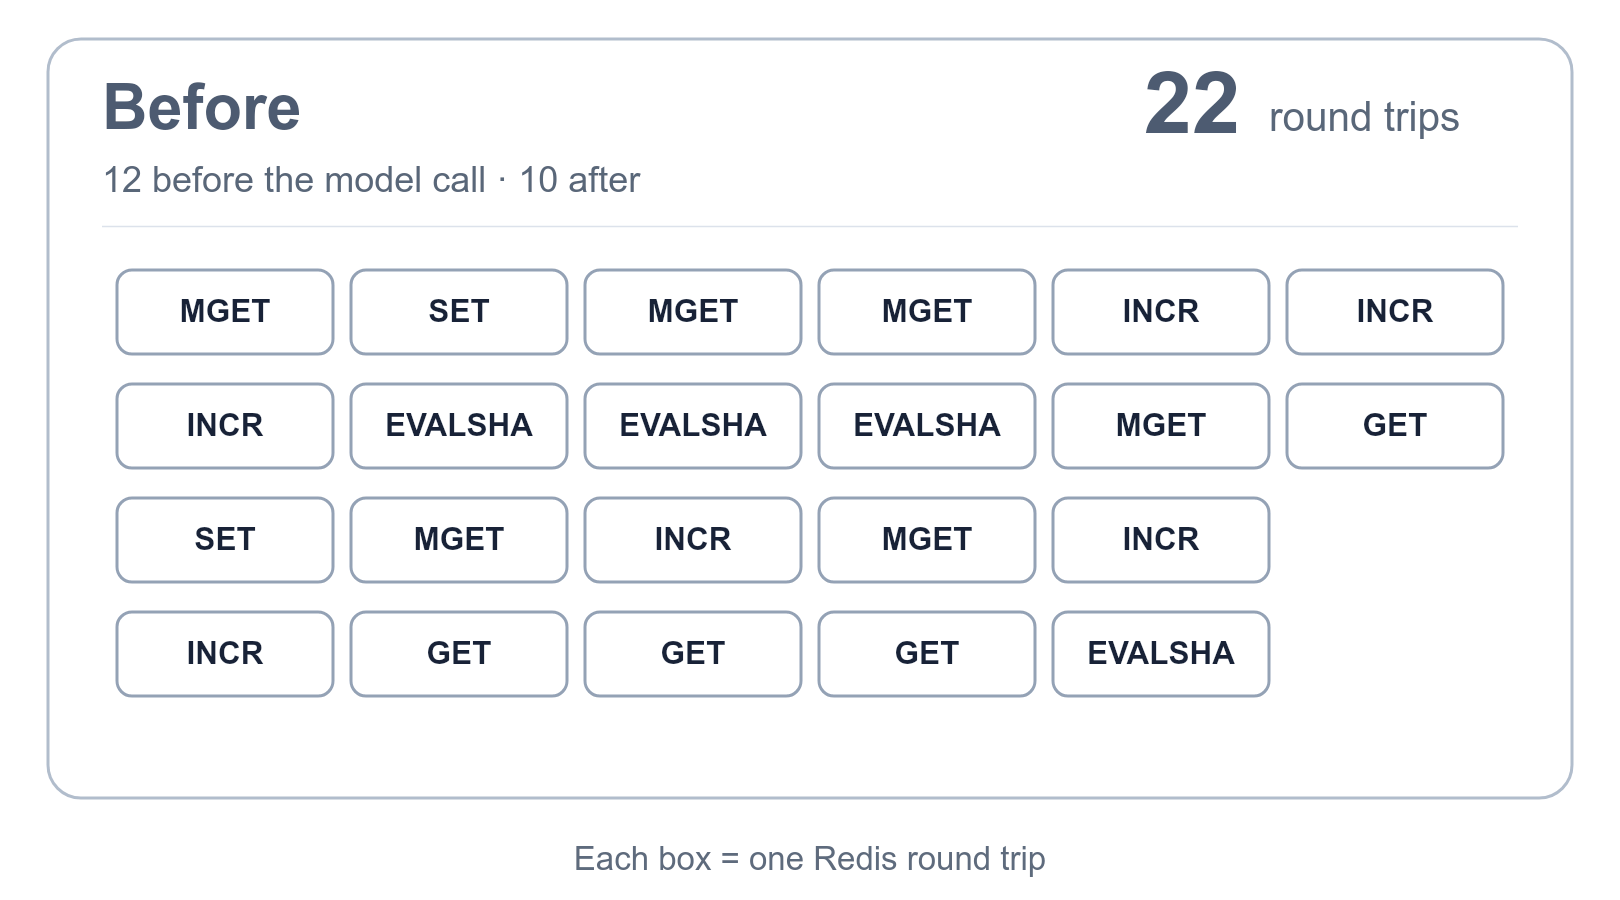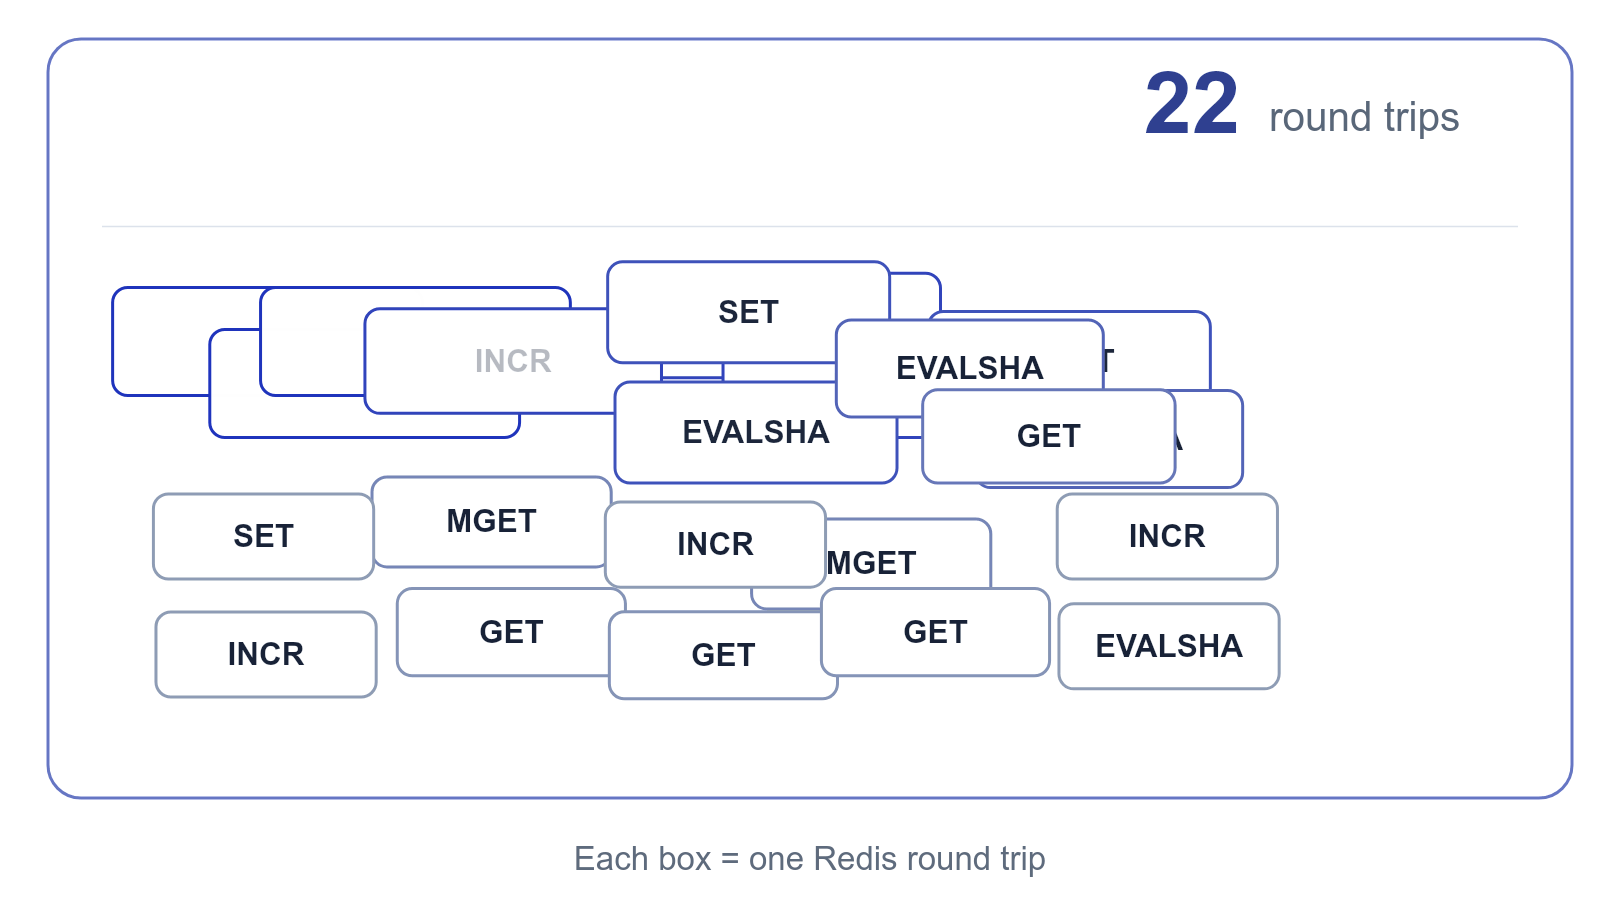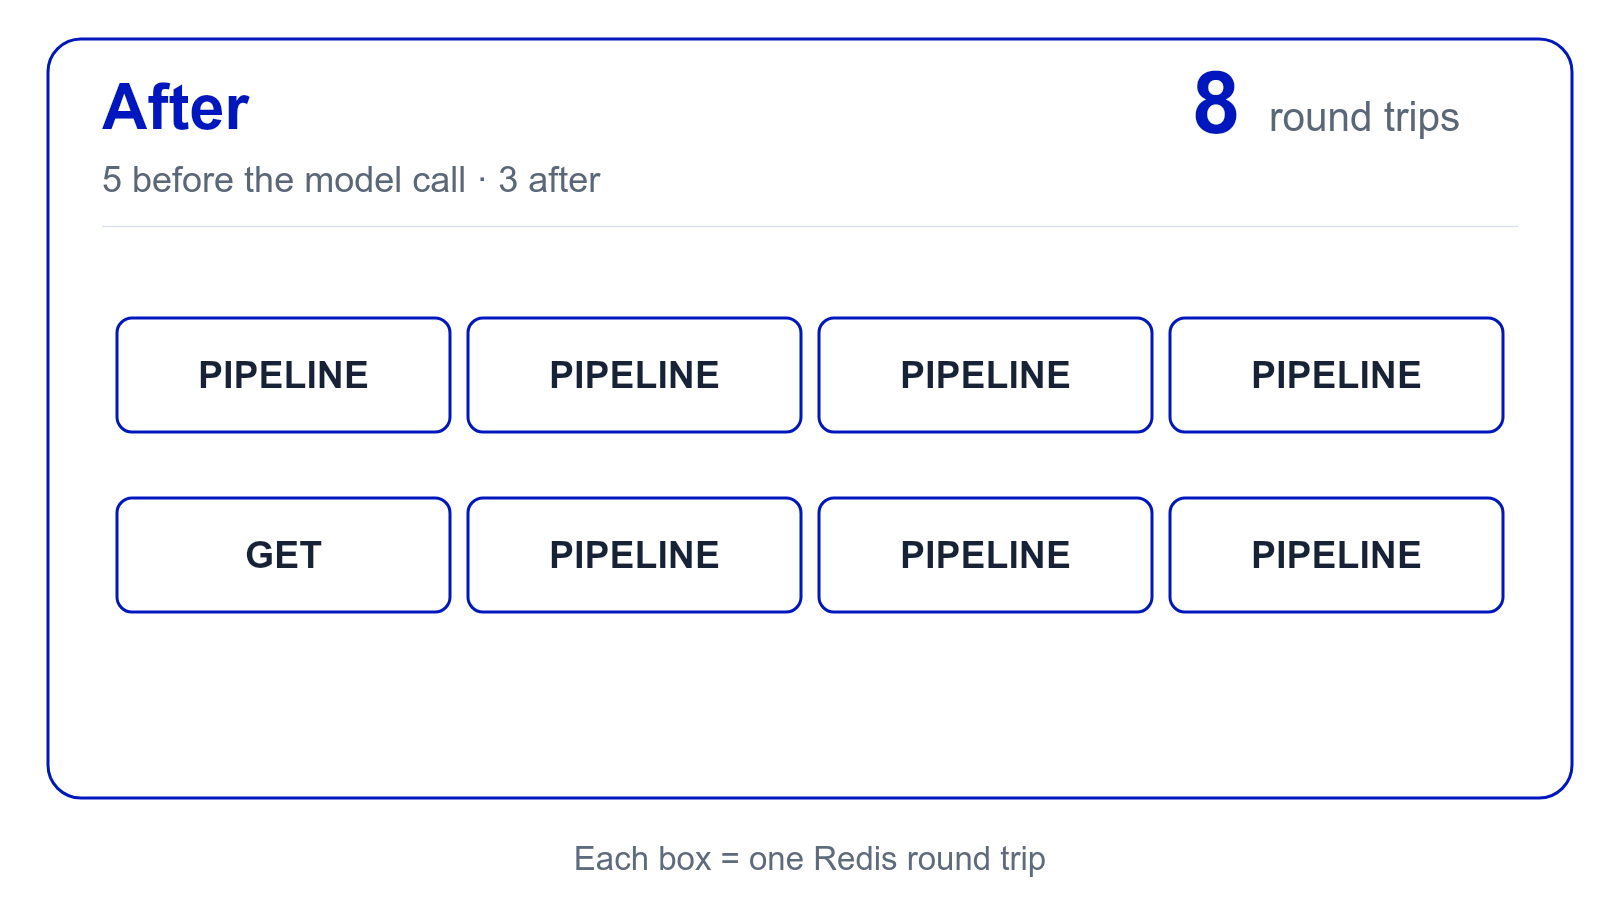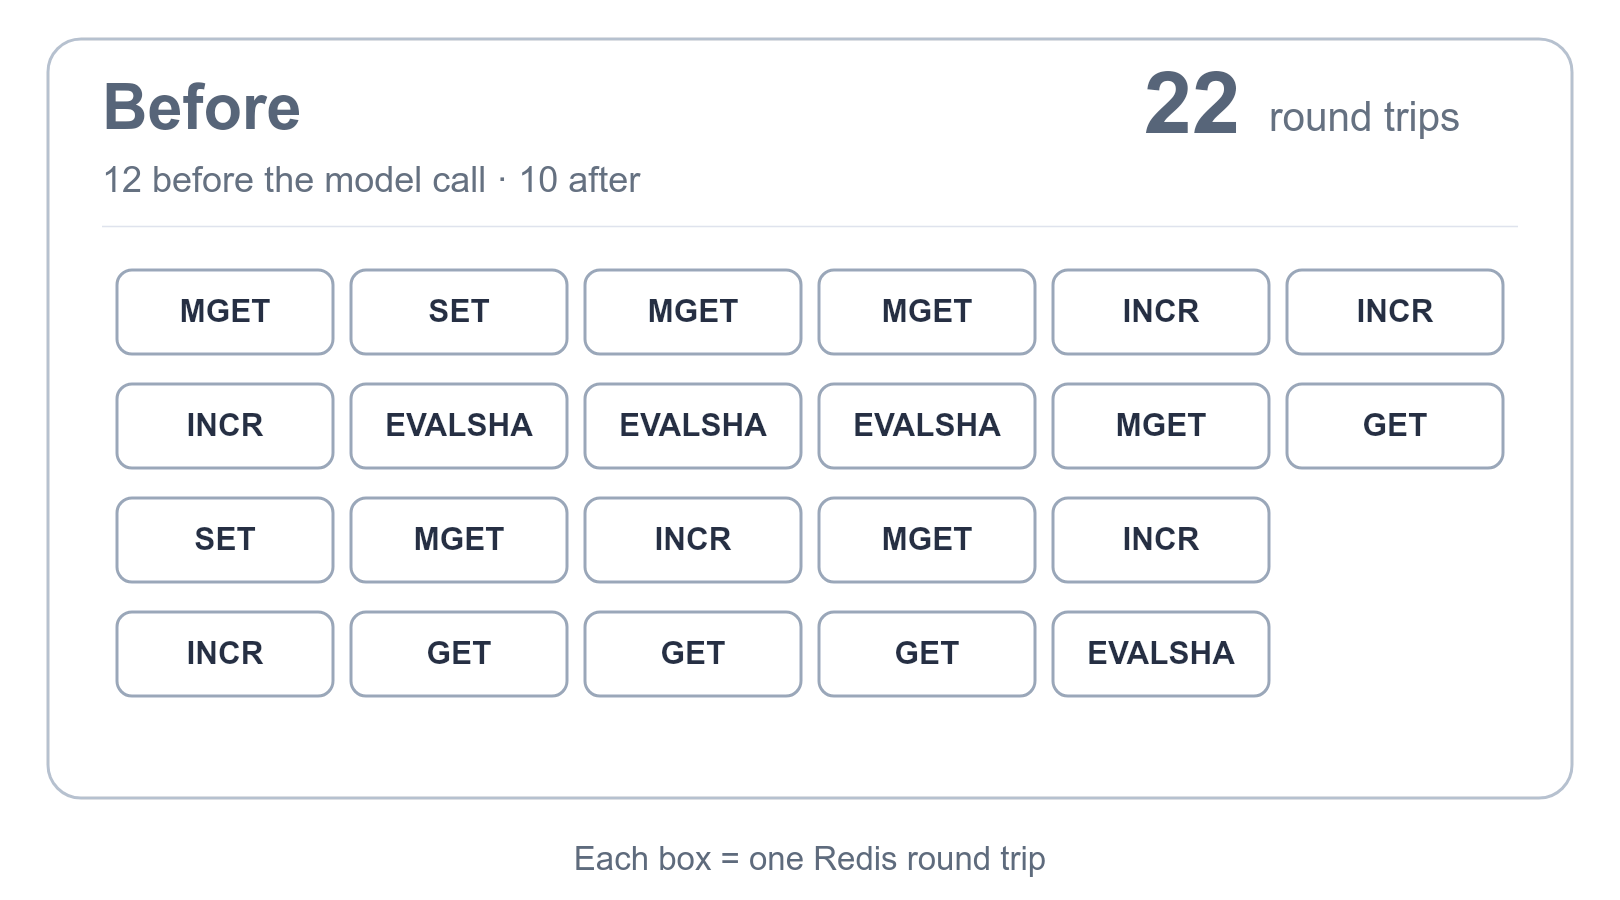
本週,我們將 LiteLLM proxy 上一個請求等待 Redis 的次數從 22 次降到 8 次。
一個來自具有預算之金鑰、位於具有預算與 TPM/RPM 限制之團隊、針對採用依使用量路由與 Redis 回應快取之模型群組的請求,原本會造成 22 次 Redis 往返:模型呼叫前 12 次、之後 10 次。相同的請求、相同的檢查與相同的寫入,現在只需 前 5 次、後 3 次。
本週,我們將 LiteLLM proxy 上一個請求等待 Redis 的次數從 22 次降到 8 次。
一個來自具有預算之金鑰、位於具有預算與 TPM/RPM 限制之團隊、針對採用依使用量路由與 Redis 回應快取之模型群組的請求,原本會造成 22 次 Redis 往返:模型呼叫前 12 次、之後 10 次。相同的請求、相同的檢查與相同的寫入,現在只需 前 5 次、後 3 次。

日期: 2026 年 9 月 7 日至 2026 年 9 月 9 日
受影響版本: v1.100.0
嚴重性: 中等(單一客戶的生產環境中斷;影響範圍小,且需要無法連線的 Redis)
狀態: 已在 v1.100.1 中修正
注意: 如果您正在執行
v1.100.0,請升級至v1.100.1或更新版本。v1.99.1及更早版本不受影響。v1.100.0dev 與 rc 預發行版本、v1.101.0-dev.1,以及v1.101.0-dev.2都存在相同缺陷;v1.101.0-rc.1及更新版本不受影響。
在 2026 年 9 月 7 日至 2026 年 9 月 9 日期間,一位在 nginx 後方執行 litellm-database:v1.100.0 的企業客戶,經歷了其 proxy 叢集中兩波核心 OOM kill:依客戶統計有數十次 kill,某個 worker process 的 RSS 達到 61 GB,而平台停機期間則出現數千次 HTTP 502 與數萬次 HTTP 499。
這必須同時滿足兩個條件:客戶流量所使用的提供者持續失敗,因此 router 不斷重試;同時 Redis 無法連線,因此每個完成的請求都會將那些重試的累積結果完整記錄下來。重試之所以無界增長,是因為 PR #38133(8 月 24 日)的一行變更,將重試麵包屑——router 為每次失敗的 LLM 嘗試保留的紀錄——在儲存前先經過一個既有的憑證遮罩 helper。這個 helper 對其原始輸入是正確的,但它假設自己是在複製一棵普通樹;麵包屑不是樹,它包含一個指回即將被追加到其中的同一個 list 的指標。若在不保留該共享參照的情況下複製它,就會把自 2023 年 12 月以來在記憶體中成本為零的結構,變成每次重試都大約加倍的結構;直到一個成本追蹤錯誤處理器在 Redis 中斷期間,於每個請求上都把它轉成 log 字串,而單次配置最終達到 27 GB。
我們在 PR #39491 中修正了底層成長問題,該 PR 於 9 月 3 日合併,並納入 v1.101.0-rc.1。該修正未在兩天後該版本被標記為 stable 之前回補到 v1.100.0。我們於 9 月 9 日將其回補到 stable/1.100.x(PR #40455),並發布 v1.100.1。
我們完全承擔這個結果。這個缺陷以我們本可發現的形式存在;在 stable release 前三天提交的一張 ticket 正確指出同一段程式碼路徑中的成長問題,而我們自己的修正 PR 又把那張 ticket 中一個未經測試的推測,變成了明確陳述的事實。本文其餘部分會說明這些事情是如何發生的,以及我們正在做哪些改變,確保這類缺陷不會再以同樣方式進入 stable release。


一個與 LiteLLM 共同完成的除錯故事,以及後續的發行測試。
LiteLLM 版本升級暴露出一個長期存在的 Redis 設定錯誤,讓 Pfizer 的 gateway 吞吐量降低了約 48%,而應用程式記錄中完全沒有 HTTP 錯誤。以下說明團隊如何透過設定二分搜尋將其隔離出來,以及雙方正在建立的測試基礎架構,目的是在這類回歸上線前就先捕捉到。
最後更新:2026 年 4 月
企業級 AI 閘道部署將 Redis 放在幾乎每個請求的熱路徑上:速率限制、快取查詢、支出追蹤。當 Redis 正常時,延遲影響僅有個位數毫秒,終端使用者幾乎察覺不到。當它劣化時,正式環境中的 AI 閘道就必須不受影響地持續運作。
在 100+ 個 Pod 上大規模執行 LiteLLM,意味著必須在失敗模式出現之前先為其設計。簡單的情況是 Redis 完全當機:快速失敗,回退到資料庫,繼續提供請求服務。困難的情況,也是會拖垮閘道的情況,是 緩慢 的 Redis:仍然接受連線、仍然回應,但每次操作都會在 20 到 30 秒後逾時。