Public Benchmarks
這些貼文會使用真實的提供者 API 及其設定來發布量測結果。JEV 分類器比較會直接計時分類器,並包含單獨的即時 proxy 檢查。以下數字皆 उद्ध自這些貼文
JEV 分類器:速度比 Haiku 快 5.43 倍,成本低 96%
在 2026-09-18,TypeSafe jev-1.13.0 與 anthropic/claude-haiku-4-5-20251001 分類了相同的 80 個人工撰寫合成案例,進行三次成對重複,且並行數為 1
| 指標 | JEV | Haiku |
|---|---|---|
| 與人工撰寫的預期層級一致 | 95.00% (228/240) | 73.75% (177/240) |
| p50 分類器延遲 | 126.81 ms | 688.40 ms |
| p95 分類器延遲 | 231.16 ms | 896.94 ms |
| 登錄定價的分類器成本,240 次呼叫 | $0.007706664 | $0.198534 |
| 提供者錯誤 / 逾時 / 備援 | 0 / 0 / 0 | 0 / 0 / 0 |
JEV 依中位延遲分類請求的速度比 Haiku 快 5.43 倍,依 p95 則快 3.88 倍,且登錄定價的分類器成本低 96.12%。兩個分類器之間的層級一致率為 78.75%,這是與人工撰寫標籤匹配度不同的獨立指標。八個邊界案例的匹配率差異區間包含零
這些結果是在此語料庫上量測分類器,並使用共享的自訂準則與明確的上下文設定。請求、層級定義、指示與上下文都可能改變任一分類器的匹配率。預期標籤未經獨立審查,亦未評估其他分類器提示詞。這些結果無法證明一般分類準確度、下游回答品質、發票節省,或在並行負載下的效能。獨立的 gateway 檢查對每個層級都使用相同的下游模型,因此無法證明切換完成模型所帶來的節省
閱讀方法、各層級結果、不確定性與限制,或 下載已封存的證據與重現腳本
Terminal-Bench 2.0:以低 27% 成本達到 Opus 級品質
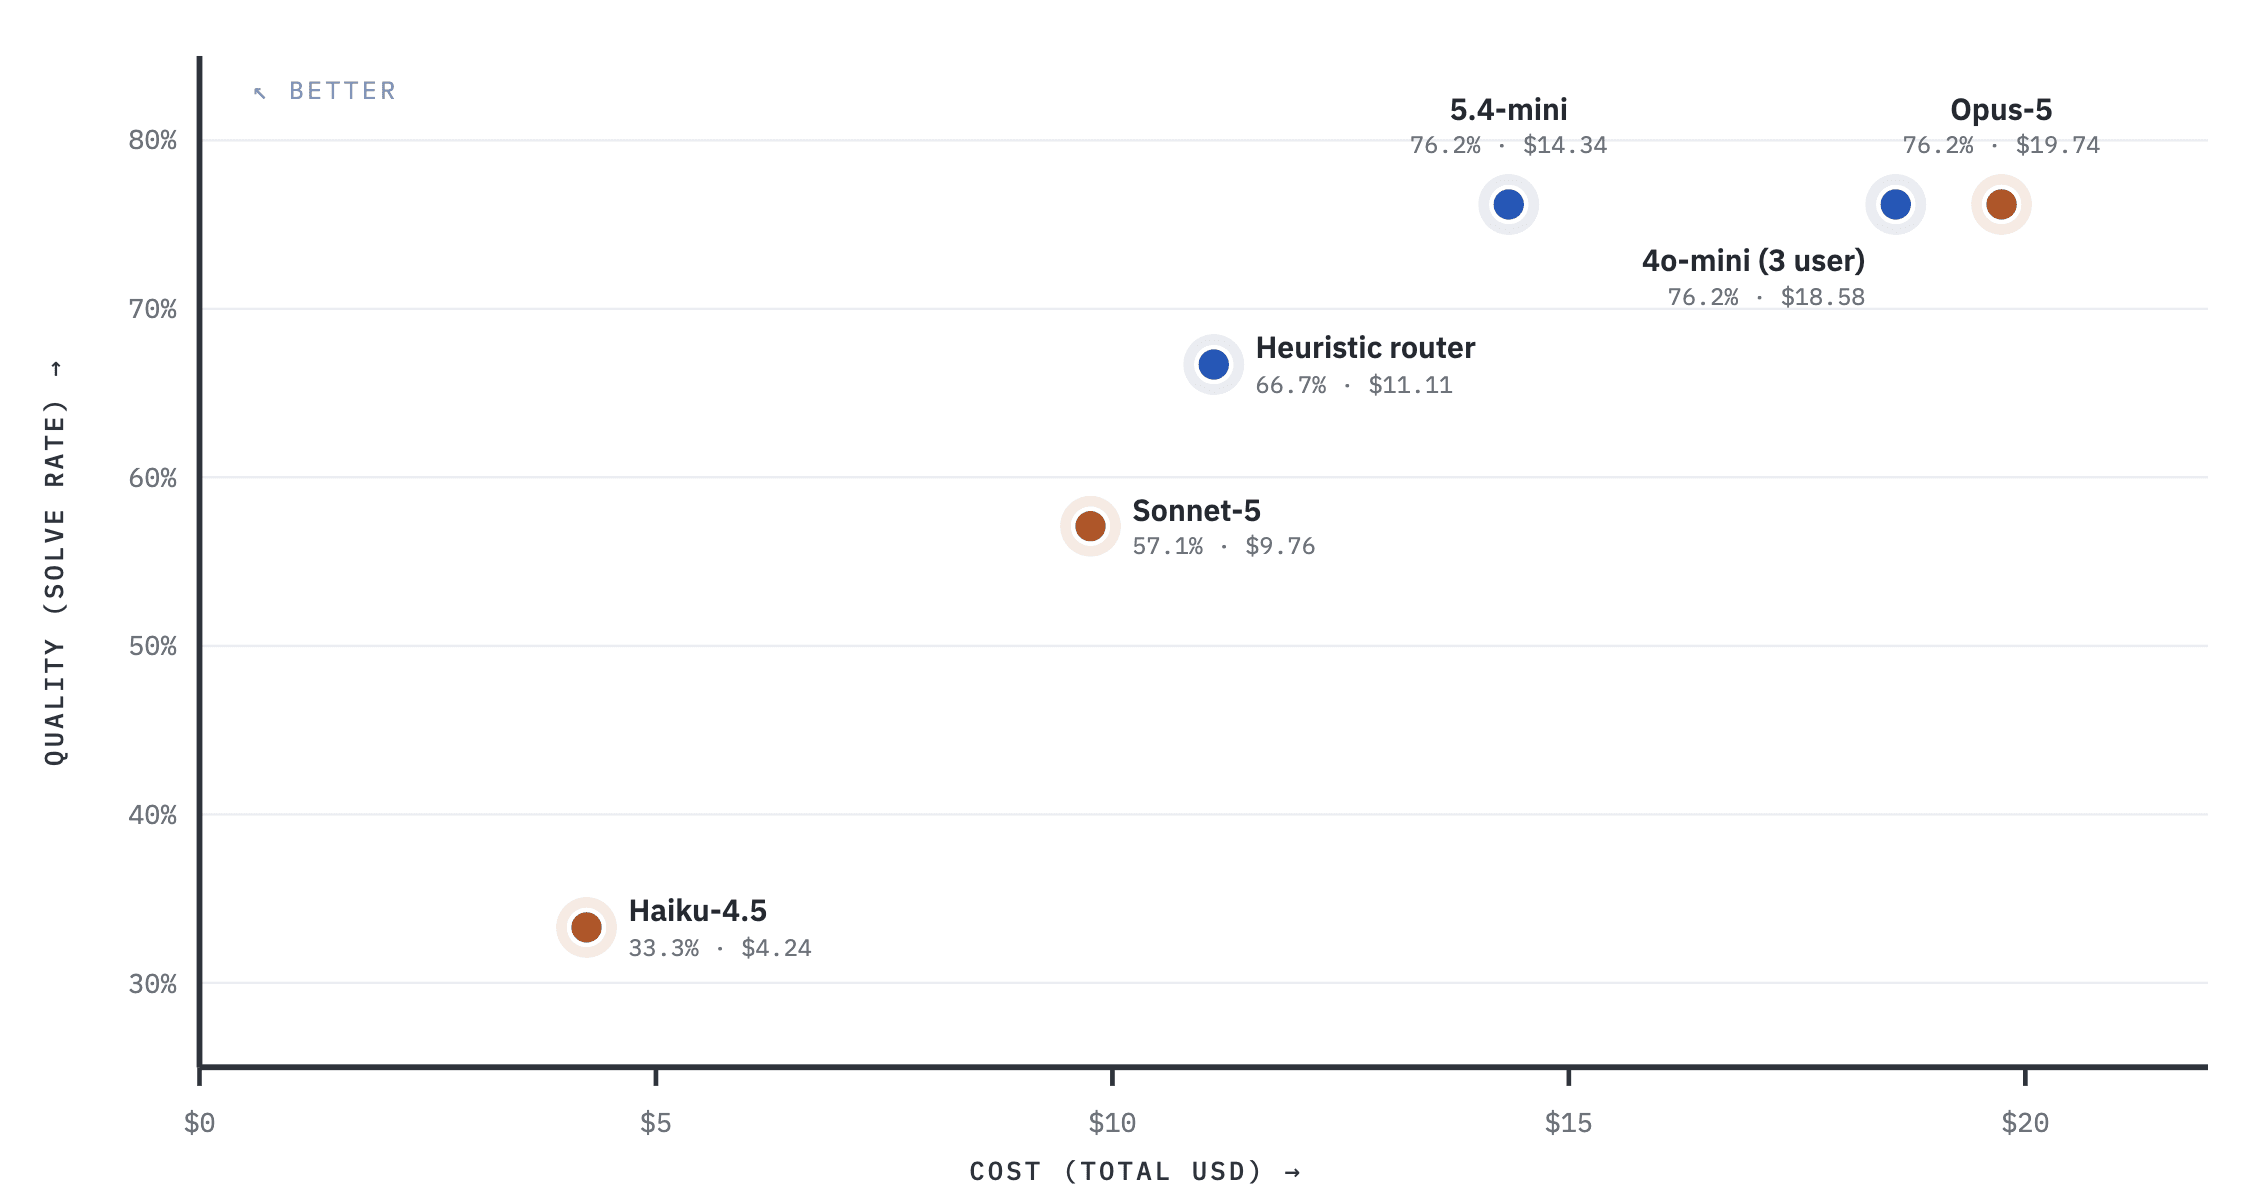
- 16/21 solved 由路由器與 Claude Opus-5 單獨完成。解題率相同。
- $14.34 vs $19.74 總成本。低 27%。
- 分類器:gpt-5.4-mini 僅讀取目前訊息。
- 將上下文擴展到最近 3 則使用者訊息:解題率 66.7% 到 76.2%,成本 +44%。
- 將助理回覆加入分類器可見範圍:品質下降、成本上升。已發布的預設值不包含這些內容。
Auto Router:以最高低 27% 的成本達到 Opus 級品質
依上下文視窗、路由器對比各單一模型,以及精確設定的完整結果。
介紹 LiteLLM Fusion:比 Fable 5 多解出 56% 的任務
相同 21 項任務、三個模型並行再加上一個綜合器:+36% 花費、每個已解任務低 12%、turn 延遲 5 倍。
Heuristic v2:多解出 27% 的任務,且每個任務成本低 45%
| 分類器 | 解題率 | 已解/21 | 總成本 | $/已解 | 平均呼叫延遲 | p90 呼叫延遲 | 任務中位時間 |
|---|---|---|---|---|---|---|---|
| Heuristic v2 | 66.7% | 14/21 | $9.78 | $0.70 | 13.1s | 30.7s | 7m08s |
| Heuristic v1 | 52.4% | 11/21 | $14.06 | $1.28 | 14.5s | 34.1s | 8m53s |
- 相同的 21 項 Terminal-Bench 2.0 子集、相同層級,只有
classifier_type不同。 - 請求路徑上沒有 LLM 分類器呼叫。以評分後的回應資料預先訓練,因此沒有冷啟動。
- 輸入 token 中有 87% 是快取讀取,v1 則為 82%:更穩定的層級選擇代表更少的快取遺失。
- 在 933 次 LLM 呼叫中,兩個分支都沒有請求失敗。
- 以
classifier_type: heuristic_v2啟用。
六項公開基準與 RouterArena:便宜 40% 到 75%
| 評估 | 樣本 | 相較全用 Opus-5 的成本 | 相較前沿模型的品質 |
|---|---|---|---|
| 六項公開基準、即時 proxy | 220 個評分後提示 | 便宜 40.4% | 97.1%(通過率 91.8% 對 94.5%) |
| RouterArena | 8,399 次查詢 | 便宜 74.5% | 87.3% |
| WildChat-1M 模擬 | 12,000 段對話 | 便宜 64.9% | 未測量 |
| DevGPT 模擬 | 2,056 段對話 | 便宜 65.4% | 未測量 |
| 經過程式碼篩選的 WildChat | 993 段對話 | 便宜 20.0% | 未測量 |
分類器上下文:追問一致率 14% 到 78%
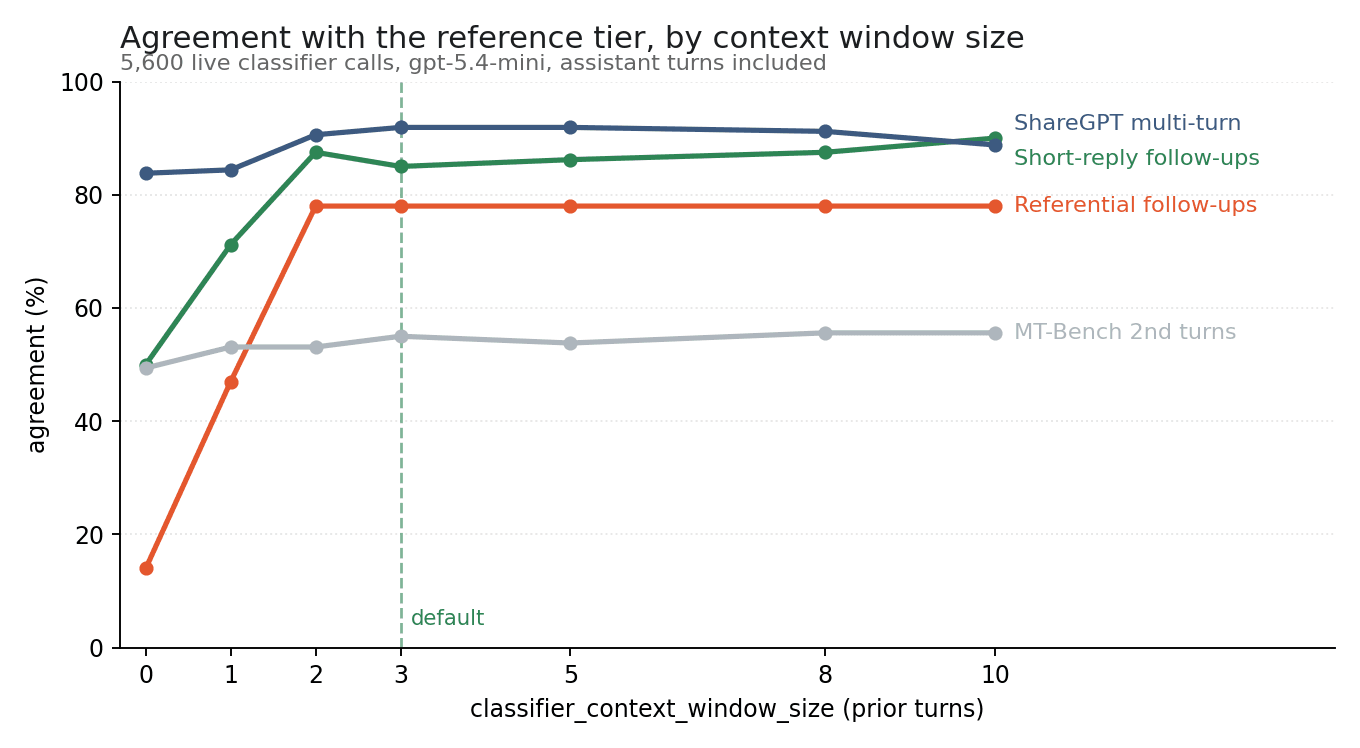
- 5,600 次即時分類器呼叫。
- 只需根據歷史記錄才能解決的追問一致率:0 turn 時 14%、1 turn 時 47%、2 turn 時 78%,一路持平到 10。
- 分類器成本:每 1,000 次請求最多 $0.61。
- 相較於不使用上下文的延遲差異:每個 95% 區間都包含零。
- 已發布預設值:前 3 則使用者 turn,每則 200 字元,不包含助理 turn。
正式部署:272,876 次請求共節省 51%
- 450+ 名使用者,開發、預備與正式環境,2026-04-15 到 2026-08-09。
- 272,876 次請求,7.08B tokens。
- $11,736 花費 vs $23,985 只用旗艦模型的反事實:節省 $12,249、51.1%。
- 隨著層級對照表調整,節省率從第一個完整月的 42.9% 上升到最後一個月的 60.7%。
- 95% 的請求從未到達旗艦層級。
陰影評估:88.1% 與目前模型相符或更好
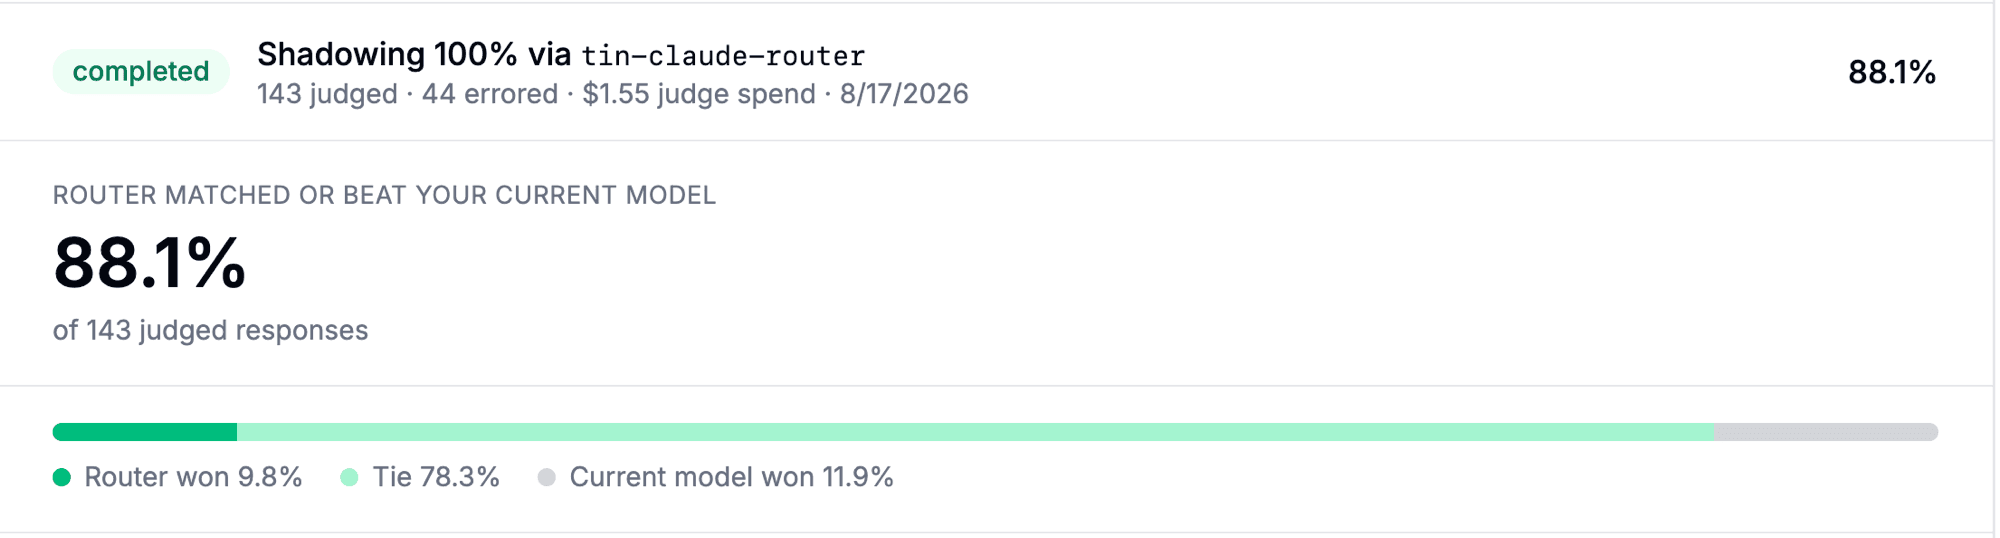
- 在任何面向使用者的回應改變之前,先對我們自己的即時 gateway 流量進行盲測 LLM 裁判。
- 143 個經判定回合、$1.55 裁判花費。
- 路由器勝出 9.8%,平手 78.3%,目前模型勝出 11.9%。
- 如何在您的流量上執行: 在您的流量上評估。
提示快取:比僅快取便宜 37% 到 69%
- 五個資料集,包括具有提供者自身快取計費的即時 gateway 流量。
- 路由器加快取在每個資料集上都勝過只快取單一固定模型。
- 完整內容: 提示快取。

