評估您的流量
公開基準測試衡量的是他人的提示。這裡有兩個功能衡量您的提示:在切換前進行的 shadow 評估,以及切換後的 節省帳務。
Shadow 評估
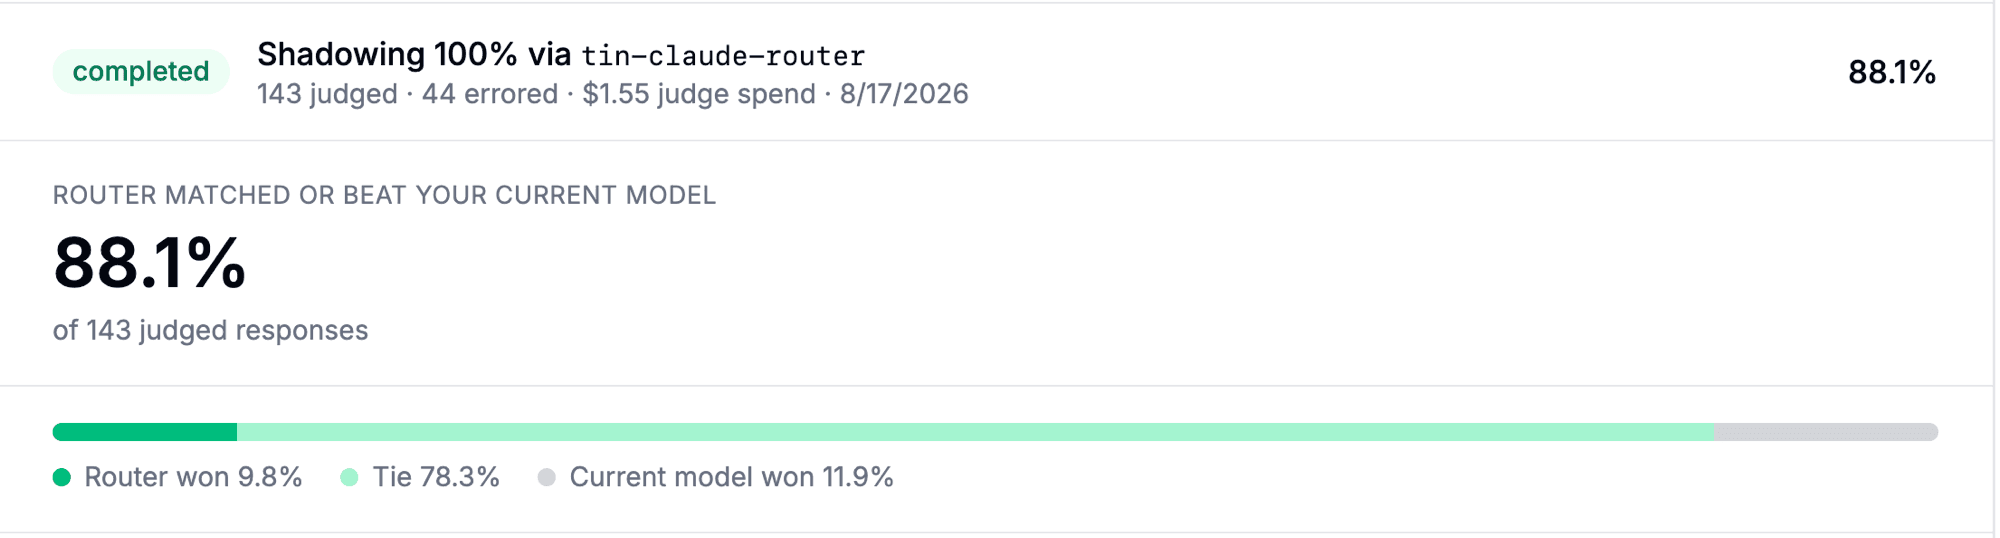
- 取樣 單一金鑰、團隊或使用者的部分即時流量。
- 透過路由器複製 每個取樣的請求。shadow 回應永遠不會送達用戶端。
- 以盲測方式判定:由 LLM 比較路由器的答案與目前模型提供的答案。
- 執行 最長 30 天(預設 7 天),或直到每個目標自己的 shadow 與判定支出達到
max_budget(預設 $10,最高 $10,000)。max_turns已不再接受。 - 在同一個作業中比較 多個路由器設定,且使用相同的取樣流量,因此階層對應表與分類器選擇會在任何變更之前定案。
- 在我們自己的流量上:88.1% 與目前模型相符或更好,143 個判定回合,$1.55 的判定支出。
Shadow 評估:在您自己的正式流量上測試 Auto-Router
設定作業、回合與持續時間的預設值、選擇判定器、閱讀結果卡片。
依內容大小與模態進行路由
多設定 shadow 作業,以及金鑰、團隊和使用者目標。
在您自己的提示上評估 JEV
先從 Test Routing 開始檢查階層選擇,然後使用 shadow 評估來比較實際回應。與您的階層標籤相符的分類器,並不能證明所選模型的回應表現良好。請先固定您的評分標準與標籤,再將 JEV 與另一個分類器比較,並將分歧與正確性分開報告
JEV 基準 量測的是在人工建立的合成案例上的分類器延遲與依註冊表定價的分類器成本。若要評估某個部署,請納入分類器支出、下游 completions、已啟用時的 embeddings,以及 shadow/judge 請求。請記錄備援率與 p95 延遲,以及成功請求的平均值
JEV 會記錄一個透過父請求 metadata 歸因的獨立 typesafe/<model> 分類器呼叫。其 classifier_cost 也會在成功的 JEV 路由決策中一併帶入,並在回報的路由器節省中扣除。該 metadata 已描述了已另外記錄的分類器費用:在加總支出列時,請勿再次計入。若缺少使用量或缺少註冊表項目,分類器成本便無法得知,而取消也不能證明提供者未收費
切換後的節省
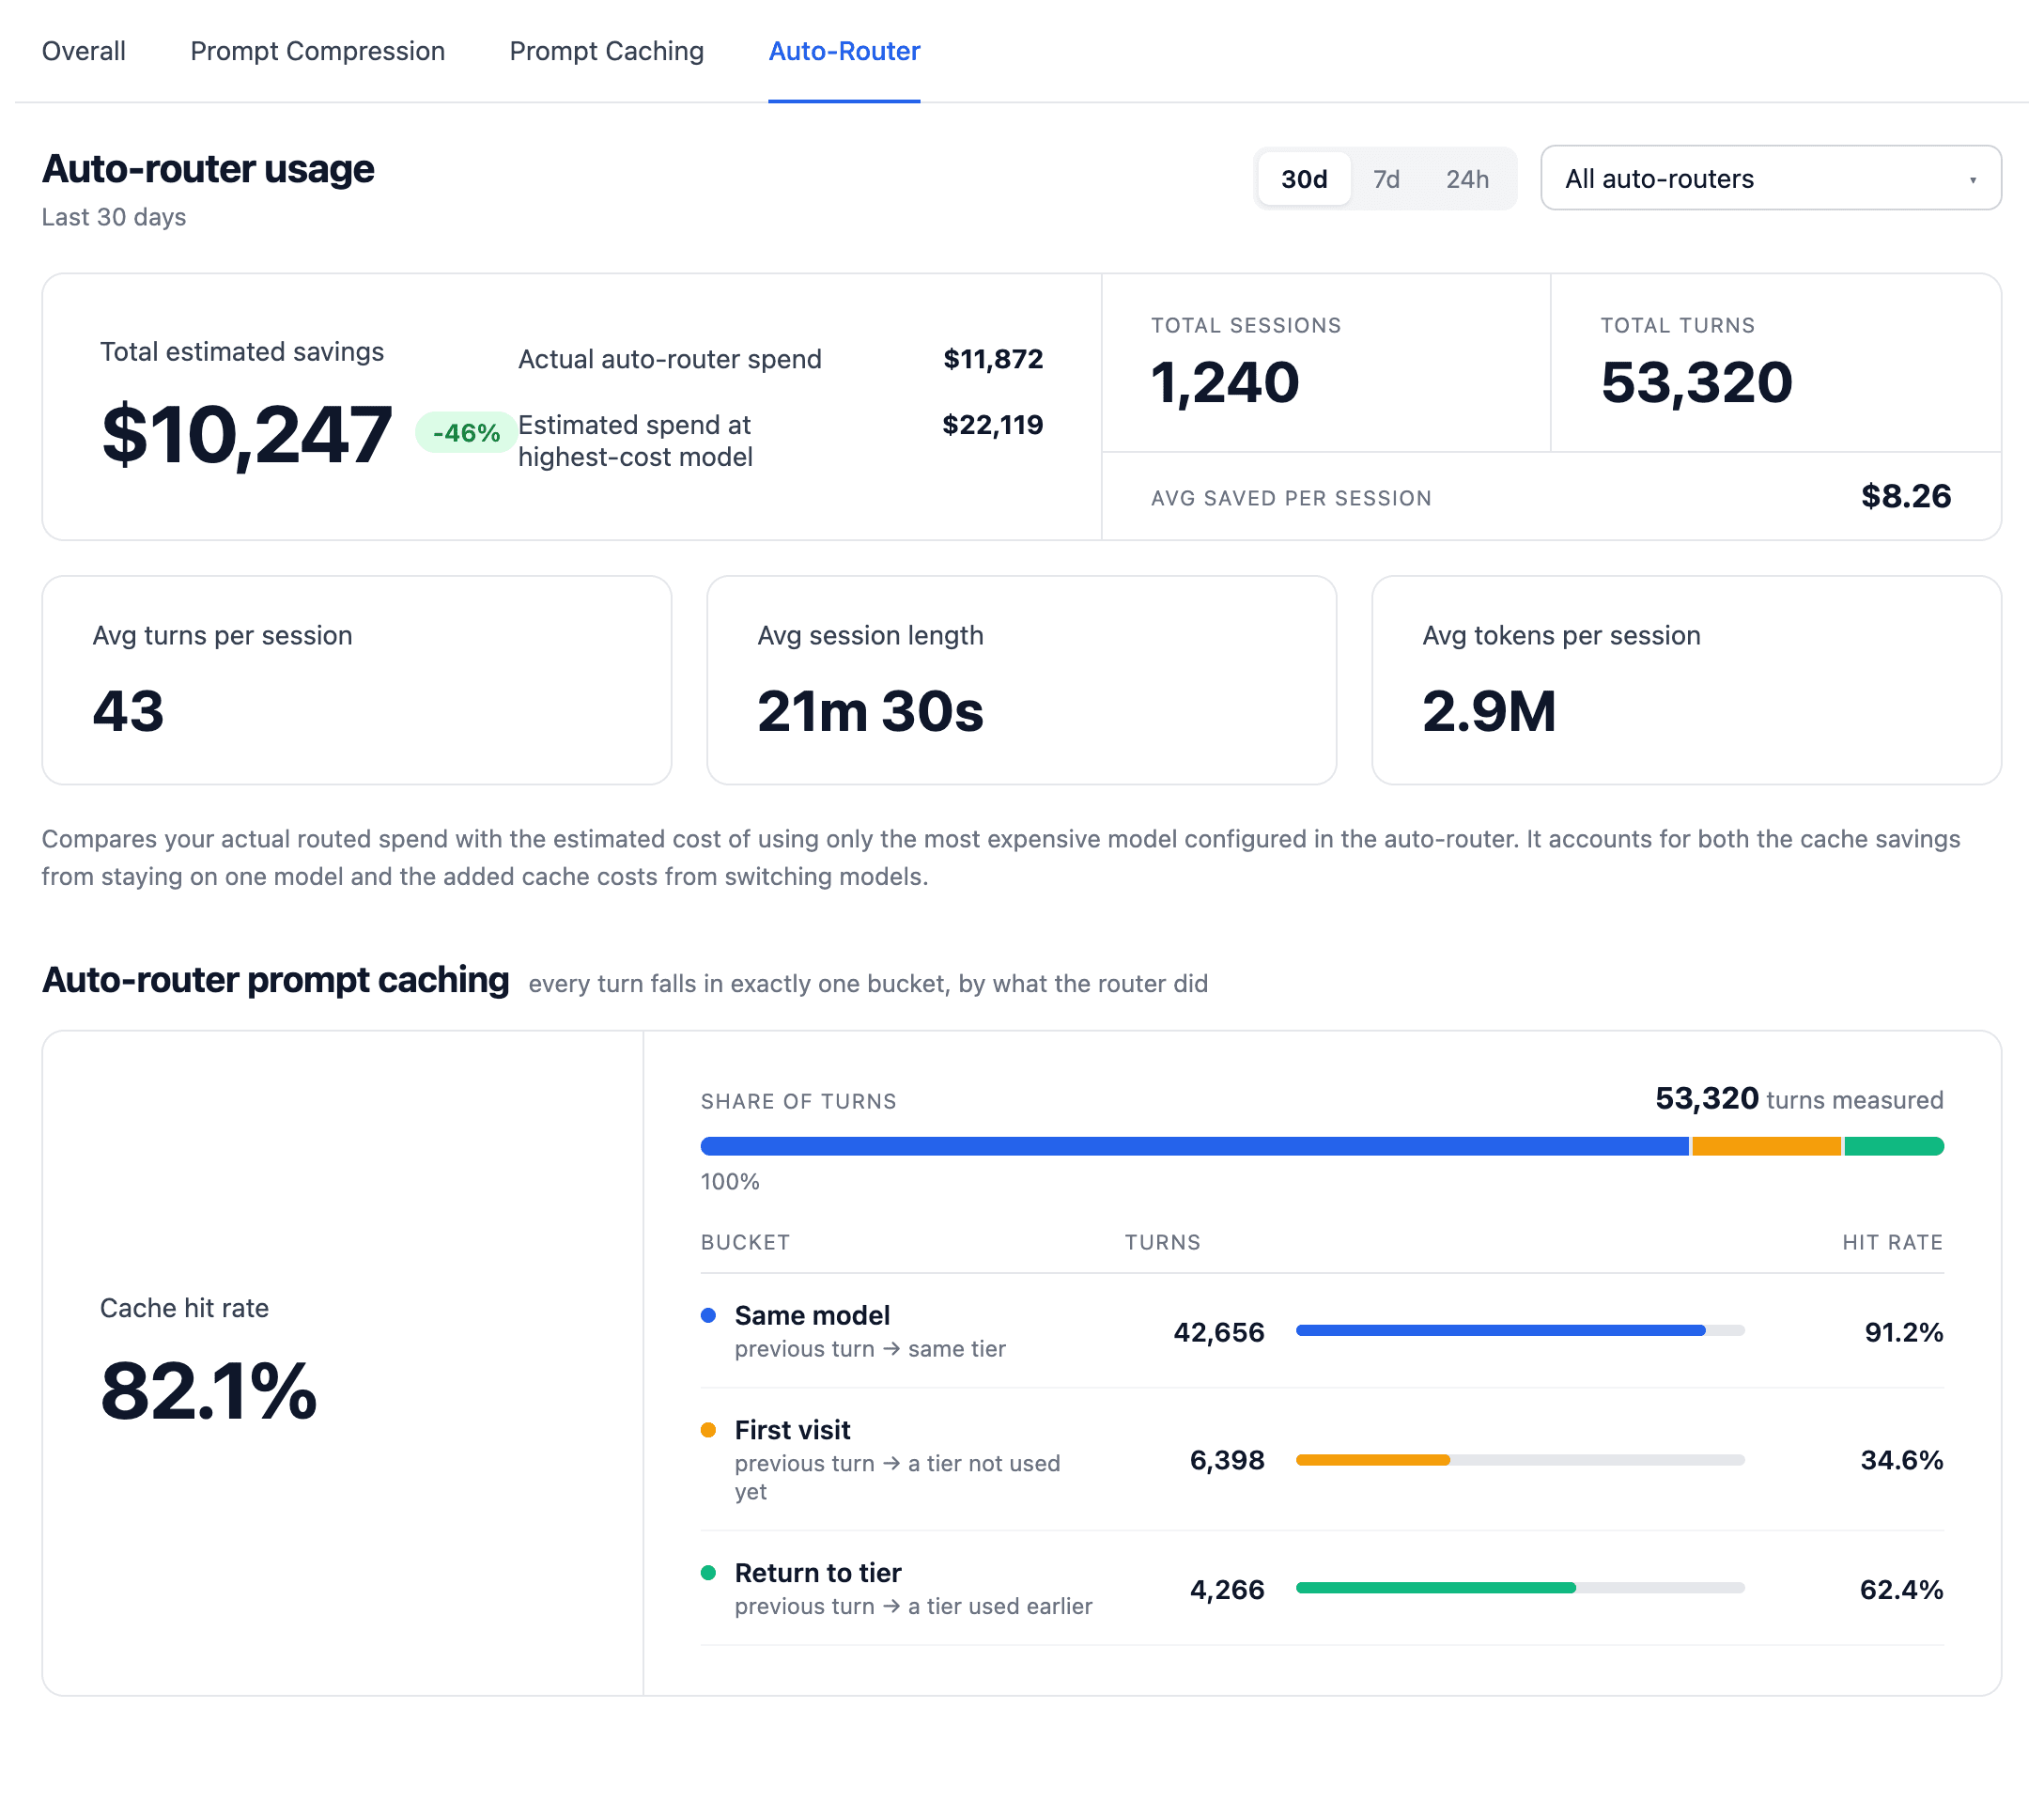
- 每次請求: 路由器選了什麼、原因是什麼,以及同一請求若使用在最困難已設定階層中的最昂貴模型會花多少。扣除任何分類器呼叫後的差額會標記在請求上。
- 彙總: 到每日支出表中,因此會依金鑰、團隊、標籤與組織顯示。
- 使用量分頁: 預估總節省、sessions 與 turns、依回合類型區分的提示快取命中率。30 天視窗、超過 40 萬個 sessions 的讀取時間為 38 ms。
- 分類器成本: 當有記錄分類器成本時,會在
x-litellm-classifier-cost標頭中回傳每次請求的成本,包括成功的 JEV 分類。 - 誠實基準: 對持續中的回合,以溫熱快取定價;切換後若有新的快取寫入,會計入節省的反面,因此單一請求可能顯示為負值。公式與所有呈現處:Reported savings。
讀取單一決策
- 記錄中每個已路由請求都會以 routing-decision 卡片開頭:階層、原因(包含
jev_classifier),以及提供服務的模型 - Add Model 表單中的 Test Routing 會顯示相同卡片,因此某個出乎意料的正式環境決策,可以用相同提示在表單中重現。

