自訂您的分類器
Auto Router 的分類器會決定哪個 tier 應處理一則請求。
選擇分類器
Heuristic v2、自訂評分、自訂 tiers/指示,以及預測模式皆遵循閘道顯示的授權額度。請查看 View limits,而非假設停用的選項代表缺少功能。內建 v1 與內建 OSS 分類不需要授權。v2 鏈會消耗與獨立 v2 路由器相同的 v2 授權額度。
找到控制項
從最符合您流量的分類器開始,測量其決策,然後調整其門檻、context 或指示。指派給所選 tier 的模型會生成答案;judge 模型只負責做出路由決策。
本指南將儀表板控制項與其 config.yaml 對應項配對說明。內容先涵蓋分類,接著是可覆寫或重用決策的路由規則。初始部署請參閱 Admin Setup;衡量品質與節省請參閱 Evaluate。
截圖顯示的是 LiteLLM #44928 中更新後的編輯器,使用的是本機示範路由器。獨立的調校區段與可選擇的 v1/v2 本機 heuristic 需要包含該變更的閘道與儀表板版本。請勿假設較舊版本會提供這些控制項或接受 local_heuristic。
範例描述的是該實作。預設值可能會在不同版本之間變更;保留未設定的可選項目會沿用您已安裝版本中的預設值。截圖中的模型名稱是示範部署別名,不是提供者模型 ID。
開啟 Models + Endpoints > Auto-Routers > Add Auto Router。若是已儲存的 router,請開啟其列並選取 Edit Auto Router。選擇 What classifies your requests?,指派 tier 模型,然後展開 Advanced settings。
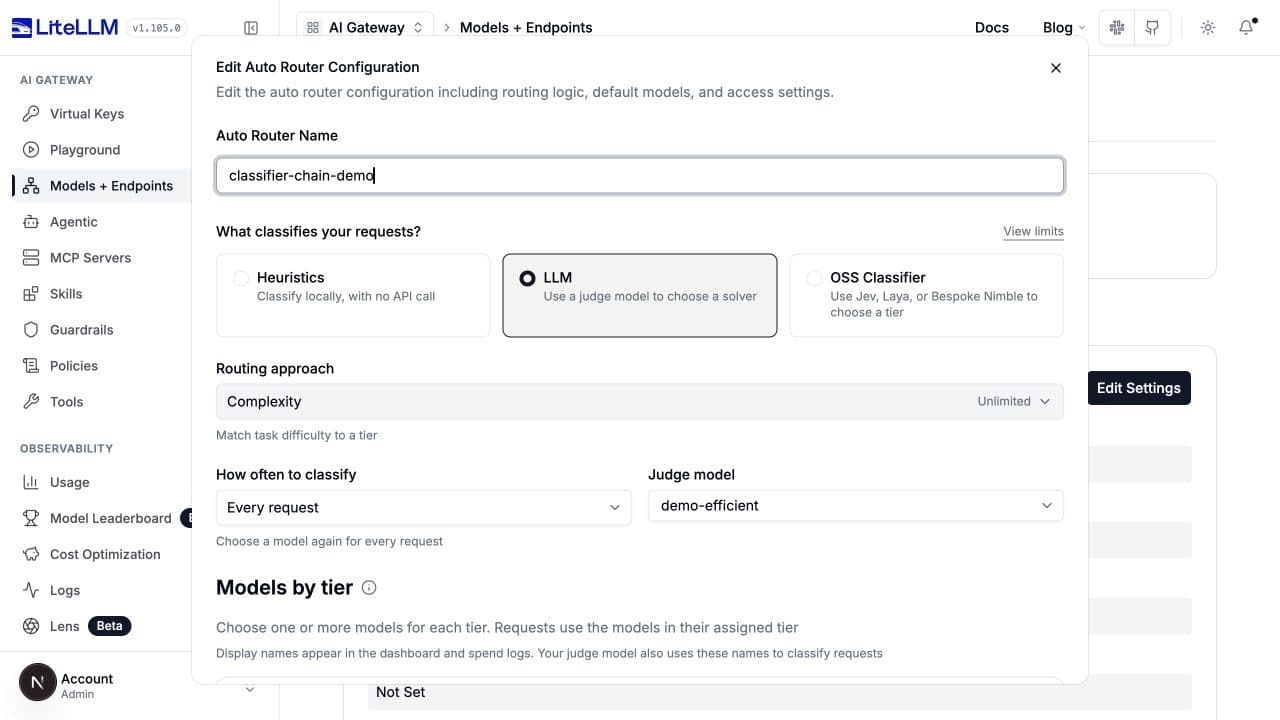
對於 LLM 複雜度 router,Local checks before the judge 會選擇鏈。Heuristic tuning 包含所選本機評分器的設定,而 LLM tuning 包含 judge 設定。Always use the judge 會隱藏 heuristic tuning。OSS 提供者使用獨立的 Classifier tuning 區段。
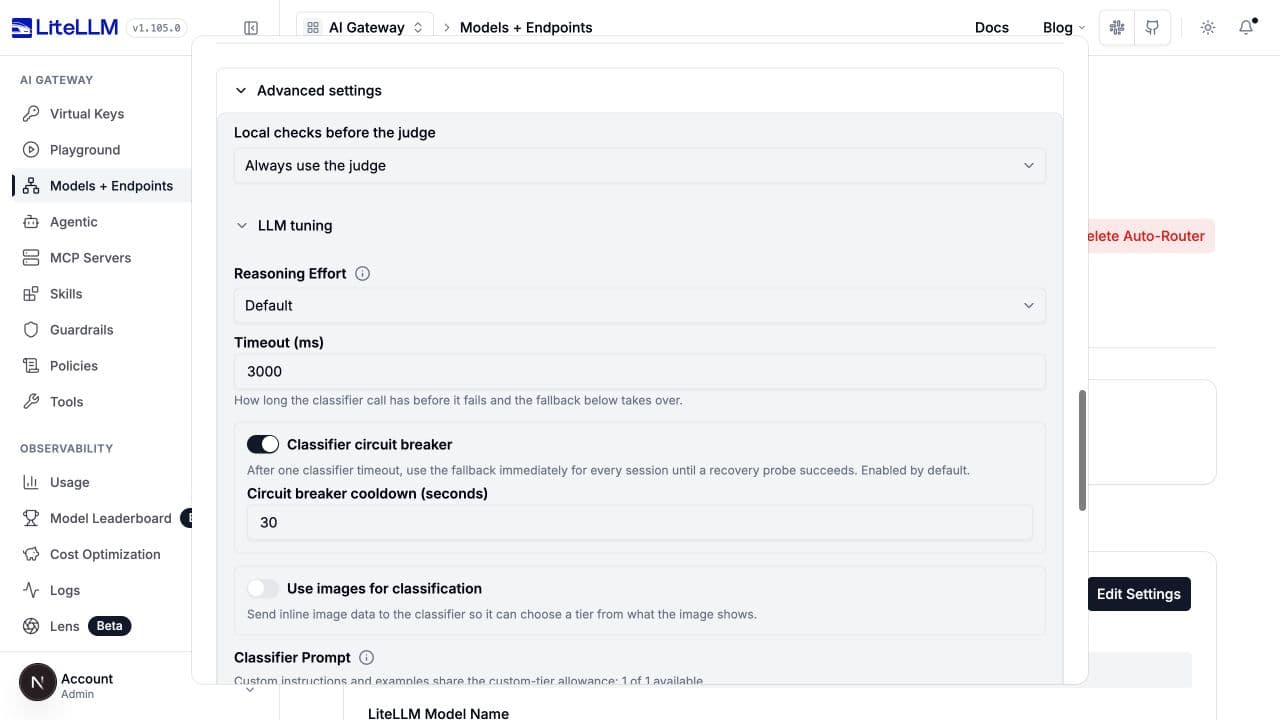
Always use the judge 會停用 local-first 階段。它不會停用關鍵字覆寫、session 重用,或在 judge 失敗後的 heuristic 恢復。切換模式可能會保留未啟用的調校值;它不會重設所有設定。
從完整設定開始
以下所有設定都應放在 model_list[].litellm_params.complexity_router_config 內,除非明確標示為其他位置。complexity_router_default_model 是 litellm_params 下的同層項目。
此範例對應 heuristic-first v2 截圖:0.6 成功率門檻與 MEDIUM 本機上限。這些數值用於說明控制項;在採用之前,請先以您自己的流量進行評估。
model_list:
  - model_name: demo-efficient
    litellm_params:
      model: openai/gpt-5.6-luna
      api_key: os.environ/OPENAI_API_KEY
  - model_name: demo-capable
    litellm_params:
      model: openai/gpt-5.6-terra
      api_key: os.environ/OPENAI_API_KEY
  - model_name: classifier-chain-demo
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_default_model: demo-efficient
      complexity_router_config:
        tiers:
          SIMPLE: demo-efficient
          MEDIUM: demo-efficient
          COMPLEX: demo-capable
          REASONING: demo-capable
        classifier_type: heuristic_first
        local_heuristic: heuristic_v2
        heuristic_first_max_tier: MEDIUM
        heuristic_v2_success_threshold: 0.6
        classifier_llm_config:
          model: demo-efficient
          timeout_ms: 3000
          classification_rubric: agentic
        classifier_fallback: heuristic
        classifier_context_window_size: 3
        classifier_context_budget_chars: 8000
在閘道上設定 OPENAI_API_KEY,啟動 litellm --config config.yaml,並將用戶端請求送至 model: classifier-chain-demo。tier 值與 judge 的 model 必須命名已部署的模型群組。judge 可以與求解器共用一個 deployment,如上所示,或使用獨立別名。
以下範例是設定片段:請將相應欄位替換到 complexity_router_config 之中,同時保留您已部署的 tier 模型。切換模式時,請移除該模式專屬欄位,不要把每個範例的設定全部累加。
將 heuristic 與 LLM 串接
選取 LLM > Routing approach > Complexity。展開 Advanced settings,選擇 Heuristic first 或 Hybrid,然後選擇 Heuristic before the judge。兩種模式都支援 Heuristic v1 (rule-based) 與 Heuristic v2。
Heuristic first
Decide locally up to 會設定 heuristic 在不呼叫 judge 的情況下可選擇的最高成本 tier。V1 也需要至少一個評分訊號。V2 需要一個符合其成功率門檻的 tier。若 v1 沒有訊號,或 v2 預測中沒有任何 tier 符合條件,較高 tier 的結果會交由 judge。
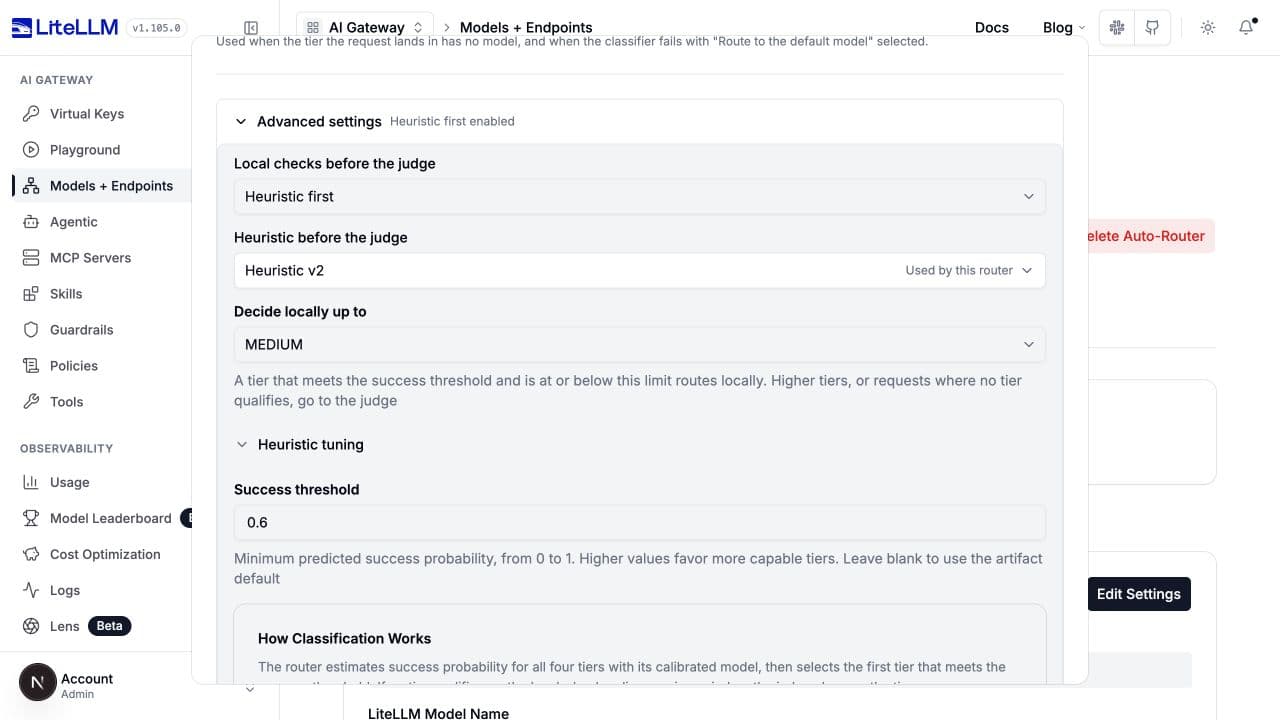
classifier_type: heuristic_first
local_heuristic: heuristic_v2
heuristic_first_max_tier: MEDIUM
heuristic_v2_success_threshold: 0.6
classifier_llm_config:
  model: demo-efficient
  classification_rubric: agentic
將 local_heuristic: heuristic 設為使用 v1,並在下方調整其權重。省略或 null local_heuristic 會保留 v1 行為。heuristic_first_max_tier 在 YAML 中為必填,且必須是已設定、位於最高 tier 之下的內建 tier;UI 初始會選取 SIMPLE。
Hybrid
Hybrid 可接受任何本機 tier。使用 v1 時,Boundary margin 會量測加權分數 tier 邊界的距離。位於任何作用中邊界 margin 內的分數,包括相等,都會交由 judge。沒有任何評分訊號的請求也會交由 judge。
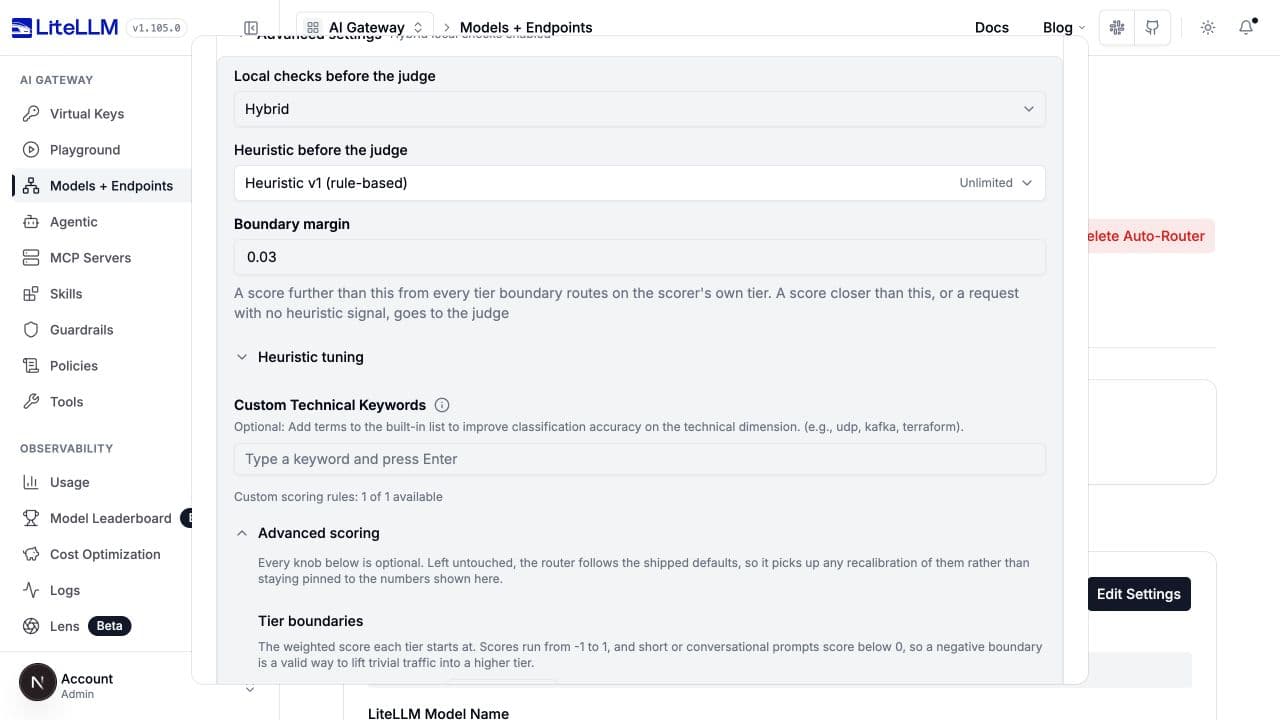
classifier_type: hybrid
local_heuristic: heuristic
hybrid_boundary_margin: 0.03
classifier_llm_config:
  model: demo-efficient
  classification_rubric: agentic
使用 v2 時,標籤會變成 Success threshold margin。只有當最低符合條件的 tier 之機率,以及所有較低 tier 的機率,都與成功率門檻相距超過該 margin 時,才會接受該 tier。若沒有任何 tier 符合條件,則交由 judge。較高 tier 的機率不會影響此邊界檢查。
classifier_type: hybrid
local_heuristic: heuristic_v2
hybrid_boundary_margin: 0.03
heuristic_v2_success_threshold: 0.75
classifier_llm_config:
  model: demo-efficient
  classification_rubric: agentic
hybrid_boundary_margin 在 YAML 中為必填,可接受 0 到 1,且在 UI 中起始為 0.03。較大的 margin 會將更多邊界案例交由下游;0 仍會將精確邊界結果交由下游。不要同時設定 hybrid margin 與 heuristic-first 上限。只有這兩種 chain 類型接受 local_heuristic。
judge 可見的圖片與加密任務會略過本機捷徑。當 judge 發生錯誤時,classifier_fallback: heuristic 會使用所選的本機版本。v2 鏈會以 v2 復原,而不是 v1。
調校 heuristic v1
選取 Heuristics > Rule-based(classifier_type: heuristic),這是 YAML 省略 type 時的預設值。開啟 Advanced settings > Heuristic tuning > Advanced scoring。V1 會使用七個內建維度加上可選的自訂維度,對目前的請求進行評分。它會以文字長度除以四來估算 token;它不會在分類時呼叫 tokenizer 或 LLM。
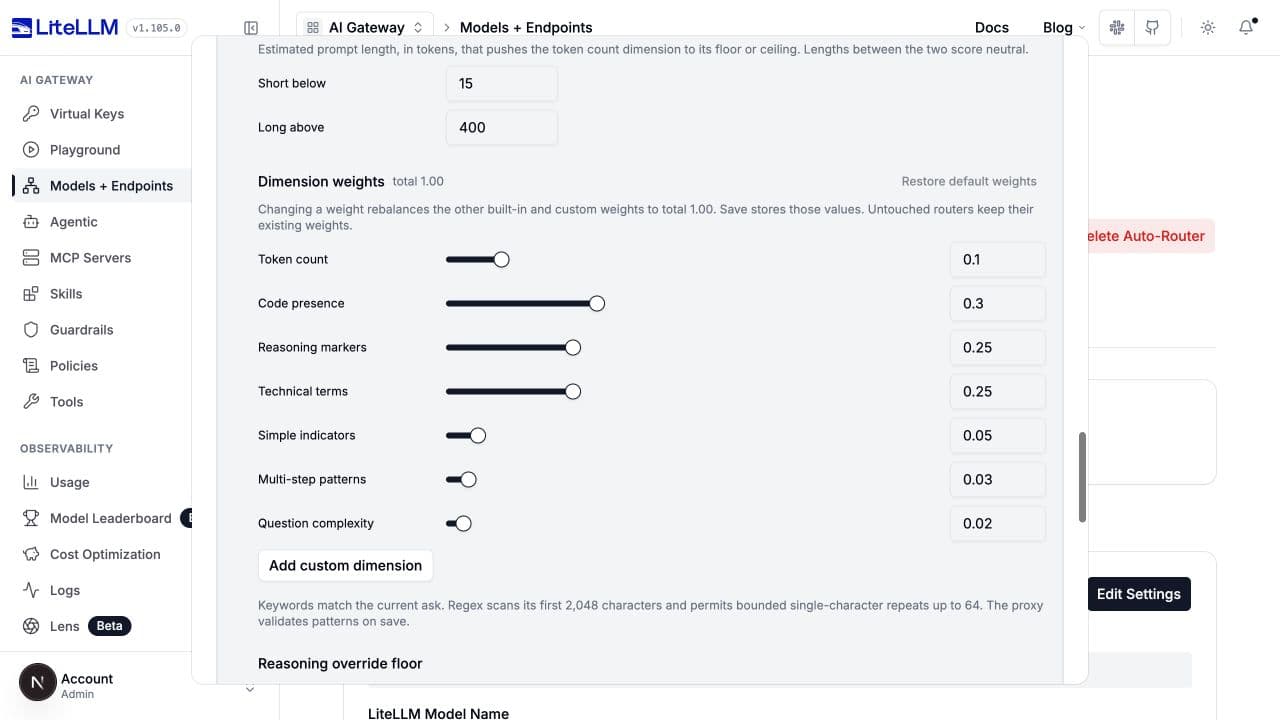
權重、閾值與邊界
| UI 標籤 / 鍵 | 預設出貨值 | 變更後的效果 |
|---|---|---|
Token 數量 / dimension_weights.tokenCount | 0.10 | 變更來自短請求或長請求的貢獻。 |
程式碼存在 / dimension_weights.codePresence | 0.30 | 變更來自程式碼相關詞彙的貢獻。 |
推理標記 / dimension_weights.reasoningMarkers | 0.25 | 變更來自推理片語的貢獻。 |
技術術語 / dimension_weights.technicalTerms | 0.25 | 變更來自技術詞彙的貢獻。 |
簡單指標 / dimension_weights.simpleIndicators | 0.05 | 變更來自問候、定義與其他簡單請求指標的貢獻。 |
多步驟模式 / dimension_weights.multiStepPatterns | 0.03 | 變更來自步驟序列與編號任務的貢獻。 |
問題複雜度 / dimension_weights.questionComplexity | 0.02 | 變更來自多個問題的貢獻。 |
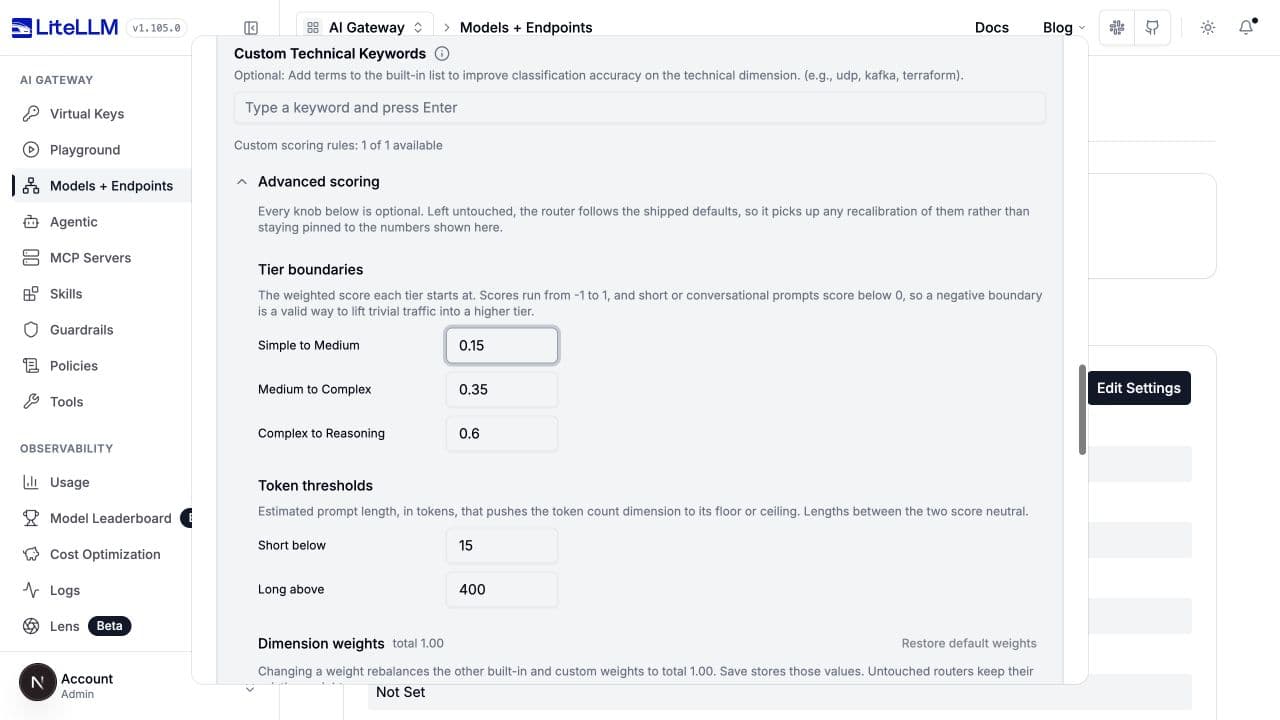
簡單到中等 / tier_boundaries.simple_medium | 0.15 | 低於此值的分數維持為 SIMPLE。降低此值會促進更多請求。 |
中等到複雜 / tier_boundaries.medium_complex | 0.35 | 大於或等於此值的分數至少達到 COMPLEX。 |
複雜到推理 / tier_boundaries.complex_reasoning | 0.60 | 大於或等於此值的分數會達到 REASONING。 |
短於 / token_thresholds.simple | 15 | 低於此估算 token 數量時,token 維度的分數為 -1。 |
長於 / token_thresholds.complex | 400 | 高於此估算 token 數量時,token 維度的分數為 1;介於閾值之間時,分數為 0。 |
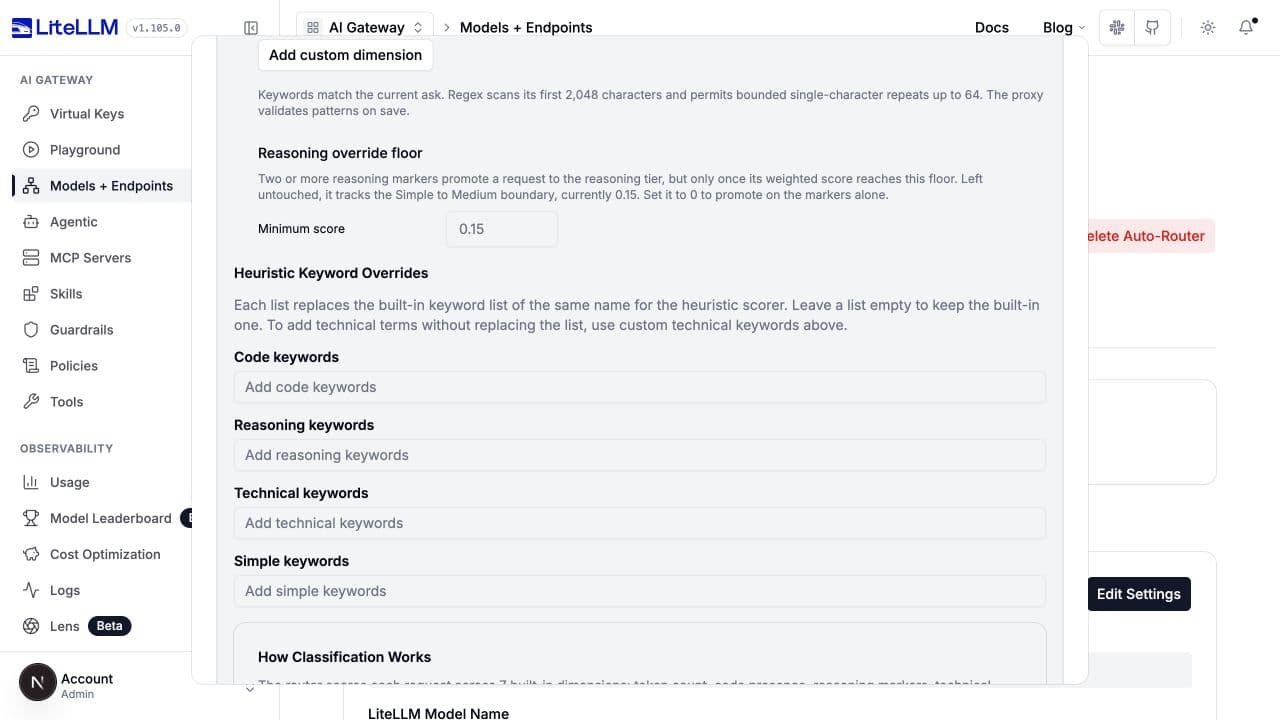
最低分數 / reasoning_override_min_score | 依照 simple_medium | 一旦達到此下限,兩個或以上的推理標記即可提升為 REASONING。0 會恢復僅依標記的提升。 |
UI 接受來自 -1 到 1 的邊界與推理下限,以及非負整數的 token 閾值。請保持邊界遞增,且短閾值低於長閾值。與層級邊界相等時,會選擇較高層級。
在 UI 中變更權重時,會重新平衡其他內建與自訂權重,使總和為 1.00。還原預設權重 會移除覆寫與自訂維度。未調整的控制項會沿用出貨預設值。
在 YAML 中,提供的 dimension_weights map 會取代 該 map:未列出的維度權重為零。若要保留所有維度,請提供全部七個鍵。相較之下,部分邊界與 token 閾值 map 會與其預設值合併。後端不會自動正規化 YAML 權重 map。
層級邊界與 token 閾值控制項
tier_boundaries:
  simple_medium: 0.15
  medium_complex: 0.35
  complex_reasoning: 0.60
token_thresholds:
  simple: 15
  complex: 400
dimension_weights:
  tokenCount: 0.10
  codePresence: 0.30
  reasoningMarkers: 0.25
  technicalTerms: 0.25
  simpleIndicators: 0.05
  multiStepPatterns: 0.03
  questionComplexity: 0.02
關鍵字清單
自訂技術關鍵字 會附加到實際使用的技術清單。啟發式關鍵字覆寫 會取代對應的內建清單。比對不區分大小寫;單字通常使用字邊界,而片語與 CJK 詞彙則使用子字串比對。空白的覆寫清單會保留內建值,而不是停用某個維度。
| UI 標籤 | 鍵 | 預設 / 效果 |
|---|---|---|
| 自訂技術關鍵字 | custom_technical_keywords | 無。附加詞彙,並以不區分大小寫方式去重。 |
| 程式碼關鍵字 | code_keywords | 出貨時的程式碼相關清單;可用您的清單取代。 |
| 推理關鍵字 | reasoning_keywords | 出貨時的推理清單;也提供推理覆寫標記。 |
| 技術關鍵字 | technical_keywords | 出貨時的技術清單;自訂技術關鍵字會附加到此取代內容。 |
| 簡單關鍵字 | simple_keywords | 出貨時的簡單請求清單;可用您的清單取代。 |
custom_technical_keywords: [kafka, terraform, postgresql]
關鍵字覆寫控制項
自訂維度
在 Advanced scoring > Dimension weights 下,選取 Add custom dimension。每一列都有自己的內嵌權重,以及關鍵字或受限 regex 比對器。
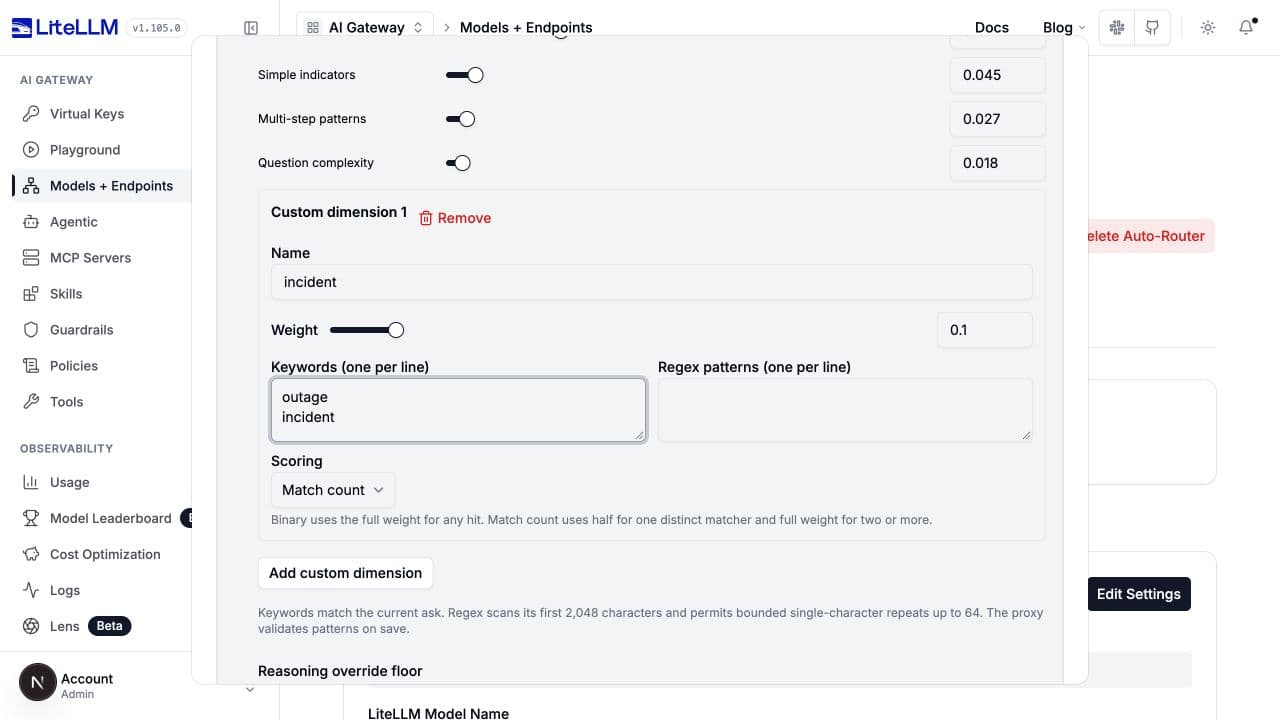
以下是上方所示的設定,包括 UI 重新平衡後的內建權重:
dimension_weights:
  tokenCount: 0.09
  codePresence: 0.27
  reasoningMarkers: 0.225
  technicalTerms: 0.225
  simpleIndicators: 0.045
  multiStepPatterns: 0.027
  questionComplexity: 0.018
custom_dimensions:
  - name: incident
    weight: 0.1
    keywords: [outage, incident]
    scoring_mode: match_count
| 列欄位 | custom_dimensions[] 下的鍵 | 限制與行為 |
|---|---|---|
| 名稱 | name | 唯一、不區分大小寫的 ASCII 識別碼,以字母開頭,後接字母、數字或底線;最多 64 個字元。不能重複使用內建維度名稱。 |
| 權重 | weight | 大於 0 的有限數字,且至多為 1。也不要將此維度放入 dimension_weights。 |
| 關鍵字 | keywords | 非空白的關鍵字字串。至少需要一個關鍵字或模式。 |
| Regex 模式 | patterns | 針對 ask 前 2,048 個字元的不區分大小寫模式。 |
| 計分 | scoring_mode | binary:任何比對都會貢獻完整權重。match_count:一個不同的匹配比對器會貢獻一半,兩個或以上則貢獻完整權重。單一比對器的重複出現不會增加計數。 |
YAML 預設為 binary;新新增的 UI 列會以 match_count 開始。最多可有 16 個維度、每個維度 32 個合併比對器、每個比對器 256 個字元,以及每個維度 4,096 個比對器字元。Regex 允許上限為 64 的受限單字元或字元類別重複;不允許無界量詞、重複群組、反向參照與前瞻/後顧斷言。額外的模式工作量限制可保護路由路徑。
自訂維度需要獨立或串接的 v1。v2 不接受這些設定,也不能只是用來調整 LLM/OSS/自訂分類器的失敗備援。
調整 heuristic v2
選取 Heuristics > Heuristic v2。Heuristic tuning > Success threshold 對應到 heuristic_v2_success_threshold,其數值範圍為 0 到 1。留白時會使用所選 artifact 的 routing_threshold,目前 bundled ultrafeedback artifact 的值為 0.75。
V2 會預測每個內建層級的成功機率,並選擇第一個達到門檻的層級。提高此值通常會偏向更強的層級,或在串接中增加更多 judge 呼叫。這些是任務成功的估計,不是 v1 分數,也不是對類別標籤的信心。V1 的權重、關鍵字、token 閾值與自訂維度不會調整 v2。
classifier_type: heuristic_v2
heuristic_v2_success_threshold: 0.75
如果沒有任何層級符合,獨立 v2 會選擇 REASONING;v2 串接會詢問 judge。v2 串接截圖 顯示了門檻控制項與其本地上限。
自訂訓練的 artifact(僅限 YAML)
heuristic_v2_artifact 預設為 ultrafeedback。它也接受內嵌的 trained artifact 物件,而不是檔名或 URL。請使用量測過的任務結果來建構;編輯其統計資料不等同於調整 UI 權重。
| 資產欄位 | 預設 / 合約 |
|---|---|
schema_version | 1 |
global_statistics | 每個層級 1 到 4 各有一筆條目,且 observations 與 successes 必須為正,並介於零與觀測值之間。 |
domain_statistics, cohort_statistics | 可選的網域與相似性群組統計資料,且鍵值必須唯一。 |
domain_prior_mass, cohort_prior_mass | 200、20;必須為嚴格正值的平滑強度。較高的值會偏好較廣泛的先驗統計資料,而非稀疏觀測值。 |
routing_threshold | 0.75;若設定 heuristic_v2_success_threshold,則由其覆蓋。 |
datasets, success_definition, split_method | 描述證據與評估切分的訓練來源資訊。 |
全域條目包含 tier、successes 與 observations。網域條目會新增一個 request_type;群組條目會新增一個非空的 cohort 識別碼,由 predictor 的特徵分組產生。每個網域/層級或群組/層級配對都必須唯一。資料集條目包含非空的 name、url、license、可選的 success_definition,以及正值的 rows 計數。這些欄位用來記錄證據;它們不會下載或對資料集進行訓練。預設的切分說明是 sha256(prompt): 70% train, 15% validation, 15% test。
請參閱 資產結構 以了解巢狀統計資料合約。特徵擷取已內建,且 predictor 會讓各層級的成功機率保持單調。
調整 LLM judge
若要進行僅 judge 路由,請選擇 LLM > Routing approach > Complexity,然後選擇 Advanced settings > Local checks before the judge > Always use the judge。在主要表單中選擇 Judge model,再開啟 LLM tuning。這些設定也適用於 heuristic-first 與 hybrid 鏈;它們與各層級模型的推理努力與生成設定是分開的。
| UI 標籤 | classifier_llm_config 下的鍵值 | 預設 / 效果 |
|---|---|---|
| Judge model | model | 必填的已部署 model-group 別名。請選擇支援分類器結構化回應的模型。 |
| Reasoning Effort | reasoning_effort | 未設定時使用部署/提供者預設值。可用選項取決於所選模型。更多推理可能會增加 judge 延遲與成本。 |
| Timeout (ms) | timeout_ms | 3000;請使用正整數。過短會增加備援頻率;過長則會在 judge 緩慢時延遲請求。 |
| Classifier circuit breaker | circuit_breaker_enabled | true。逾時會打開此路由執行個體的分類器斷路器,並在後續請求中立即使用備援。 |
| Circuit breaker cooldown (seconds) | circuit_breaker_cooldown_seconds | 30,且必須為嚴格正值。冷卻時間結束後,一個請求會進行探測,而並行請求會繼續使用備援。成功會關閉斷路器;探測失敗則會重新開始冷卻時間。 |
| Use images for classification | vision.enabled | false。當 judge 宣告支援 vision 時,會轉送最新使用者輪次中的內嵌影像資料。 |
| Maximum images per request | vision.max_images | 1,正整數;在啟用影像分類時顯示。限制新增的 judge 成本。 |
classifier_type: llm
classifier_llm_config:
  model: demo-efficient
  timeout_ms: 3000
  circuit_breaker_enabled: true
  circuit_breaker_cooldown_seconds: 30
  classification_rubric: agentic
  vision:
    enabled: false
    max_images: 1
影像分類只會轉送內嵌的 data: URI,而不會轉送遠端 HTTP(S) 影像網址或先前輪次的影像。不支援的 judge 仍只會收到文字。Use images for classification 會改變 judge 看到的內容;Modality Routing 則另外確保回答模型可以接受影像。
提示詞與規則
開啟 Classifier Prompt > Customize prompt。選擇 Base rubric,可選擇性地替換 Classification instructions 或 Calibration examples,並在儲存前檢視 What this router sends。
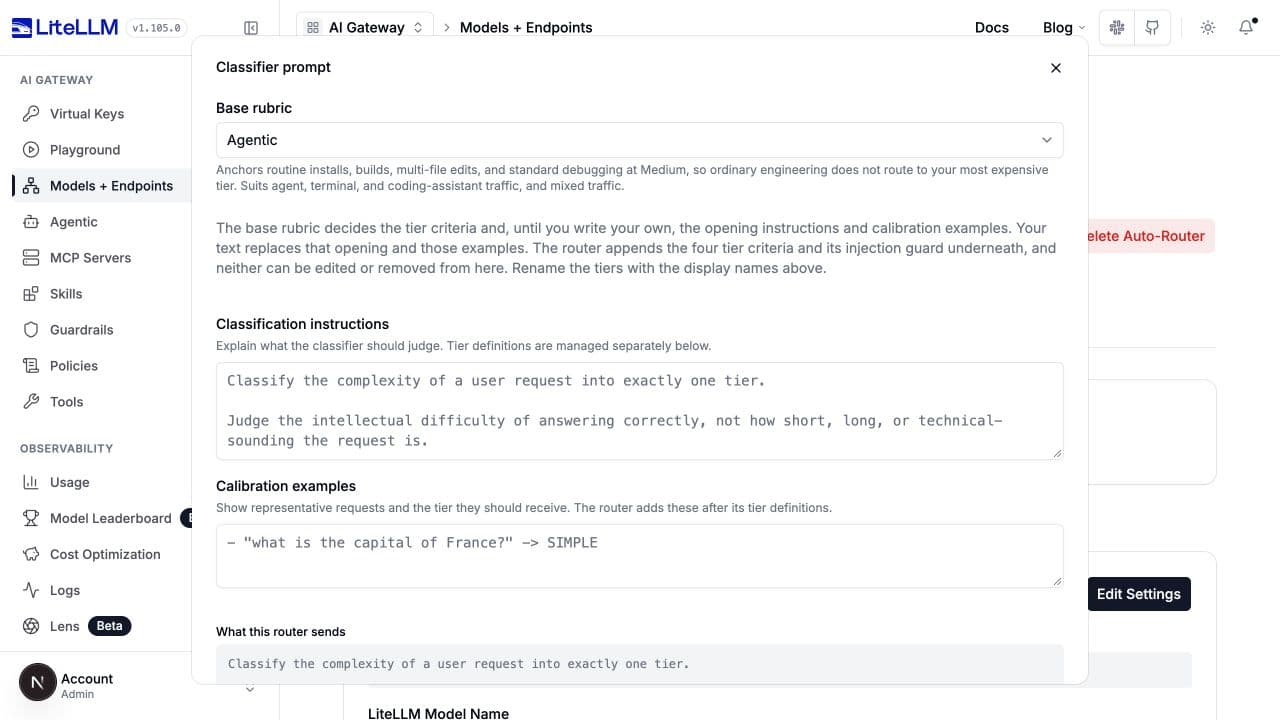
| 控制項 / 鍵值 | 選項或限制 | 用途 |
|---|---|---|
Base rubric / classifier_llm_config.classification_rubric | legacy、agentic、chat、business | agentic 將例行工程錨定於 Medium;chat 省略工程錨點;business 使用商業準則與範例;legacy 保留原始、未校準的規則。 |
Classification instructions / classification_prompt | 可選的非空文字,最多 2,000 個字元 | 取代開頭指示,同時保留層級準則與附加的提示注入防護。 |
Calibration examples / classification_examples | 可選的非空文字,最多 4,000 個字元 | 只取代範例行。路由會提供此區段標題。 |
UI 中新的 LLM 設定會以 agentic 開始。省略的 YAML 會使用 legacy,因此當您希望與 UI 等效時,請明確設定規則。規則與這些區段覆寫也適用於複雜度鏈。Capability 與 Fuse v2 則改用其各自封裝的提示詞。
classifier_llm_config:
  model: demo-efficient
  classification_rubric: business
classification_prompt: >-
  Classify the work needed to answer this support request correctly.
  Prefer the cheapest tier that can complete it.
classification_examples: |-
  "Summarize this support conversation" -> MEDIUM
  "Diagnose why retries caused duplicate charges across services" -> COMPLEX
重設為預設值 會移除自訂的開頭/範例,同時保留所選規則。自訂層級準則是透過 Edit tiers 編輯,而不是在開頭提示詞中重寫。
傳統完整 system-prompt 取代
classifier_llm_config.system_prompt 會取代整個 system 角色,包括層級準則與內建的注入防護。它與 classification_rubric、classification_prompt、以及 classification_examples 互斥。既有的完整提示詞設定會使用傳統 UI 編輯器;新的設定通常應使用上方的區段編輯器。
如果您使用完整取代,請自行提供指示,將引號中的呼叫端文字視為資料,而不是路由指示。當您的分類已不再是 complexity 時,請使用 classifier_fallback: default_model。層級重新命名不會改寫已凍結在完整 system-prompt 字串中的文字。
失敗政策與對話上下文
這些控制項位於 complexity 的 LLM/鏈用 LLM tuning 與 OSS 的 Classifier tuning 中。它們不是 forecast modes 的備援政策編輯器。
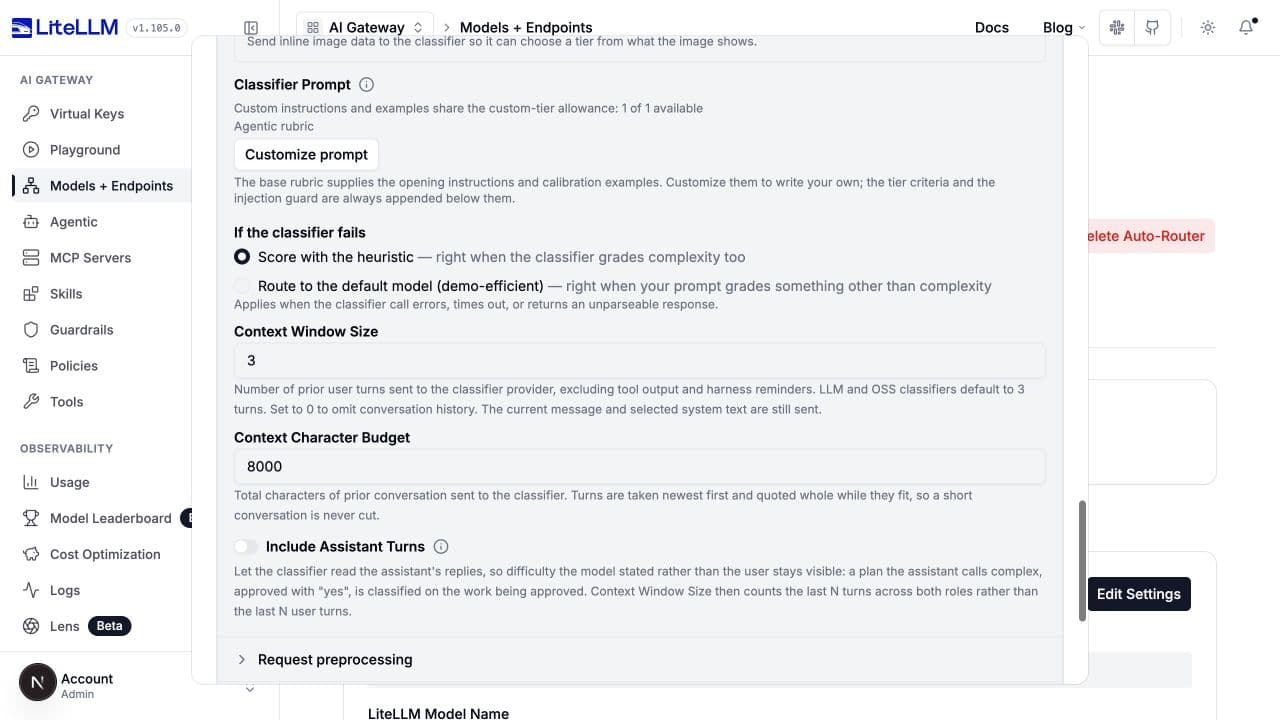
| UI 標籤 | 鍵值 | 預設 / 行為 |
|---|---|---|
| If the classifier fails | classifier_fallback | 在錯誤、逾時、無效回應或外掛拒絕後,heuristic 會在本地重新評分。default_model 會直接路由到已設定的預設模型。 |
| Context Window Size | classifier_context_window_size | 3;先前使用者輪次的非負計數。0 會省略歷史與其深度摘要,但不會省略目前的請求或所選的 system 文字。 |
| Context Character Budget | classifier_context_budget_chars | 8000;先前輪次文字的非負預算。完整且符合條件的輪次即使在小預算下也能保留;當可用空間不足以進行截斷時,超出邊界的輪次會被省略。 |
| Include Assistant Turns | classifier_context_include_assistant_turns | false。啟用後,視窗會計入兩種角色的先前輪次。當使用者的「yes」是在核准 assistant 所描述的工作時特別有用。 |
| Per-turn cap (YAML only) | classifier_context_per_turn_chars | 未設定;每個先前輪次的可選正值上限,會在總預算之前套用。保留受限輪次的開頭與結尾。 |
classifier_fallback: heuristic
classifier_context_window_size: 3
classifier_context_budget_chars: 8000
classifier_context_include_assistant_turns: false
歷史不包含工具輸出與測試框架提醒。路由會優先採用較近期的輪次,盡可能保留完整輪次,並在必要時截斷最舊的已保留輪次。目前的請求與所選 system 文字位於先前輪次預算之外。Claude Code system 文字不會被納入分類;回答模型仍會接收它。
增加歷史會將更多資料送至 judge 的提供者,這可能與回答提供者不同。當您不希望送出先前輪次時,請使用視窗大小 0。這不會讓分類變成零資料成本。
對於 classifier_fallback: default_model,請設定 預設模型,最好透過完整範例中顯示的同層級 litellm_params.complexity_router_default_model。在正規化後的路由設定中,這是 default_model。純粹的 LLM/OSS/自訂啟發式備援使用 v1;鏈則使用其所選的本機版本。自訂分類體系使用 fallback_tier。Capability 和 Fuse v2 一律回復到其可處理的求解器。
連接自行代管的分類器
選取 OSS 分類器,選擇 OSS 提供者,然後展開 進階設定 > 分類器調校。這會連線到既有伺服器;不會部署或啟動新的伺服器。請參閱 自行代管的分類器 以取得安裝與連線詳細資料。
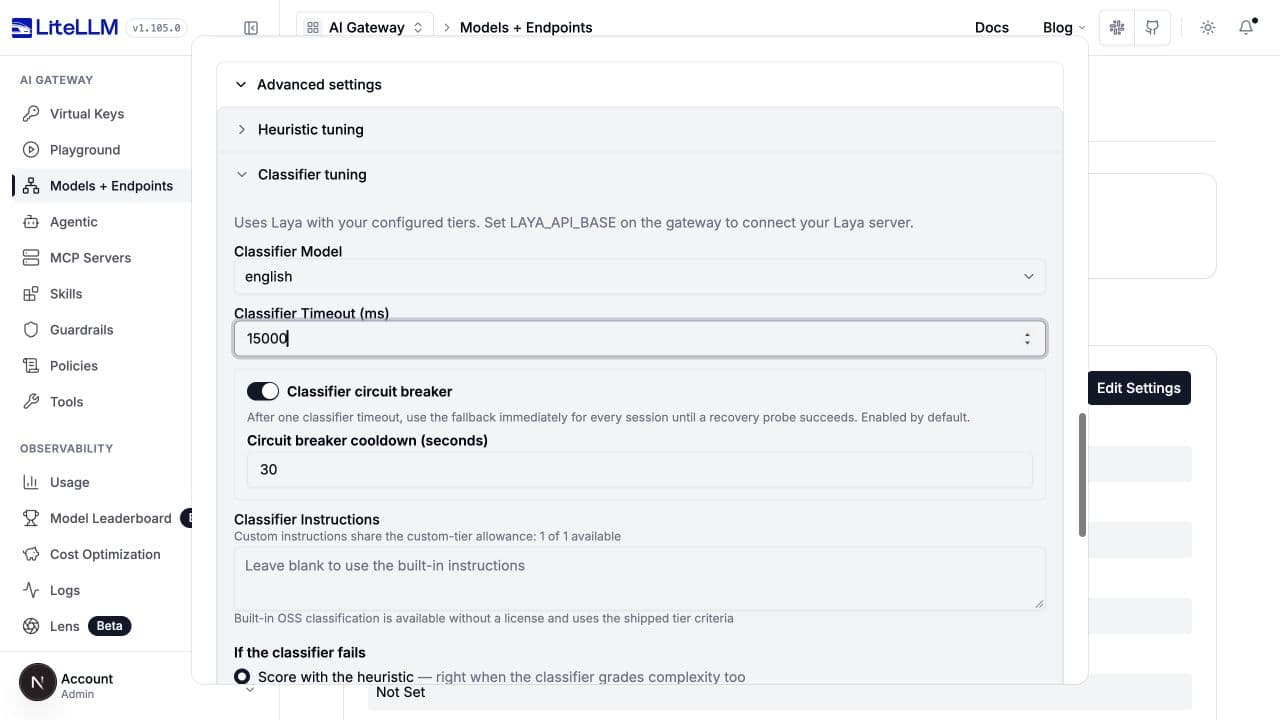
| 提供者 | provider | 分類器模型 | 閘道環境 |
|---|---|---|---|
| Laya,自行代管 | laya | english、multilingual、typed-decisions | LAYA_API_BASE,可選 LAYA_API_KEY |
| Bespoke Nimble,自行代管 | bespoke | nimble-latest、nimble、bespokelabs/Bespoke-Nimble-9B | BESPOKE_API_BASE,可選 BESPOKE_API_KEY |
| Jev,代管式 TypeSafe API | jev | 預設為 jev-latest | TYPESAFE_API_KEY;可選 TYPESAFE_API_BASE,預設 https://api.typesafe.ai |
在閘道上設定環境。內部主機名稱是從閘道的主機/容器解析,而不是從您的瀏覽器解析。三者皆使用 POST /v1/systemone;請設定不含該尾碼的 base URL。
export LAYA_API_BASE="http://laya-server:8000"
# Supply LAYA_API_KEY through your secret manager if the server requires it.
classifier_type: oss_classifier
opensource_classifier_config:
  provider: laya
  model: english
  timeout_ms: 15000
  circuit_breaker_enabled: true
  circuit_breaker_cooldown_seconds: 30
classifier_context_window_size: 3
classifier_context_budget_chars: 8000
對於 Nimble,將提供者變更為 bespoke,並將模型改為您的伺服器所提供的受支援名稱。對該伺服器而言,30000 ms 逾時是合理的初始測試值,而不是後端預設值。對於 Jev,請選取 jev 搭配 jev-latest,並設定 TypeSafe 金鑰。
| UI 標籤 | opensource_classifier_config 下的鍵 | 預設 / 行為 |
|---|---|---|
| OSS 提供者 | provider | jev;接受的值為 jev、laya、bespoke。 |
| 分類器模型 | model | 後端預設 jev-latest;請明確選取適用於 Laya/Nimble 的模型。UI 更換提供者時會選擇該提供者的預設值。 |
| 分類器逾時 (ms) | timeout_ms | 3000,正整數。若冷啟動或自行代管推論較慢,請提高此值,然後進行測量。 |
| 分類器指令 | instructions | 內建項目請省略;非空白文字會取代開頭指令。自訂指令遵循自訂層級允許範圍。 |
| 分類器斷路器 | circuit_breaker_enabled | true;如同 LLM judge 所述的逾時保護。 |
| 斷路器冷卻時間 (秒) | circuit_breaker_cooldown_seconds | 30,嚴格為正值。 |
| 端點 (僅 YAML/管理 API) | api_base | 提供者環境/預設值。Laya/Nimble 需要可連線的 HTTP(S) base,且不得內嵌憑證、查詢字串或片段。 |
| 憑證 (僅 YAML/管理 API) | api_key | 使用其環境 base 時,採用提供者環境設定。對於未驗證的自行代管伺服器為選用;對 Jev 則為必填。 |
明確指定的 api_base 不會繼承環境 API 金鑰。當該端點需要驗證時,請提供相符的明確金鑰;Jev 會拒絕未明確提供金鑰的明確 base。儀表板刻意不提供端點/金鑰欄位。團隊成員無法透過管理 API 設定這些覆寫。
標準鍵為 oss_classifier 和 opensource_classifier_config。既有的 jev、jev_classifier_config,以及提供者 typesafe 別名仍可接受;請勿同時提供兩個分類器區塊。
自行代管的 OpenAI 相容 judge
通用的 vLLM 或其他 OpenAI 相容聊天端點是不同的整合:將其註冊為一般模型,並選取 LLM,而不是 OSS System One 提供者。將此部署與您現有的求解器並列新增,然後在 classifier_llm_config.model 中使用其別名:
- model_name: local-routing-judge
  litellm_params:
    model: openai/your-served-model-name
    api_base: http://judge-server:8000/v1
    api_key: os.environ/LOCAL_JUDGE_API_KEY
classifier_type: llm
classifier_llm_config:
  model: local-routing-judge
  timeout_ms: 5000
  classification_rubric: agentic
使用您的伺服器接受的驗證值,並確認其結構化輸出支援。相同的別名可用於先啟發式/混合鏈。自行代管 judge 不會改變所選 completion 模型的執行位置。
預測求解器成功
在 LLM > 路由方式 下,Capability 和 Fuse v2 會預測任務成功,而不是直接選擇複雜度標籤。兩者都提供 Efficient solver、Capable solver 與 Judge model 控制項。兩者都使用封裝的提示,並在無效的預測或分類器失敗時選擇可處理的求解器。請勿向這些模式新增一般性的提示/評分規則覆寫、本機啟發式鏈,或 classifier_fallback: default_model。
Capability
在主表單中設定 Solve probability threshold。在 LLM tuning 中,Capability boundary step 會在不確定/不匹配的任務時將所需機率提高一次,並在不受支援的任務時提高兩次。
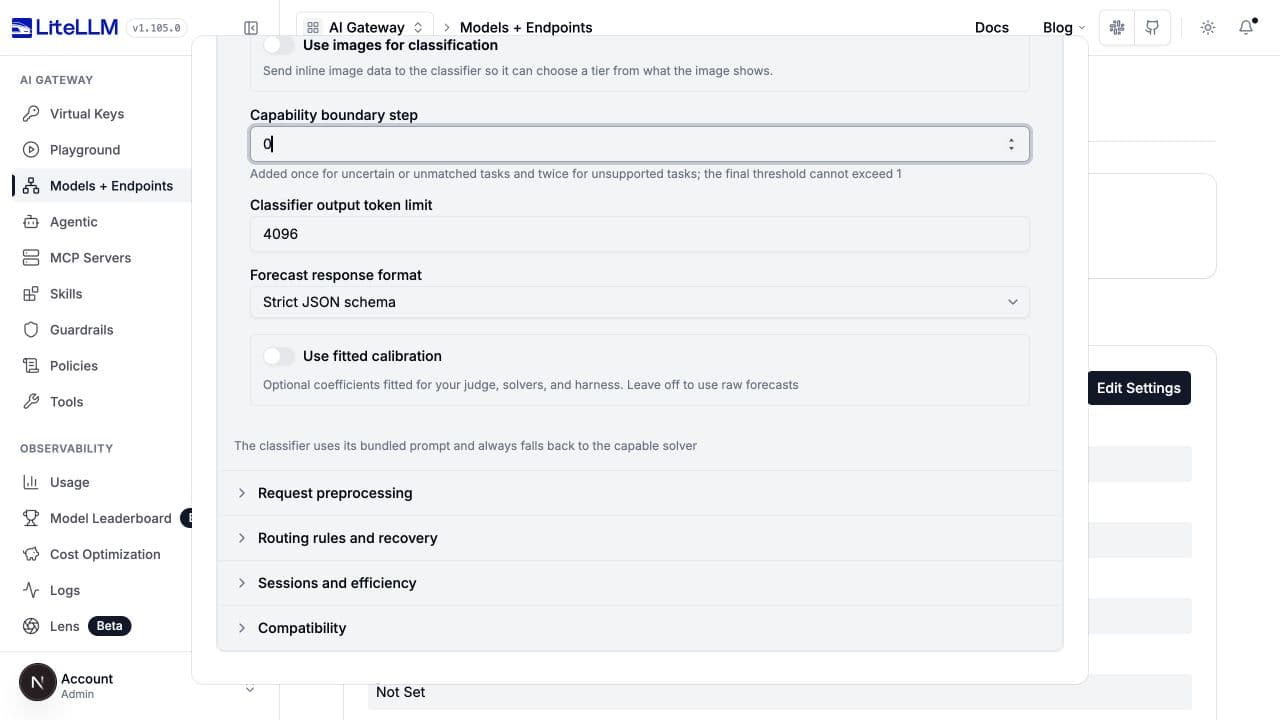
tiers:
  SIMPLE: demo-efficient
  REASONING: demo-capable
classifier_type: capability
classifier_llm_config:
  model: demo-efficient
  timeout_ms: 3000
capability_classifier_config:
  efficient_tier: SIMPLE
  capable_tier: REASONING
  base_threshold: 0.5
  threshold_step: 0.0
  max_output_tokens: 4096
  response_format: json_schema
capability_classifier_config 下的鍵 | 預設 / 限制 | 影響 |
|---|---|---|
efficient_tier、capable_tier | 需要已設定的內建層級;capable 必須更高 | 選擇求解器池與失敗目的地。UI 會選擇模型,同時保留這些名稱。 |
base_threshold | [0, 1] 中的必要數值 | 當 Efficient 的預測成功率達到調整後門檻時,就會選取它。 |
threshold_step | 0.0,非負 | 支援:base。不確定/不匹配:base + step。不受支援:base + 2 x step。Base + 2 x step 必須至多為 1。 |
max_output_tokens | 4096,正整數 | 限制 judge 的預測回應,而非求解器的答案。 |
response_format | json_schema;或 json_object | JSON 物件模式可讓沒有嚴格結構描述支援的 judge 也能使用;傳回的預測仍會經過驗證。 |
calibration | 未設定 | 在門檻比較前的可選擬合機率轉換。 |
Capability 使用內建的 capability 卡片,而不是可在儀表板編輯的求解器設定檔。請根據觀察到的整體任務成功率來調整機率門檻,而不是將其解讀為分類信心。
Fuse v2
請提供 Efficient solver profile、Capable solver profile 與 Harness and budget,可使用預設選擇器或自訂文字。將 Maximum quality gap 設定為預測的 capable 與 efficient 成功機率之間允許的差異。
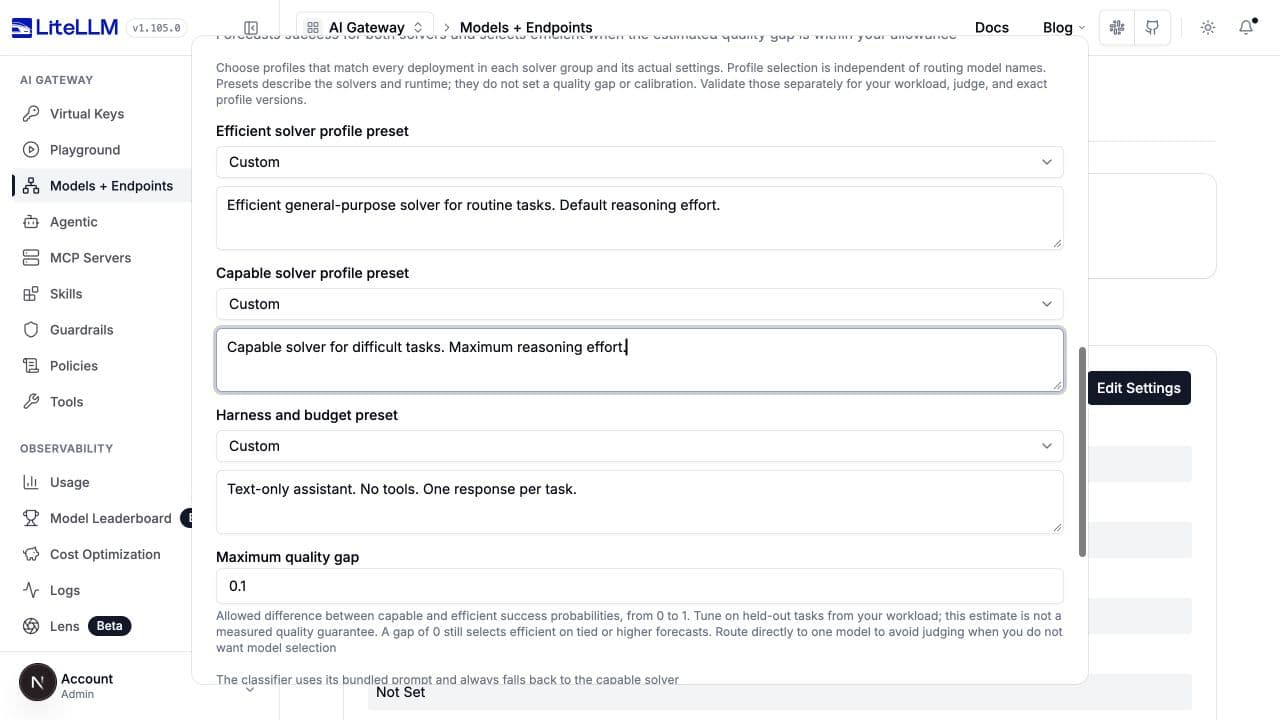
tiers:
  SIMPLE: demo-efficient
  REASONING: demo-capable
classifier_type: llm_v2
adaptive: false
classifier_llm_config:
  model: demo-efficient
llm_v2_config:
  efficient_tier: SIMPLE
  capable_tier: REASONING
  efficient_profile: Efficient general-purpose solver for routine tasks. Default reasoning effort.
  capable_profile: Capable solver for difficult tasks. Maximum reasoning effort.
  harness: Text-only assistant. No tools. One response per task.
  max_quality_gap: 0.1
  max_output_tokens: 1024
  response_format: json_schema
上方的設定檔文字展示了這些欄位。請以您實際模型、推理設定、工具、驗證與預算的證據取代它。設定檔說明不會設定求解器參數;請另外在求解器部署或層級模型項目上設定那些參數。
llm_v2_config 下的鍵 | 預設 / 限制 | 影響 |
|---|---|---|
efficient_tier、capable_tier | SIMPLE、REASONING | 恰好兩個已填入的內建層級,分別為 capable 與 efficient,且每個層級各有一個不同的 model-group 別名。 |
efficient_profile、capable_profile、harness | 非空文字,每個最多 4,000 個字元,或對應的預設集 | 描述正在預測的內容。 |
efficient_profile_preset、capable_profile_preset、harness_preset | 未設定;來自 gateway 預設集目錄中的已知 ID | 提供版本化描述。明確文字會覆寫預設文字;未知的預設集仍然無效。 |
max_quality_gap | 以 [0, 1] 表示的必要數值 | 當 capable 機率減去 efficient 機率小於或等於這個差距時,efficient 會勝出。較大的差距可容忍較多估計品質損失。零仍允許平手或較高的 efficient 預測。 |
max_output_tokens | 1024、正整數 | 判斷回應預算。 |
response_format | json_schema;或 json_object | 結構化回應模式;兩者都會驗證判決。 |
calibration | 未設定 | 可選的、分別適用於 efficient 與 capable 機率的擬合轉換。 |
UI 會從 /public/complexity_router/fuse_presets 載入預設集,並顯示其模型、版本與來源。預設集不會提供量測到的品質保證、品質差距設定或擬合校準。Fuse 需要 adaptive: false,且不支援自訂或 Non-Reasoning 層級。
擬合後的預測校準
使用擬合校準 會啟用已擬合的係數;它不會執行訓練工作。兩種模式都會在選擇 solver 之前套用 sigmoid(slope * logit(clipped_probability) + intercept)。請為您的 judge、solver、prompt 版本與執行設定擬合並驗證係數。
| 模式 | 校準欄位 | 限制 |
|---|---|---|
| Capability | calibration.version、.slope、.intercept | 版本為 1-128 個字元,且前後無空白;有限斜率 0 到 20;有限截距 -20 到 20。 |
| Fuse v2 | calibration.version、.prompt_version、.efficient.slope、.efficient.intercept、.capable.slope、.capable.intercept | 非空版本最多 512 個字元;prompt 版本 llm-v2-1;有限斜率必須嚴格大於零;有限截距。UI 會提供 prompt 版本。 |
若沒有這個區塊,路由會使用原始預測。複雜度 prompt 中的校準範例與這些數值係數無關。
自訂層級或使用外掛
依層級的模型 會將 tiers 對應到已部署的模型別名或池。顯示名稱 會寫入 tier_labels;設定鍵仍保持 canonical,而 LLM 評分準則也會看到您的標籤。每個模型的 reasoning effort 與 fast mode 會設定應答模型,而不是 classifier。
| 控制項 / 鍵 | 預設 / 適用範圍 |
|---|---|
tiers | 明確設定為您已部署的別名。單一別名會固定一個模型群組;清單則提供一個池。 |
tier_model_configs | 空白;儲存每個層級、每個模型的 litellm_params。YAML 也可以在 tiers 中使用結構化模型項目。 |
tier_labels | 空的部分對應表。會在 UI/記錄與 LLM 評分準則中重新命名內建層級,但不會重新命名 YAML 鍵。 |
新增 non-reasoning 層級 / enable_non_reasoning_tier | false。在 SIMPLE 之下新增 NON_REASONING;需要一個已對應的模型,以及 plain LLM、OSS 或自訂 classifier。heuristics/chains/forecasts 無法產生它。 |
編輯層級 / tier_definitions | 未設定。2-8 個層級的有序自訂分類法;自訂名稱需要描述,且必須與 tiers 完全相符。需要 LLM、OSS 或自訂 classifier。 |
備援層級 / fallback_tier | 自訂分類法時必填;必須指定其層級之一。取代 heuristic/default-model classifier 的復原。 |
自訂分類法不能與評分準則預設集、完整系統提示取代、層級標籤、自適應路由、session affinity、非空的升級關鍵字、停滯任務升級或路由外掛組合使用。請使用層級層級的指示/範例與備援層級。
classifier_type: llm
classifier_llm_config:
  model: demo-efficient
tiers:
  routine: demo-efficient
  specialist: demo-capable
tier_definitions:
  - name: routine
    description: Routine support answers and summaries with established procedures.
  - name: specialist
    description: Diagnosis requiring specialist technical investigation.
fallback_tier: specialist
classification_prompt: Choose the support category needed to answer the request correctly.
escalation_keywords: []
自訂 classifier(僅限啟動設定)
classifier_type: custom 需要 classifier_plugin,也就是 proxy YAML 中已安裝 Python 實例的點分路徑。它實作 async classify(context),回傳一個層級名稱,或回傳 None 以使用備援政策。其 RoutingContext 包含原始與結構化訊息、metadata,以及資訊性候選模型。
classifier_type: custom
classifier_plugin: classifiers.my_classifier
classifier_plugin_timeout_ms: 3000
classifier_fallback: heuristic
classifier_plugin_timeout_ms 是正整數,預設為 3000,在既有自訂 router 中顯示為 Classifier plugin timeout (ms)。請在 proxy 啟動時安裝並設定外掛;HTTP model-management 與 routing-test API 不會匯入任意外掛路徑。UI 不提供外掛失敗政策選擇器;請在 YAML 中設定。
classifier_plugin 會選擇層級。獨立的 plugins 清單包含路由外掛,其 run(context) 會在分類後縮小候選模型範圍。請參閱 分類參考 與 路由外掛指南 以了解實作合約。
控制分類執行時機
分類頻率 位於主表單中、模型層級上方。
| UI 選項 | 設定 | 行為 |
|---|---|---|
| 每個請求 | classification_mode: every_request、session_affinity: false | 預設。包含工具結果續接請求。 |
| 每個新的使用者訊息 | classification_mode: user_turn、session_affinity: false | 重新分類新的人工提問;續接時重用保留的決定。 |
| 每個 session 一次 | classification_mode: every_request、session_affinity: true | 固定第一個模型,並在固定有效時略過後續分類。 |
重用需要可解析的用戶端 session ID 與有效的保留決定。缺少/過期的狀態仍會進行分類。路由外掛會抑制一般的重播路徑,而自訂分類法不支援每個 session 一次模式。
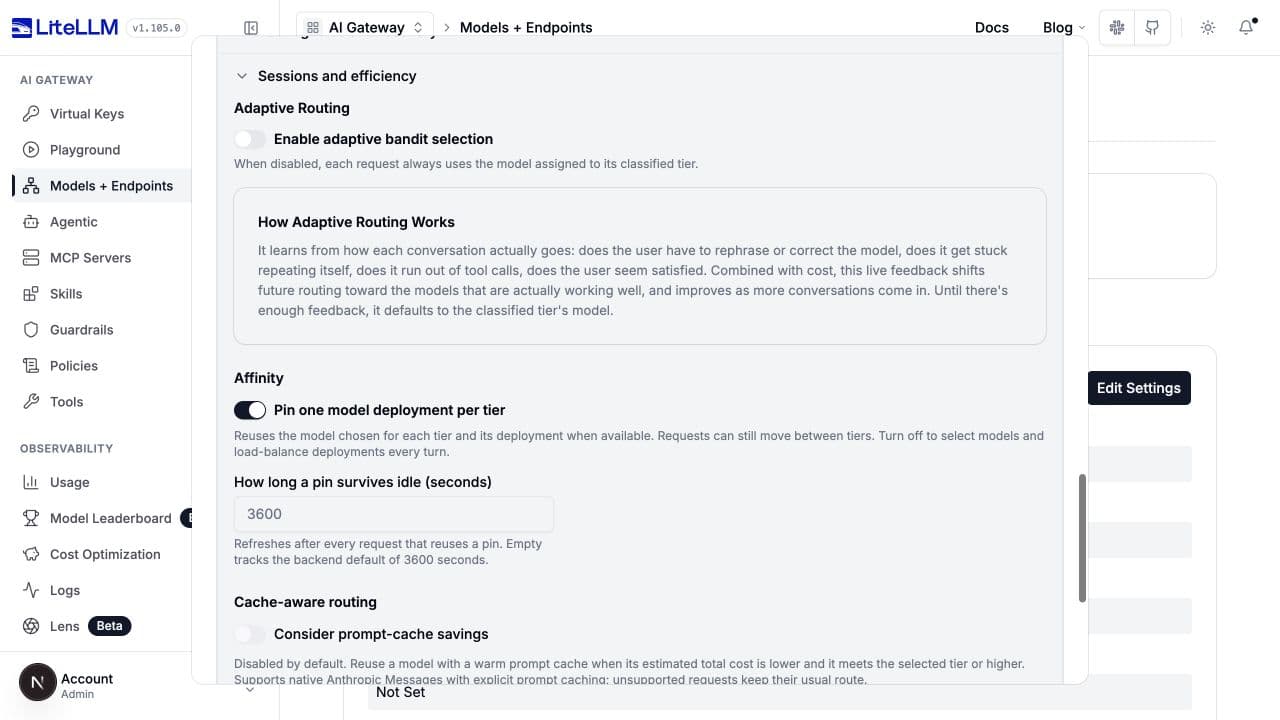
在 Sessions and efficiency > Affinity 中,Pin one model deployment per tier 對應到 deployment_affinity(預設 true)。它會在每個已分類層級內重用模型/deployment,同時仍允許重新分類與層級變更。How long a pin survives idle 對應到 session_affinity_ttl_seconds(預設 3600,正整數),在重用時會重新整理。即使 deployment_affinity 為 false,session affinity 仍表示 deployment 固定。
classification_mode: user_turn
session_affinity: false
deployment_affinity: true
session_affinity_ttl_seconds: 3600
Session 與效率控制
前處理與路由覆寫
這些設定會影響被分類的輸入或最終路由。它們與 classifier 的權重和提示彼此獨立。即使是 Always use the judge router,也可能略過 judge 呼叫,因為關鍵字規則、維護規則或 session 決定已經提供了路由。
請求前處理
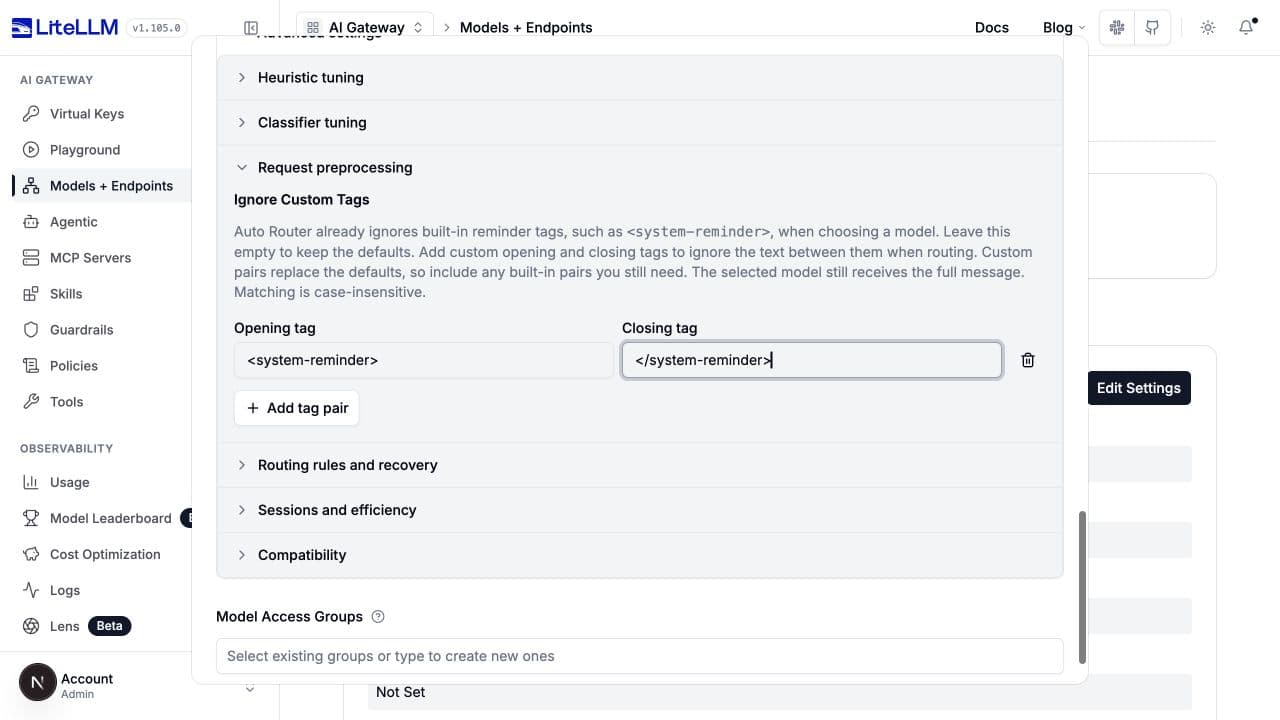
Request preprocessing > Ignore Custom Tags 會寫入 reminder_markers,也就是一個非空的 {open, close} 配對清單。比對不區分大小寫。自訂配對會取代內建配對,包括為 Codex user agents 啟用的 Codex envelope 配對;請包含您的測試工具仍需要的每個內建配對。若省略此設定,則保留所有適用的預設值。
reminder_markers:
  - open: <system-reminder>
    close: </system-reminder>
選定的應答模型仍會接收完整訊息。這是分類清理,不是去識別化或存取控制邊界。
標籤排除控制
規則與復原
開啟 Routing rules and recovery。以下預設值與鍵適用於一般複雜度路由;預測/自訂層級模式會隱藏或拒絕不相容的控制項。
| UI 區段 | 鍵值與預設值 | 效果 |
|---|---|---|
| 關鍵字分級覆寫 | keyword_tier_rules: null;列包含 keywords 和 tier | 在分類前比對。如果多個規則符合,則以符合程度最高的分級為準。 |
| 語意關鍵字比對 | semantic_keyword_matching: false、embedding_model: null、match_threshold: 0.5 | 對相同規則改用嵌入相似度,而非字面比對。需要嵌入模型;閾值為 0 到 1。會增加一次嵌入呼叫。 |
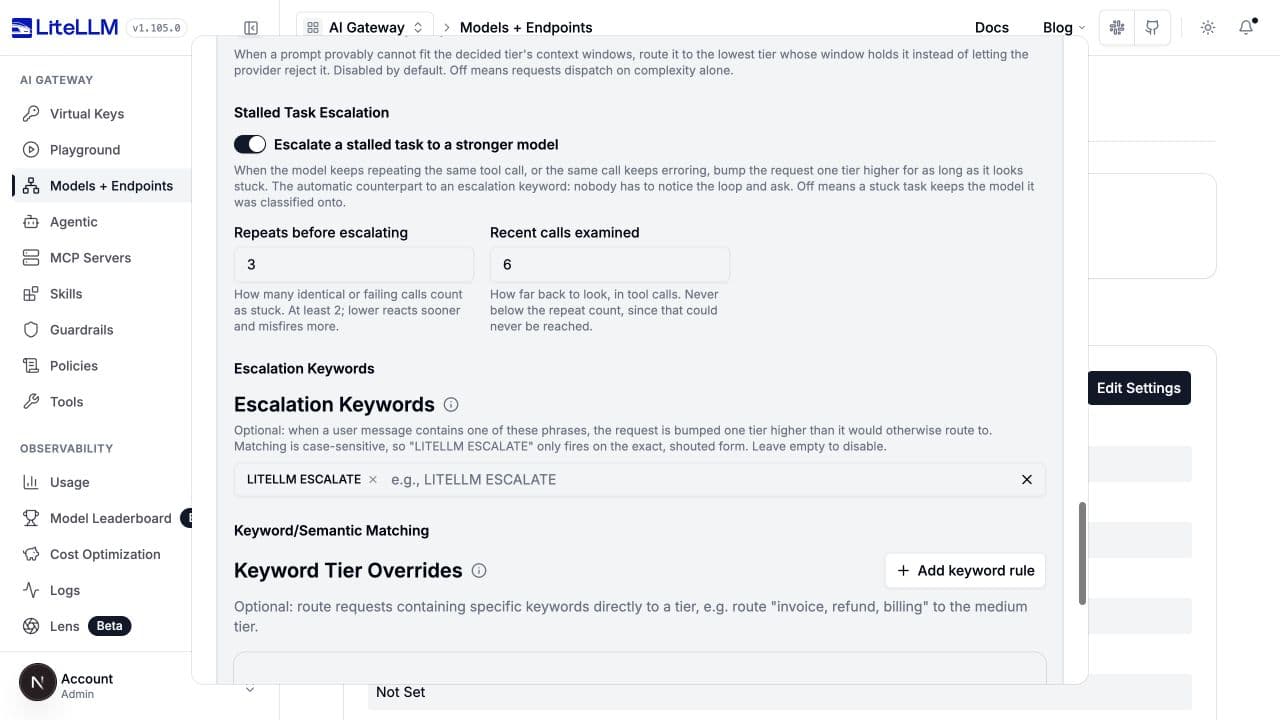
| 升級關鍵字 | escalation_keywords 預設為 ["LITELLM ESCALATE"] | 精確且區分大小寫的片語會上升一個分級。[] 會停用此功能。 |
| 計畫模式覆寫 | plan_mode_min_tier: null、plan_mode_patterns: null | 當代理程式計畫模式標記存在時,選用的最低分級。額外模式為區分大小寫的字面哨兵。不會重寫工作階段釘選。 |
| 維運路由 | route_housekeeping_to_cheapest_tier: true、housekeeping_patterns: null | 可辨識的對話標題呼叫會略過分類並使用最便宜的分級;關鍵字規則/釘選仍優先,且升級可提高結果。額外哨兵為區分大小寫。 |
| 多模態路由 | modality_routing: false、modality_pin_override: false | 在圖片輪次中,以具備能力的更高分級/預設模型取代明確非 vision 的模型。此覆寫允許在釘選工作階段中僅對該輪次生效。不會將未知的 vision 支援視為明確不支援。 |
| 上下文視窗升級 | enable_context_window_escalation: false、context_window_escalation_buffer: 0.95 | 將選擇限制在能容納的模型,或移至已證明可容納的最近較高分級。緩衝區大於 0,至多為 1。上下文視窗未知的模型,不能作為可容納或溢出的證明。 |
| 卡住的任務升級 | stall_escalation_enabled: false、stall_escalation_window: 6、stall_escalation_repeat_threshold: 3 | 將重複/失敗的近期工具呼叫升級一個分級。重複次數必須至少為 2,且不得大於正值視窗。不相容於工作階段親和性或 classification_mode: user_turn。 |
keyword_tier_rules:
  - keywords: [invoice, refund, billing]
    tier: MEDIUM
semantic_keyword_matching: false
escalation_keywords: [LITELLM ESCALATE]
classification_mode: every_request
session_affinity: false
stall_escalation_enabled: true
stall_escalation_window: 6
stall_escalation_repeat_threshold: 3
如果語意比對失敗,路由器會繼續正常分類,不會重試字面比對。自訂分類器外掛程式不使用維運捷徑。明確的升級關鍵字與卡住的任務偵測都可以在同一請求中將結果各自提高一級。計畫模式哨兵是呼叫端可見字串,不是授權控制。
復原控制
模型選擇、壓縮與相容性
這些不會改變 v1 分數、v2 閾值或 judge 提示詞的含義。請參閱 路由參考 與 提示詞快取指南 以了解完整流程。
| 設定群組 | 鍵值與預設值 | 目的 |
|---|---|---|
| 自適應路由 | adaptive: false;adaptive_weights: {quality: 0.3, cost: 0.7};tier_distance_penalty: 0.5;adaptive_eligible: all | 從回饋中學習模型選擇。權重為 0 到 1,總和為 1;懲罰值為非負。classified_tier 將取樣限制在所選集合中;all 使用柔性的分級距離懲罰。 |
| 快取感知路由 | cache_aware_routing: false;cache_aware_routing_output_tokens: 1024;cache_aware_routing_timeout_ms: 2000 | 在受支援的原生 Anthropic 請求上,比較暖快取成本。輸出估計為非負;逾時為正值。不支援的請求會保留其正常路由。 |
| 壓縮 | 同層級的 litellm_params.auto_router_routing_compression 與 auto_router_model_compression,兩者皆未設定 | 每一跳選擇已設定的 guardrail。兩者皆未設定時會保留繼承行為。一旦任一項設定,省略某一跳即表示不進行壓縮;none 會明確停用某一跳。 |
| 上下文壓縮(僅 YAML) | context_compaction,預設啟用 | 在所選部署的輸入限制附近壓縮完整對話歷史。與分類器的前一輪視窗及壓縮 guardrail 不同。false 或 null 會停用它。 |
| 相容性 | return_raw_model_name: false;max_tokens_from_tier_model: true | 回傳解析後的模型名稱,而不是路由器別名;或控制所選模型的輸出上限是否取代呼叫端的 token 限制。分級層級的 token 覆寫仍然優先。 |
| 路由外掛程式(啟動設定) | plugins: null | 在分類後縮小候選模型;與選擇分級的 classifier_plugin 不同。 |
快取感知路由還有其他符合資格條件:內建分級、受支援的原生 Anthropic 請求與已分類原因、沒有路由外掛程式/自適應/工作階段親和性、classification_mode: every_request、每個分級一個字串模型別名、沒有每分級參數覆寫,以及每個候選項一個符合資格且受支援的部署。僅啟用開關並不代表每個請求都符合資格。自適應 all 是柔性的分級偏好,而不是硬性的最低分級保證。
對於完整歷史壓縮,context_compaction.model 可選擇一個相容的原生壓縮模型;未設定則讓路由器選擇一個可行且已設定的模型。trigger_ratio 預設為 0.9,且必須嚴格介於 0 與 1 之間;max_tokens 預設為 4096,且必須至少為 512;timeout_seconds 預設為 120,且必須為正值。由提供者/用戶端管理的原生歷史會保留其既有行為。當壓縮待處理時,會抑制上下文視窗升級。
驗證變更
保留一組隔離的真實請求形狀:簡單查詢、困難的短問題、帶有簡單提問的長上下文、像「yes」這類追問、圖片任務、工具續作,以及領域特定術語。一次只變更一項政策或一組相關設定,然後與先前設定比較。
使用 Test Routing 來檢查所選的分級/模型,而不產生最終答案。judge、OSS 分類器或語意嵌入呼叫仍可能產生成本。Test Connection 也可能呼叫 completion 模型。成功的備援不代表原本預期的分類器有回應。
檢查決策原因、分類器模型、備援/錯誤資訊,以及可取得時的機率。即使對 Laya 和 Nimble,OSS 決策仍會保留 cause: jev_classifier。衡量下游任務品質、judge 呼叫率、備援率、分類延遲,以及包含分類器呼叫在內的總成本。自架分類器仍會產生基礎設施成本。
儲存、重新開啟路由器,並確認所選模式、heuristic 版本、閾值與提示詞。使用 Evaluate 來評估正式環境品質與節省,而不是把較低的 judge 呼叫數或較高的預測視為品質結果。

