OpenTelemetry v1
OpenTelemetry 是一項 CNCF 的可觀測性標準。它可連接到任何可觀測性工具,例如 Jaeger、Zipkin、Datadog、New Relic、Traceloop、Levo AI 等。
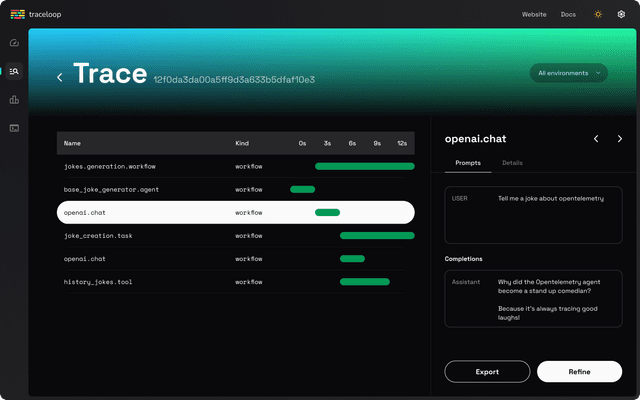
LiteLLM Proxy 提供較新的、可選用的 OpenTelemetry v2 整合,可為每個請求產生一條 trace(HTTP → 驗證 → 防護欄 → LLM 呼叫 → DB 寫入),遵循官方 GenAI 語意慣例,並附帶 Arize、Phoenix、Langfuse、Weave 等預設設定。使用 LITELLM_OTEL_V2=true 來啟用它。
從 v1.81.0 開始,預設會將請求/回應設為父 Received Proxy Server Request span 上的屬性,而且除非您選擇啟用,否則不會有獨立的 litellm_request span。若要還原巢狀的 litellm_request spans,請設定 USE_OTEL_LITELLM_REQUEST_SPAN=true。請參閱 Span Hierarchy 以了解完整情況,以及在何時切換此旗標請參閱 Why don't I see a litellm_request span?。
開始使用
安裝 OpenTelemetry SDK:
uv add opentelemetry-api opentelemetry-sdk opentelemetry-exporter-otlp
設定環境變數(不同提供者可能需要不同的變數):
- 記錄到 Traceloop Cloud
- 記錄到 OTEL HTTP Collector
- 記錄到 OTEL GRPC Collector
- 記錄到 Laminar
- Splunk Observability Cloud
OTEL_EXPORTER="otlp_http"
OTEL_ENDPOINT="https://api.traceloop.com"
OTEL_HEADERS="Authorization=Bearer%20<your-api-key>"
OTEL_EXPORTER_OTLP_ENDPOINT="http://0.0.0.0:4318"
OTEL_EXPORTER_OTLP_PROTOCOL=http/json
OTEL_EXPORTER_OTLP_HEADERS="api-key=key,other-config-value=value"
OTEL_EXPORTER_OTLP_ENDPOINT="http://0.0.0.0:4318"
OTEL_EXPORTER_OTLP_PROTOCOL=grpc
OTEL_EXPORTER_OTLP_HEADERS="api-key=key,other-config-value=value"
注意:OTLP gRPC 需要
grpcio。請透過uv add "litellm[grpc]"(或grpcio)安裝。
OTEL_EXPORTER="otlp_grpc"
OTEL_ENDPOINT="https://api.lmnr.ai:8443"
OTEL_HEADERS="authorization=Bearer <project-api-key>"
注意:OTLP gRPC 需要
grpcio。請透過uv add "litellm[grpc]"(或grpcio)安裝。
OTEL_EXPORTER_OTLP_ENDPOINT="https://ingest.<realm>.observability.splunkcloud.com/v2/trace/otlp"
OTEL_EXPORTER_OTLP_PROTOCOL=http/protobuf
OTEL_EXPORTER_OTLP_HEADERS="X-SF-Token=<your-ingest-access-token>"
OTEL_SERVICE_NAME="litellm-proxy"
如需 LiteLLM Proxy 設定、擷取 token 模式與 trace 驗證,請參閱 Splunk Observability Cloud (OpenTelemetry)。
只要 1 行程式碼,就能透過 OpenTelemetry 立即記錄您在所有提供者上的 LLM 回應:
litellm.callbacks = ["otel"]
Span 階層
LiteLLM Proxy 處理的每個 LLM 請求,都會產生一棵以 Received Proxy Server Request 為根節點的 spans 樹狀結構。下方的條件式 spans 只有在其控制旗標被設定,或其功能正在使用時才會發出。
Received Proxy Server Request                      (SpanKind.SERVER, root)
│
├── litellm_request                                (INTERNAL, only when USE_OTEL_LITELLM_REQUEST_SPAN=true)
│   ├── raw_gen_ai_request                         (INTERNAL — provider request/response, content-capture-gated)
│   └── guardrail                                  (INTERNAL — one per executed guardrail)
│
├── raw_gen_ai_request                             (INTERNAL — when litellm_request is collapsed into the root)
├── guardrail                                      (INTERNAL — when litellm_request is collapsed into the root)
│
├── auth, router, self, proxy_pre_call,            (INTERNAL — service-hook spans, see below)
│   redis, postgres, batch_write_to_db
│
└── Failed Proxy Server Request                    (INTERNAL — only on exception)
在 semconv mode(OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental)中,當建立 LLM-call span 時,其名稱會變成 {operation} {model}(例如 chat gpt-5.6-terra),並帶有 SpanKind.CLIENT,且 raw_gen_ai_request 會被抑制。是否發出該 span 也同樣由 USE_OTEL_LITELLM_REQUEST_SPAN gating 決定。請參閱 Opt-In to Latest GenAI Semantic Conventions。
SDK(無 proxy)在不存在父內容時會將 litellm_request 作為根;在純 SDK 使用情境中不會有 Received Proxy Server Request span。
Span 名稱參考
| Span 名稱 | Span 類型 | 父層 | 發出時機 |
|---|---|---|---|
Received Proxy Server Request | SERVER | root(或外部 traceparent,若存在) | 每次對 LiteLLM Proxy 的 HTTP 請求一次 |
litellm_request | INTERNAL | proxy root(proxy)或 root(SDK) | 當 USE_OTEL_LITELLM_REQUEST_SPAN=true(proxy)或不存在父層 context(SDK)時。於 semconv mode 中會替換為 {operation} {model} |
raw_gen_ai_request | INTERNAL | 若存在則為 litellm_request,否則為 proxy root | 每個上游提供者呼叫一次。會透過 llm.{provider}.* 攜帶提供者原生 request/response。於 semconv mode 且停用 message content capture 時會被抑制 |
guardrail | INTERNAL(OpenInference kind = guardrail) | 若存在則為 litellm_request,否則為 proxy root | 每次防護欄執行一個 span(pre-call、during-call 或 post-call) |
Failed Proxy Server Request | INTERNAL | proxy root | 當 proxy 在完成請求前拋出例外時 |
{route}(例如 /user/info、/key/info) | INTERNAL | proxy root | 管理端點呼叫(非 LLM proxy 路由) |
auth、router、self、proxy_pre_call、redis、postgres、batch_write_to_db、reset_budget_job、pod_lock_manager | INTERNAL | proxy root | 服務 hook spans——見下方 |
服務 hook spans(又稱「基礎設施」spans)
LiteLLM 有一個獨立的 hook(async_service_success_hook / async_service_failure_hook),會記錄內部子系統的時間,例如 router、auth 檢查、Redis、Postgres,以及 proxy pre-call pipeline。當 OTEL 整合啟用且 context 中存在父層 span 時,這些 hooks 會各自建立一個 INTERNAL 子 span。
span 名稱就是 ServiceTypes enum 值(auth、router、self、proxy_pre_call、redis、postgres、…)。完整集合定義於 litellm/types/services.py。self 是 LiteLLM SDK 本身(例如 make_openai_chat_completion_request 的時間);router 可能在每個請求中出現多次(一次用於 async_get_available_deployment,一次用於包裹的 acompletion)。
每個 service-hook span 會帶有:
| 屬性 | 值 |
|---|---|
service | 服務 enum 值(例如 "router"、"redis") |
call_type | 特定操作(例如 "async_get_available_deployment"、"acompletion"、"add_litellm_data_to_request") |
error | 僅在失敗 spans 上設定 |
| (自訂 event_metadata) | 呼叫端附加的任何內容 |
這些 spans 是營運/基礎設施 spans,不是 GenAI 語意 spans。它們適用於 SRE 等級的除錯(LiteLLM 內部的時間都花在哪裡?),但它們不會帶有 gen_ai.* 屬性。若您只想在後端保留 AI 語意 spans,請依 gen_ai.system(或 span 名稱)是否存在來過濾。
目前沒有可停用單一 service-hook span 的環境變數。若您需要過濾它們,請在 OTLP collector/後端層處理(例如透過依 name 丟棄的 tail-based sampler)。
為什麼我看不到 litellm_request span?
行為在 v1.81.0 有變更。預設情況下,USE_OTEL_LITELLM_REQUEST_SPAN=false,而 proxy 會將 litellm_request span 折疊到父 Received Proxy Server Request span 中,並改為將其 gen_ai.* 屬性設到父層。這會:
- 避免在父層與子層之間重複屬性。
- 將 span 數量(以及儲存成本)每個請求約減少 1 個 span。
- 在已存在父層 context 時,維持 trace 較淺。
若要還原較早的巢狀行為,也就是每次 LLM 呼叫都會有自己作為 proxy root span 子項的 litellm_request span,請設定:
USE_OTEL_LITELLM_REQUEST_SPAN=true
若符合以下情況,這是正確的設定:
- 一個 HTTP 請求會進行多個
litellm.completion呼叫,而在預設行為下,最後一次呼叫的屬性會覆蓋共用父層上較早的屬性。 - 您希望為
raw_gen_ai_request和guardrail子項保留一個乾淨的父層,而且不是 HTTP 請求 span。 - 您後端的 UI 是以像
litellm_request這類 AI 語意的 span 名稱為基礎。
這不是回歸問題;這個變更是刻意設計的。此旗標會在每次請求時重新讀取,因此可在不重新啟動的情況下切換。
在 semconv mode(OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental)中,相同的 USE_OTEL_LITELLM_REQUEST_SPAN gating 仍決定是否發出 LLM-call span;semconv mode 只會改變 span 的名稱(變為 {operation} {model})、類型(變為 CLIENT)以及子層結構。
Context 傳遞(W3C traceparent)
LiteLLM 會遵循 W3C Trace Context 標頭。如果您的用戶端(或上游閘道)傳送 traceparent 標頭,LiteLLM 會將 Received Proxy Server Request span 建立為該外部追蹤的子項,因此 LiteLLM 的 spans 會內嵌顯示在您的應用程式既有的分散式追蹤中。
父層 context 的解析順序(優先順序由高到低):
- 在請求
metadata中明確指定litellm_parent_otel_span。 - 傳入的
traceparentHTTP 標頭(透過TraceContextTextMapPropagator擷取)。 - OTEL 全域內容中目前作用中的 span(執行緒區域)。
- 無;LiteLLM 的 span 會是根。
若要強制每個 LiteLLM 追蹤都成為自己的根節點,不論傳入標頭或作用中的 context 為何,請設定 OTEL_IGNORE_CONTEXT_PROPAGATION=true。
執行多個 OpenTelemetry 處理器
您可以在同一個程序中執行多個 OpenTelemetry 處理器,例如通用 OTLP exporter 與特定後端的子類別並行。請在第一個之後的每個處理器上設定 skip_set_global=True,讓每個處理器都擁有自己私有的 TracerProvider、MeterProvider 與 LoggerProvider。之後 spans、metrics 與 log events 只會透過該處理器的 exporter 傳送。
import litellm
from litellm.integrations.opentelemetry import OpenTelemetry, OpenTelemetryConfig

# Primary handler. Claims the global TracerProvider.
primary = OpenTelemetry(config=OpenTelemetryConfig(
    exporter="otlp_http",
    endpoint="https://your-collector/v1/traces",
))

# Secondary handler. Has its own private providers.
secondary = OpenTelemetry(config=OpenTelemetryConfig(
    exporter="otlp_http",
    endpoint="https://second-collector/v1/traces",
    skip_set_global=True,
))

litellm.callbacks = [primary, secondary]
初始化順序沒有影響。不論哪個先建立,兩個處理器都會接收到各自的 spans。
跨收集器行為(例如 LangSmith + 通用 OTEL)
當兩個會發出 OTEL 的整合同時啟用時,例如自訂的 LangSmith OTEL handler 加上通用的 otel exporter,兩者都會遵循相同的 traceparent 傳播規則,以及 Context propagation 中描述的相同父層解析順序。只要其中一個 handler 使用 skip_set_global=True,兩者都會:
- 看到同一個
trace_id對應於給定請求。 - 產生相同的 span 階層(
Received Proxy Server Request→litellm_request(若啟用)→raw_gen_ai_request/guardrail)。 - 只會在將 spans 傳送到哪個 exporter 上不同。
如果自訂的 LangSmith OTEL 處理器被設定為僅在請求帶有 litellm_request 時掛載 traceparent(否則不執行任何動作),通用 OTEL 處理器仍會輸出完整的階層。由於 span 名稱與屬性都相同,兩種檢視可以各自獨立閱讀。
擷取訊息內容
LiteLLM 使用標準的 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT 環境變數來控制是否擷取 prompts 與 completions,以及擷取位置:
# Do not capture message content
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=NO_CONTENT

# Capture content on span attributes only
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=SPAN_ONLY

# Capture content on event attributes only
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=EVENT_ONLY

# Capture content on both spans and events
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=SPAN_AND_EVENT
也支援布林形式:true 對應到 EVENT_ONLY,false 對應到 NO_CONTENT。
每個處理器的內容政策
當執行多個 OpenTelemetry 處理器時,請在每個 capture_message_content 上設定 OpenTelemetryConfig,讓處理器可以有不同的內容政策。範例來說,可將完整 prompts 傳送到除錯後端,同時從重視合規性的 OTLP collector 中移除內容:
import litellm
from litellm.integrations.opentelemetry import OpenTelemetry, OpenTelemetryConfig

stripped = OpenTelemetry(config=OpenTelemetryConfig(
    exporter="otlp_http",
    endpoint="https://compliance-collector/v1/traces",
    capture_message_content="NO_CONTENT",
))

verbose = OpenTelemetry(config=OpenTelemetryConfig(
    exporter="otlp_http",
    endpoint="https://debug-collector/v1/traces",
    capture_message_content="SPAN_AND_EVENT",
    skip_set_global=True,
))

litellm.callbacks = [stripped, verbose]
解析順序(優先順序由高到低):
litellm.turn_off_message_logging=True強制NO_CONTENT(動態關閉開關;覆蓋下方所有設定)。OpenTelemetryConfig.capture_message_content(每個 handler 的欄位,在 handler 初始化時採樣)。OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT環境變數(在 handler 初始化時採樣)。- 舊版的每個實例
message_logging旗標,預設為True,並對應到SPAN_AND_EVENT。
選擇加入最新 GenAI 語意慣例
設定 OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental 以發出符合 最新 OpenTelemetry GenAI 語意慣例 的 spans:
OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental
這會變更 LLM 呼叫 span 的名稱、類型與結構,抑制非標準的 raw_gen_ai_request 子 span,新增 gen_ai.provider.name 屬性並與 gen_ai.system 並列,若有提供則填入額外的請求與 cache-token 屬性,並將每則訊息事件整併為單一 gen_ai.client.inference.operation.details 事件。各列差異請見下方的 Spans Reference 與 Attributes Reference。
OpenTelemetryConfig.semconv_stability_opt_in(一組 OTELSemconvCategory 值,例如 {OTELSemconvCategory.GEN_AI_LATEST_EXPERIMENTAL})是對應的程式化形式,並會與環境變數做聯集。依 OTEL 規格,這個旗標可用逗號分隔。
從 OpenTelemetry 記錄中移除訊息、回應內容
從所有 OpenTelemetry 記錄中移除訊息與回應
設定 litellm.turn_off_message_logging=True 這會防止訊息與回應被記錄到 OpenTelemetry,但請求中繼資料仍會被記錄。
從特定 OpenTelemetry 記錄中移除訊息與回應
OpenTelemetry logger 不會讀取 Langfuse 的 mask_input、mask_output 或 update_trace_keys 中繼資料鍵,因此在請求中傳遞它們會讓訊息內容保留在 spans 上。若要讓內容不要出現在特定的 OpenTelemetry handler 上,請為它提供自己的 capture_message_content="NO_CONTENT"(請參閱 Per-handler content policy),或設定 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=NO_CONTENT
疑難排解
我沒有看到 litellm_request span
v1.81.0+ 預設行為(USE_OTEL_LITELLM_REQUEST_SPAN=false):proxy root span 會吸收 LLM 呼叫屬性,且不會有獨立的 litellm_request span。若要恢復巢狀 spans,請設定 USE_OTEL_LITELLM_REQUEST_SPAN=true。請參考 為什麼我看不到 litellm_request span?。
如果您處於 semconv 模式,LLM 呼叫 span 仍然存在,但會重新命名為 {operation} {model}(例如 chat gpt-5.6-terra),因此請依 gen_ai.system 搜尋,而不是依字面名稱 litellm_request。
我只看到基礎架構 spans(router、auth、redis、proxy_pre_call)
那些是 service-hook spans。它們會與 AI 語意 spans(raw_gen_ai_request、guardrail,以及在啟用時的 litellm_request)一起發出,而不是取代它們。如果您在 trace 中任何地方都看不到 gen_ai.* 屬性:
- 驗證
litellm.callbacks(或litellm_settings.callbacks)包含"otel"。 - 驗證請求確實命中了
/chat/completions(或其他 LLM)路由。管理端點(/key/info、/user/info、…)不會有gen_ai.*屬性。 - 檢查是否設定了
litellm.turn_off_message_logging=true或NO_CONTENT擷取模式,因為它們會抑制訊息和原始提供者屬性。 - 設定
USE_OTEL_LITELLM_REQUEST_SPAN=true,讓 LLM 屬性落在名為litellm_request的 span 上,而不是與 HTTP 請求屬性混在Received Proxy Server Request上。
在失敗請求上追蹤 LiteLLM Proxy 的使用者/金鑰/組織/團隊資訊
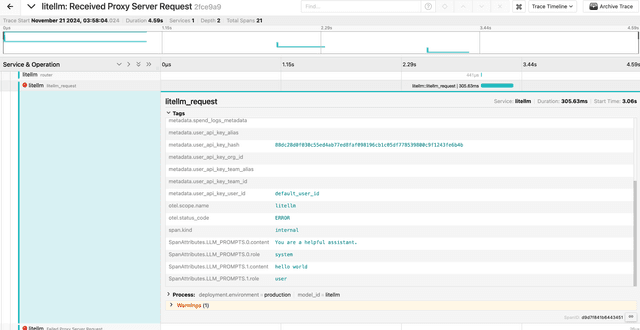
LiteLLM 會在成功與失敗的請求上都發出 metadata.user_api_key_* 屬性(金鑰雜湊、金鑰別名、組織 ID、使用者 ID、團隊 ID)。若有,它們會出現在 litellm_request span 上,否則會出現在 Received Proxy Server Request 上。
沒有看到 traces 送達 Integration
如果您沒有看到 traces 送達您的整合,請在 LiteLLM 環境中設定 DEBUG_OTEL="True",然後再試一次。
export DEBUG_OTEL="True"
這會將任何記錄問題輸出到主控台。常見原因:
OTEL_EXPORTER_OTLP_ENDPOINT指向 HTTPS 端點,但協定是grpc(或反之)。OTEL_HEADERS缺少後端預期的驗證標頭。- 防火牆/sidecar 正在封鎖 4317/4318 的對外 OTLP 流量。
- 對於 gRPC,未安裝
grpcio(uv add "litellm[grpc]")。
spans 被截斷或捨棄
OTLP 匯出器會批次處理 span。非常大的 gen_ai.input.messages/gen_ai.output.messages(例如多 MB 的提示)可能會超過收集器預設的 OTLP 屬性大小限制。您可以:
- 將大型負載移出 trace(設定
litellm.turn_off_message_logging=true,並依賴 Spend Logs / cold storage,透過metadata.cold_storage_object_key參照)。 - 提高收集器的
max_attribute_value_length和 OTLP receiver 的max_recv_msg_size_mib。
控制 metric 屬性的基數
啟用 metrics 時,每個 gen_ai.client.* sample 都會附上一組共通屬性,因此您可以依模型、提供者、key 和 team 切分直方圖。預設下,這組屬性也包含每個請求的欄位,例如 hidden_params 和數個 metadata.* 值。這些值對每個請求來說幾乎都是唯一的,因此每一個都會讓後端追蹤的 time series 數量倍增(每種不同的屬性組合各一條 series)。在大量流量下,這會讓 metric 基數爆增,而有些後端,例如 Splunk Observability Cloud,會開始節流或捨棄這些 metrics。
若要限制基數,請過濾要附加到 metrics 的屬性。在 attributes 底下巢狀加入 callback_settings.otel 區塊,並使用 include_list(allowlist;只輸出列出的屬性)或 exclude_list(denylist;輸出除列出屬性之外的全部屬性)。兩者互斥,若同時設定,啟動時會引發設定錯誤。若沒有 attributes 區塊,行為維持不變,且會輸出每個屬性,因此既有 dashboard 仍可正常運作。
此過濾器只套用於 metrics。Span 會保留完整屬性集合,因此 trace 仍然豐富,同時 metric 基數保持受限。
排除高基數屬性(exclude_list)
最常見的情境。保留穩定的識別屬性,並移除會驅動基數的每請求 blob。
litellm_settings:
  callbacks: ["otel"]

callback_settings:
  otel:
    attributes:
      exclude_list:
        - hidden_params
        - metadata.requester_metadata
        - metadata.requester_ip_address
        - metadata.spend_logs_metadata
        - metadata.mcp_tool_call_metadata
        - metadata.vector_store_request_metadata
        - metadata.prompt_management_metadata
只輸出明確指定的集合(include_list)
當您想要最小且最可預測的屬性集合時,請精確列出要保留的屬性。未列出的項目都會從 metrics 中移除。
litellm_settings:
  callbacks: ["otel"]

callback_settings:
  otel:
    attributes:
      include_list:
        - gen_ai.operation.name
        - gen_ai.system
        - gen_ai.request.model
        - gen_ai.framework
        - metadata.user_api_key_team_id
        - metadata.user_api_key_org_id
gen_ai.token.type 無法被過濾。它是於過濾後加到 input 與 output token series 上的結構性區分器,讓兩者保持不同;若將它列入 include_list 或 exclude_list,會在啟動時遭拒絕,而不是靜默忽略。
有效的屬性名稱
這兩個清單都會在啟動時依下列集合驗證。未知名稱會引發設定錯誤,因此拼字錯誤絕不會悄悄回退為輸出所有屬性。有效名稱包括 gen_ai.* core attributes、hidden_params,以及 metadata.* keys:
gen_ai.operation.namegen_ai.systemgen_ai.request.modelgen_ai.frameworkhidden_paramsmetadata.user_api_key_hashmetadata.user_api_key_aliasmetadata.user_api_key_team_idmetadata.user_api_key_org_idmetadata.user_api_key_user_idmetadata.user_api_key_team_aliasmetadata.user_api_key_user_emailmetadata.user_api_key_end_user_idmetadata.spend_logs_metadatametadata.requester_ip_addressmetadata.requester_metadatametadata.prompt_management_metadatametadata.applied_guardrailsmetadata.mcp_tool_call_metadatametadata.vector_store_request_metadata
設定參考
除非另有註明,以下所有旗標都從環境變數讀取。布林旗標接受 true/false(不區分大小寫)。
匯出器與資源
| 變數 | 預設值 | 用途 |
|---|---|---|
OTEL_EXPORTER(別名:OTEL_EXPORTER_OTLP_PROTOCOL) | console | 匯出器類型。常見值:console、otlp_http、otlp_grpc、http/json、http/protobuf、grpc |
OTEL_ENDPOINT(別名:OTEL_EXPORTER_OTLP_ENDPOINT) | none | OTLP 端點 URL |
OTEL_HEADERS(別名:OTEL_EXPORTER_OTLP_HEADERS) | none | 以逗號分隔的 key=value,key2=value2 標頭清單 |
OTEL_SERVICE_NAME | litellm | 資源屬性 service.name |
OTEL_ENVIRONMENT_NAME | production | 資源屬性 deployment.environment |
OTEL_MODEL_ID | OTEL_SERVICE_NAME | 資源屬性 model_id |
OTEL_TRACER_NAME | litellm | Tracer 名稱 |
LITELLM_METER_NAME | litellm | Meter 名稱(啟用 metrics 時) |
LITELLM_LOGGER_NAME | litellm | Logger 名稱(啟用 events 時) |
OTEL_LOGS_EXPORTER | none | 啟用 events 時的 logs 匯出器(例如 console) |
當 otlp_http exporter 與位於內部 CA 之後的 collector 通訊時,會遵守 SSL_CERT_FILE(CA bundle 的路徑)與 litellm_settings.ssl_verify(false 會停用驗證)。OpenTelemetry SDK 自身的 OTEL_EXPORTER_OTLP_CERTIFICATE 在設定時仍然優先
Span / metric / event 切換
| 變數 | 預設值 | 效果 |
|---|---|---|
USE_OTEL_LITELLM_REQUEST_SPAN | false | 強制 litellm_request 一律以 proxy root span 的子項形式發出。請參閱 Why don't I see a litellm_request span? |
OTEL_SEMCONV_STABILITY_OPT_IN | 未設定 | 設為 gen_ai_latest_experimental 以切換到 最新的 GenAI semantic conventions。依 OTEL 規格可用逗號分隔 |
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT | 未設定 → 回退到舊版 message_logging(預設 True → SPAN_AND_EVENT) | NO_CONTENT / SPAN_ONLY / EVENT_ONLY / SPAN_AND_EVENT。接受布林形式(true→EVENT_ONLY,false→NO_CONTENT) |
LITELLM_OTEL_INTEGRATION_ENABLE_METRICS | false | 啟用 OTLP metrics(TTFT、TPOT、回應持續時間、成本、token 使用量、操作持續時間) |
LITELLM_OTEL_INTEGRATION_ENABLE_EVENTS | false | 啟用 OTLP semantic logs(gen_ai.content.prompt/gen_ai.content.completion,或在 semconv 模式下為 gen_ai.client.inference.operation.details) |
OTEL_IGNORE_CONTEXT_PROPAGATION | false | 若為 true,則忽略傳入的 traceparent 標頭與任何作用中的 span——每個 LiteLLM trace 都會變成自己的根 |
DEBUG_OTEL | false | 將 exporter 與 span 建立診斷輸出到 stderr |
litellm.turn_off_message_logging(Python 全域 / litellm_settings.turn_off_message_logging) | false | 內容擷取的關閉開關。會抑制 llm.{provider}.* 原始請求/回應、gen_ai.input.messages、gen_ai.output.messages 與 gen_ai.content.* 記錄事件。會覆蓋每個 handler 的 capture_message_content |
每個請求的 metadata 金鑰
Langfuse 的 mask_input、mask_output 與 update_trace_keys 金鑰對 OpenTelemetry spans 沒有效果。請使用 litellm.turn_off_message_logging 或 NO_CONTENT 擷取模式來遮蔽內容。
| 金鑰 | 效果 |
|---|---|
generation_name | 以此值覆寫 raw_gen_ai_request span 的名稱 |
OpenTelemetryConfig 程式化等價設定
| 欄位 | 預設值 | 用途 |
|---|---|---|
exporter | console | 同 OTEL_EXPORTER |
endpoint | 無 | 同 OTEL_ENDPOINT |
headers | 無 | 同 OTEL_HEADERS |
enable_metrics | false | 同 LITELLM_OTEL_INTEGRATION_ENABLE_METRICS |
enable_events | false | 同 LITELLM_OTEL_INTEGRATION_ENABLE_EVENTS |
capture_message_content | 環境變數 | 每個 handler 的覆寫;與 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT 具有相同的值空間 |
semconv_stability_opt_in | 空集合 | OTELSemconvCategory 值的集合,與 OTEL_SEMCONV_STABILITY_OPT_IN 取聯集 |
skip_set_global | false | 不要宣稱 process-global 的 TracerProvider/MeterProvider/LoggerProvider |
ignore_context_propagation | false | 同 OTEL_IGNORE_CONTEXT_PROPAGATION |
attributes | 無 | metrics 屬性包含/排除篩選器。請參閱 Control metric attribute cardinality |
附錄:Span、Metric 與屬性參考
本附錄列舉 LiteLLM 發出的每一個 span、metric 與 AI 語義屬性,包括在啟用 semconv 模式 時各自如何變化。
Span 參考
LLM 呼叫 span 是 AI 語義的核心。其名稱、類型與支援的子 span 取決於 semconv 模式是否啟用。
| Span | 類型 | 預設模式 | Semconv 模式 |
|---|---|---|---|
| Proxy request frame | SERVER | Received Proxy Server Request | Received Proxy Server Request(不變) |
| LLM-call span | INTERNAL(預設) / CLIENT(semconv) | litellm_request(僅在 USE_OTEL_LITELLM_REQUEST_SPAN=true 時);否則屬性會落在 proxy frame span 上 | {operation} {model}(例如 chat gpt-4、embeddings text-embedding-3-small);與預設模式相同的 USE_OTEL_LITELLM_REQUEST_SPAN 閘控 |
| 原始提供者負載 | INTERNAL | raw_gen_ai_request(在允許擷取訊息內容時) | 不會發出(資料存在 LLM-call span 與彙總事件中) |
| 防護欄檢查 | INTERNAL | 每次防護欄呼叫一個 span,依防護欄命名 | 不變 |
| 管理端點 | INTERNAL | 每次 proxy 管理呼叫一個 span,依端點命名 | 不變 |
semconv 模式下發出的 operation 名稱:chat(預設)、embeddings(當呼叫類型包含 embedding 時)、text_completion(當呼叫類型包含 text_completion 時)。
事件參考
當在設定中啟用 LoggerProvider 時,事件會落在 LiteLLM 管理的 enable_events=True 上。
| 事件 | 預設模式 | Semconv 模式 |
|---|---|---|
| 每則訊息的 prompt | gen_ai.content.prompt(每個輸入訊息一個事件) | 由彙總事件取代 |
| 每個選項的 completion | gen_ai.content.completion(每個選項一個事件) | 由彙總事件取代 |
| 彙總的推論詳細資料 | 不會發出 | gen_ai.client.inference.operation.details(每次呼叫一個事件,依規格承載 gen_ai.input.messages 與 gen_ai.output.messages 陣列) |
Metric 參考
當在 enable_metrics=True 上設定 OpenTelemetryConfig 時,LiteLLM 會發出下列 histogram。Metric 名稱符合 OTEL GenAI 語義慣例。
| 指標 | 單位 | 說明 |
|---|---|---|
gen_ai.client.operation.duration | s | 包含 LiteLLM 額外負擔的端到端操作持續時間。 |
gen_ai.client.token.usage | {token} | Token 用量。每次呼叫記錄兩個 histogram(標籤 gen_ai.token.type 為 "input" 或 "output")。 |
gen_ai.usage.cost | USD | 計算出的請求成本。 |
gen_ai.server.time_to_first_token | s | 從請求開始到第一個串流 token 的時間(僅限串流請求)。 |
gen_ai.server.time_per_output_token | s | 每個輸出 token 的平均時間(生成時間 / completion token)。 |
gen_ai.client.response.duration | s | LLM API 生成時間,不含 LiteLLM 額外負擔。 |
gen_ai.usage.cost、gen_ai.server.time_to_first_token 和 gen_ai.server.time_per_output_token 先前是以 gen_ai.client.token.cost、gen_ai.client.response.time_to_first_token 和 gen_ai.client.response.time_per_output_token 的形式發出。較早的拼法不是 GenAI 語意慣例,而且沒有任何供應商儀表板會查詢這些名稱,因此沒有任何預建內容可以繪製 LiteLLM 的成本或延遲。如果您曾針對舊名稱手動建立面板或警示,請將它們重新指向上述名稱
每個直方圖上的常見標籤:gen_ai.operation.name、gen_ai.request.model、gen_ai.framework="litellm"。當 LiteLLM 知道該請求的提供者時,會新增 gen_ai.system,因此沒有提供者的請求不會帶有 gen_ai.system 標籤。
| 常見 metric 需求 | 指標 |
|---|---|
| TTFT | gen_ai.server.time_to_first_token |
| TPS | 依 1 / gen_ai.server.time_per_output_token 推導 |
| Token 用量 | gen_ai.client.token.usage(依 gen_ai.token.type 拆分) |
| 提供者/模型延遲(不含額外負擔) | gen_ai.client.response.duration |
| 提供者/模型延遲(含額外負擔) | gen_ai.client.operation.duration |
Spans → 推導出的 Metric
即使關閉 metric,下面每個 metric 也都可以從 span 推導出來。這也是大多數儀表板的作法。
| 指標 | 如何從 span 推導 |
|---|---|
| TTFT(Time to First Token) | 僅限串流請求。使用專用的 gen_ai.server.time_to_first_token metric,或透過自訂回呼從請求 completion_start_time 擷取 kwargs。 |
| TPOT(Time per Output Token) | 使用 gen_ai.server.time_per_output_token metric,或推導為 gen_ai.client.response.duration ÷ gen_ai.usage.output_tokens。 |
| 總回應持續時間 | gen_ai.client.response.duration metric,或 LLM-call span 的 end_time − start_time(或 proxy root span 減去 LiteLLM 額外負擔——請參閱 hidden_params.litellm_overhead_time_ms)。 |
| 提供者(提供者)延遲 | raw_gen_ai_request span 的持續時間(預設模式)——純粹等待上游提供者的時間。在 semconv 模式下,使用 gen_ai.client.response.duration。 |
| LiteLLM 額外負擔 | proxy root span 上的 hidden_params.litellm_overhead_time_ms。或 Received Proxy Server Request.duration − raw_gen_ai_request.duration。 |
| Token 用量 | LLM span 上的 gen_ai.usage.input_tokens、gen_ai.usage.output_tokens、gen_ai.usage.total_tokens(或 gen_ai.client.token.usage metric)。 |
| 成本 | LLM span 上的 gen_ai.cost.total_cost(以及 gen_ai.cost.* 的其餘部分);或 gen_ai.usage.cost metric。 |
| 防護欄評估時間 | 每個 guardrail span 的持續時間。以 guardrail_name 和 guardrail_mode 區分。 |
| Router / 驗證 / Redis / DB 延遲 | 對應 service-hook span 的持續時間(router、auth、redis、postgres、…)。 |
| 重試 / 備援次數 | proxy root span 上的 hidden_params.x-litellm-attempted-retries 與 hidden_params.x-litellm-attempted-fallbacks。 |
| 串流? | llm.is_streaming 屬性("True"/"False")。 |
屬性參考
設定在 LLM-call span 上的屬性。名稱遵循 OTEL GenAI semconv。
| 屬性 | 預設模式 | Semconv 模式 |
|---|---|---|
gen_ai.operation.name | litellm call_type(例如 acompletion) | semconv operation(chat、embeddings、text_completion) |
gen_ai.system | 提供者名稱(例如 openai) | 不變 |
gen_ai.provider.name | 未設定 | 提供者名稱(依規格重新命名的 Required 屬性) |
gen_ai.framework | litellm | litellm |
gen_ai.request.model | model | model |
gen_ai.request.max_tokens、temperature、top_p | 在請求中設定時 | 在請求中設定時 |
gen_ai.request.frequency_penalty、presence_penalty、top_k、seed、stop_sequences、stream、choice.count | 未設定 | 在請求中設定時 |
gen_ai.response.model、gen_ai.response.id、gen_ai.response.finish_reasons | 在回應中出現時 | 不變 |
gen_ai.usage.input_tokens、gen_ai.usage.output_tokens、gen_ai.usage.total_tokens | 在出現時 | 不變 |
gen_ai.usage.cache_creation.input_tokens、gen_ai.usage.cache_read.input_tokens | 未設定 | 在回應中出現時 |
gen_ai.input.messages、gen_ai.output.messages、gen_ai.system_instructions | 當訊息內容擷取允許時,為 JSON 編碼的 {role, parts: [...]} 物件陣列 | 不變 |
gen_ai.cost.input_cost、output_cost、total_cost(以及相關的成本明細 attrs) | LiteLLM 特定的成本屬性 | 不變 |
gen_ai.cost.*(成本明細,所有模式)
LiteLLM 會將 standard_logging_payload["cost_breakdown"] 中的每個鍵展開為 gen_ai.cost.{key}。目前可觀察到的鍵:
| 屬性 | 含義 |
|---|---|
gen_ai.cost.input_cost | Prompt token 成本(USD) |
gen_ai.cost.output_cost | Completion token 成本(USD) |
gen_ai.cost.total_cost | 收費總額(USD) |
gen_ai.cost.tool_usage_cost | 可歸因於 tool/function 呼叫的成本 |
gen_ai.cost.original_cost | 折扣前成本 |
gen_ai.cost.discount_percent、gen_ai.cost.discount_amount | 套用的折扣 |
gen_ai.cost.margin_percent、gen_ai.cost.margin_fixed_amount、gen_ai.cost.margin_total_amount | 利潤率組成項目 |
litellm.*(代理根節點與 LLM span)
| 屬性 | 值 |
|---|---|
litellm.call_id | 每次 litellm.completion 呼叫皆唯一。請用此將 trace 資料與 LiteLLM Spend Logs 及 LiteLLM UI 進行關聯 |
litellm.request.type | 與 call_type 相同(例如 acompletion、aembedding、aimage_generation) |
llm.*(代理根節點與 LLM span)
| 屬性 | 值 |
|---|---|
llm.request.type | LiteLLM call_type |
llm.is_streaming | "True" 或 "False" |
llm.user | user 參數(若已設定) |
llm.{provider}.*(原始提供者請求/回應,僅預設模式)
僅在 raw_gen_ai_request 上設定,以避免屬性重複。對於原始提供者請求本文中的每個鍵,LiteLLM 會輸出 llm.{provider}.{key}。原始回應本文亦同。
openai 的可觀察範例:
llm.openai.messages
llm.openai.model
llm.openai.temperature
llm.openai.max_tokens
llm.openai.id
llm.openai.object
llm.openai.created
llm.openai.choices
llm.openai.usage
llm.openai.system_fingerprint
llm.openai.service_tier
llm.openai.extra_body
對於 Anthropic,將 openai 替換為 anthropic(llm.anthropic.messages、llm.anthropic.stop_reason 等)。其他每個提供者也採用相同模式。
當 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=NO_CONTENT、當 litellm.turn_off_message_logging=true,或在 semconv 模式下(整個 raw_gen_ai_request span 都會被抑制)時,這些屬性會被抑制。
metadata.*(代理根節點,有時為 LLM span)
LiteLLM 會迭代 standard_logging_payload["metadata"],並將每個項目輸出為 metadata.{key}。常見鍵(非完整):
| 屬性 | 含義 |
|---|---|
metadata.user_api_key_hash | 使用之虛擬金鑰的 SHA 雜湊 |
metadata.user_api_key_alias | 虛擬金鑰別名 |
metadata.user_api_key_team_id、metadata.user_api_key_team_alias | 團隊識別碼 |
metadata.user_api_key_org_id、metadata.user_api_key_org_alias | 組織識別碼 |
metadata.user_api_key_user_id、metadata.user_api_key_user_email | LiteLLM 內部使用者識別碼 |
metadata.user_api_key_end_user_id | 在請求中傳入的終端使用者 |
metadata.user_api_key_project_id、metadata.user_api_key_project_alias | 專案識別碼 |
metadata.user_api_key_spend、metadata.user_api_key_max_budget、metadata.user_api_key_budget_reset_at | 預算狀態 |
metadata.user_api_key_request_route | 路由命中(例如 /v1/chat/completions) |
metadata.requester_ip_address、metadata.user_agent | 用戶端識別碼 |
metadata.requester_metadata、metadata.requester_custom_headers | 標頭與請求內容 |
metadata.applied_guardrails | 本次請求執行的防護欄清單 |
metadata.mcp_tool_call_metadata、metadata.vector_store_request_metadata | MCP 與向量儲存請求資訊 |
metadata.usage_object | 完整 token 用量物件 |
metadata.spend_logs_metadata | 持久化到 Spend Logs 的自訂中繼資料 |
metadata.cold_storage_object_key | 當請求負載卸載到冷儲存時 |
metadata.user_api_key_auth_metadata | 額外驗證內容 |
另外還有 hidden_params,這是一個單一屬性,包含一個 JSON 序列化的 dict,其中包括 litellm_overhead_time_ms、api_base、response_cost、additional_headers、model_id、x-litellm-attempted-retries、x-litellm-attempted-fallbacks 等。
防護欄 span 屬性
設定於每個 guardrail 子 span:
| 屬性 | 值 |
|---|---|
openinference.span.kind | "guardrail"(依 OpenInference 慣例) |
guardrail_name | 例如 "presidio-pii"、"lakera"、"aporia" |
guardrail_mode | "pre_call"、"during_call"、"post_call" 等 |
masked_entity_count | 若防護欄遮罩了實體 |
guardrail_response | 防護欄的回應/動作 |
該 span 的 start_time/end_time 來自防護欄本身的計時,因此 span 持續時間等於 防護欄評估時間。
目前沒有單獨的 guardrail_pre/guardrail_post span 名稱。兩者都會以 guardrail 發出,並透過 guardrail_mode 屬性加以區分。
服務回呼 span 屬性
請參閱 Service-hook spans。每個都包含 service、call_type、可選的 error,以及呼叫端附加的任何自訂事件中繼資料。
例外狀況屬性
在 Failed Proxy Server Request(以及任何失敗的 LLM 呼叫 span)上:
| 屬性 | 值 |
|---|---|
exception | str(original_exception) |
| Span status | StatusCode.ERROR |
資源屬性(每個 span)
| 屬性 | 預設值 | 覆寫 |
|---|---|---|
service.name | litellm | OTEL_SERVICE_NAME |
deployment.environment | production | OTEL_ENVIRONMENT_NAME |
model_id | 與 service.name 相符 | OTEL_MODEL_ID |
telemetry.sdk.{language,name,version} | 由 SDK 設定 | — |
穩定性
Span 名稱、metric 名稱,以及上述屬性集在 LiteLLM 的 patch 版本之間是穩定的。LLM 呼叫 span 的名稱與種類會在 預設模式與 Semconv 模式 之間變更,並透過文件所述的 opt-in flag 進行遷移,而非在版本之間變更。
支援
如有 LiteLLM OTEL 整合問題,請到 BerriAI/litellm 提出 issue。若有 OpenLLMetry / Traceloop semantic-convention 問題,請參閱 Slack 或寄信至 dev@traceloop.com。

