Parseable
Parseable 提供 LiteLLM SDK 與 LiteLLM Gateway 的設定指南。
總覽
透過 OpenTelemetry 將 LiteLLM traces、logs 與 metrics 傳送至 Parseable。SDK 整合會記錄來自呼叫 LiteLLM 的 Python 應用程式的 telemetry。Gateway 整合會記錄 gateway traces 與 Prometheus metrics,涵蓋 routing、失敗、spend、token usage、rate limits 與基礎架構相依性。
這兩種整合都會透過 OpenTelemetry Collector 傳送 telemetry。Collector 會儲存 Parseable 憑證,並將 traces、logs 與 metrics 路由至不同的資料集。
先決條件
您需要一個正在執行的 Parseable 執行個體、一個具有 ingest 存取權的 Parseable API key、一個 LiteLLM 可連線的 OpenTelemetry Collector,以及一個模型提供者 API key。
監控 LiteLLM
當您的 Python 應用程式匯入並呼叫 LiteLLM 時,請選擇 LiteLLM SDK。當應用程式透過中央 LiteLLM 端點傳送請求時,請選擇 LiteLLM Gateway。
- LiteLLM SDK
- LiteLLM Gateway
建立獨立的 Parseable 資料集用於 traces、logs 與 metrics,然後設定 OpenTelemetry Collector 將每個訊號轉送出去。請參閱 Parseable LiteLLM SDK 指南 以了解資料集與 Collector 設定。
- No Code (Recommended)
- Code
步驟 1: 安裝 LiteLLM 與 OpenTelemetry 套件。
pip install litellm \
  opentelemetry-api \
  opentelemetry-sdk \
  opentelemetry-exporter-otlp
步驟 2: 在進行 LiteLLM 呼叫之前啟用 OpenTelemetry 回呼。
import litellm

litellm.callbacks = ["otel"]
步驟 3: 將 LiteLLM 指向 OpenTelemetry Collector。
export OTEL_EXPORTER="otlp_http"
export OTEL_ENDPOINT="http://localhost:4318"
export OTEL_SERVICE_NAME="litellm-sdk"
export LITELLM_OTEL_V2="true"
export LITELLM_OTEL_INTEGRATION_ENABLE_METRICS="true"
export LITELLM_OTEL_INTEGRATION_ENABLE_EVENTS="true"
export USE_OTEL_LITELLM_REQUEST_SPAN="true"
export OTEL_SEMCONV_STABILITY_OPT_IN="gen_ai_latest_experimental"
export OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT="no_content"
LITELLM_OTEL_INTEGRATION_ENABLE_EVENTS 會將 GenAI events 匯出為 logs。USE_OTEL_LITELLM_REQUEST_SPAN 與 OTEL_SEMCONV_STABILITY_OPT_IN 會建立 Parseable 儀表板查詢所使用的 CLIENT spans。
步驟 4: 執行應用程式。
import litellm

litellm.callbacks = ["otel"]

response = litellm.completion(
    model="openai/gpt-5.6-luna",
    messages=[{"role": "user", "content": "What is observability?"}],
)

print(response.choices[0].message.content)
當您需要啟用 GenAI events 與 metrics,或控制訊息擷取與 semantic convention 設定時,請使用以程式碼為基礎的設定。
步驟 1: 安裝 LiteLLM 與 OpenTelemetry 套件。
pip install litellm \
  opentelemetry-api \
  opentelemetry-sdk \
  opentelemetry-exporter-otlp
步驟 2: 設定 LiteLLM OpenTelemetry 回呼。
import litellm

litellm.callbacks = ["otel"]
步驟 3: 發出一個 LiteLLM 請求。
response = litellm.completion(
    model="openai/gpt-5.6-luna",
    messages=[
        {"role": "user", "content": "Explain distributed tracing."}
    ],
    metadata={"mask_input": True, "mask_output": True},
)

print(response.choices[0].message.content)
USE_OTEL_LITELLM_REQUEST_SPAN=true 會為每個 SDK 請求建立一個 model-call span。OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT="no_content" 與 request-level masking 可避免原始 prompts 與 responses 被匯出的 telemetry 送出。
在 Parseable 中檢視 Traces、Logs 與 Metrics
從 Traces 頁面開啟 <sdk-traces-dataset>,從 Logs 頁面開啟 <sdk-logs-dataset>,以及從 Metrics 頁面開啟 <sdk-metrics-dataset>。SDK metrics 包含請求持續時間、token usage、cost 與串流延遲。
Parseable SDK 指南 提供 Collector 管線、資料集標頭、SQL 查詢與疑難排解步驟。
儀表板
LiteLLM SDK Observability 儀表板 包含九個區段共 50 個圖磚。其 SQL 查詢結合 LiteLLM logs、traces 與 metrics,以涵蓋請求健康狀態、延遲、token usage、spend 與 telemetry 品質。
將 JSON 範本匯入 Parseable。將 Logs Dataset 設為 <sdk-logs-dataset>,Traces Dataset 設為 <sdk-traces-dataset>,以及 Metrics Dataset 設為 <sdk-metrics-dataset>。使用 Service、Environment、Request Model、Provider 與 Log Level 變數來篩選儀表板圖磚。
模型與使用情況
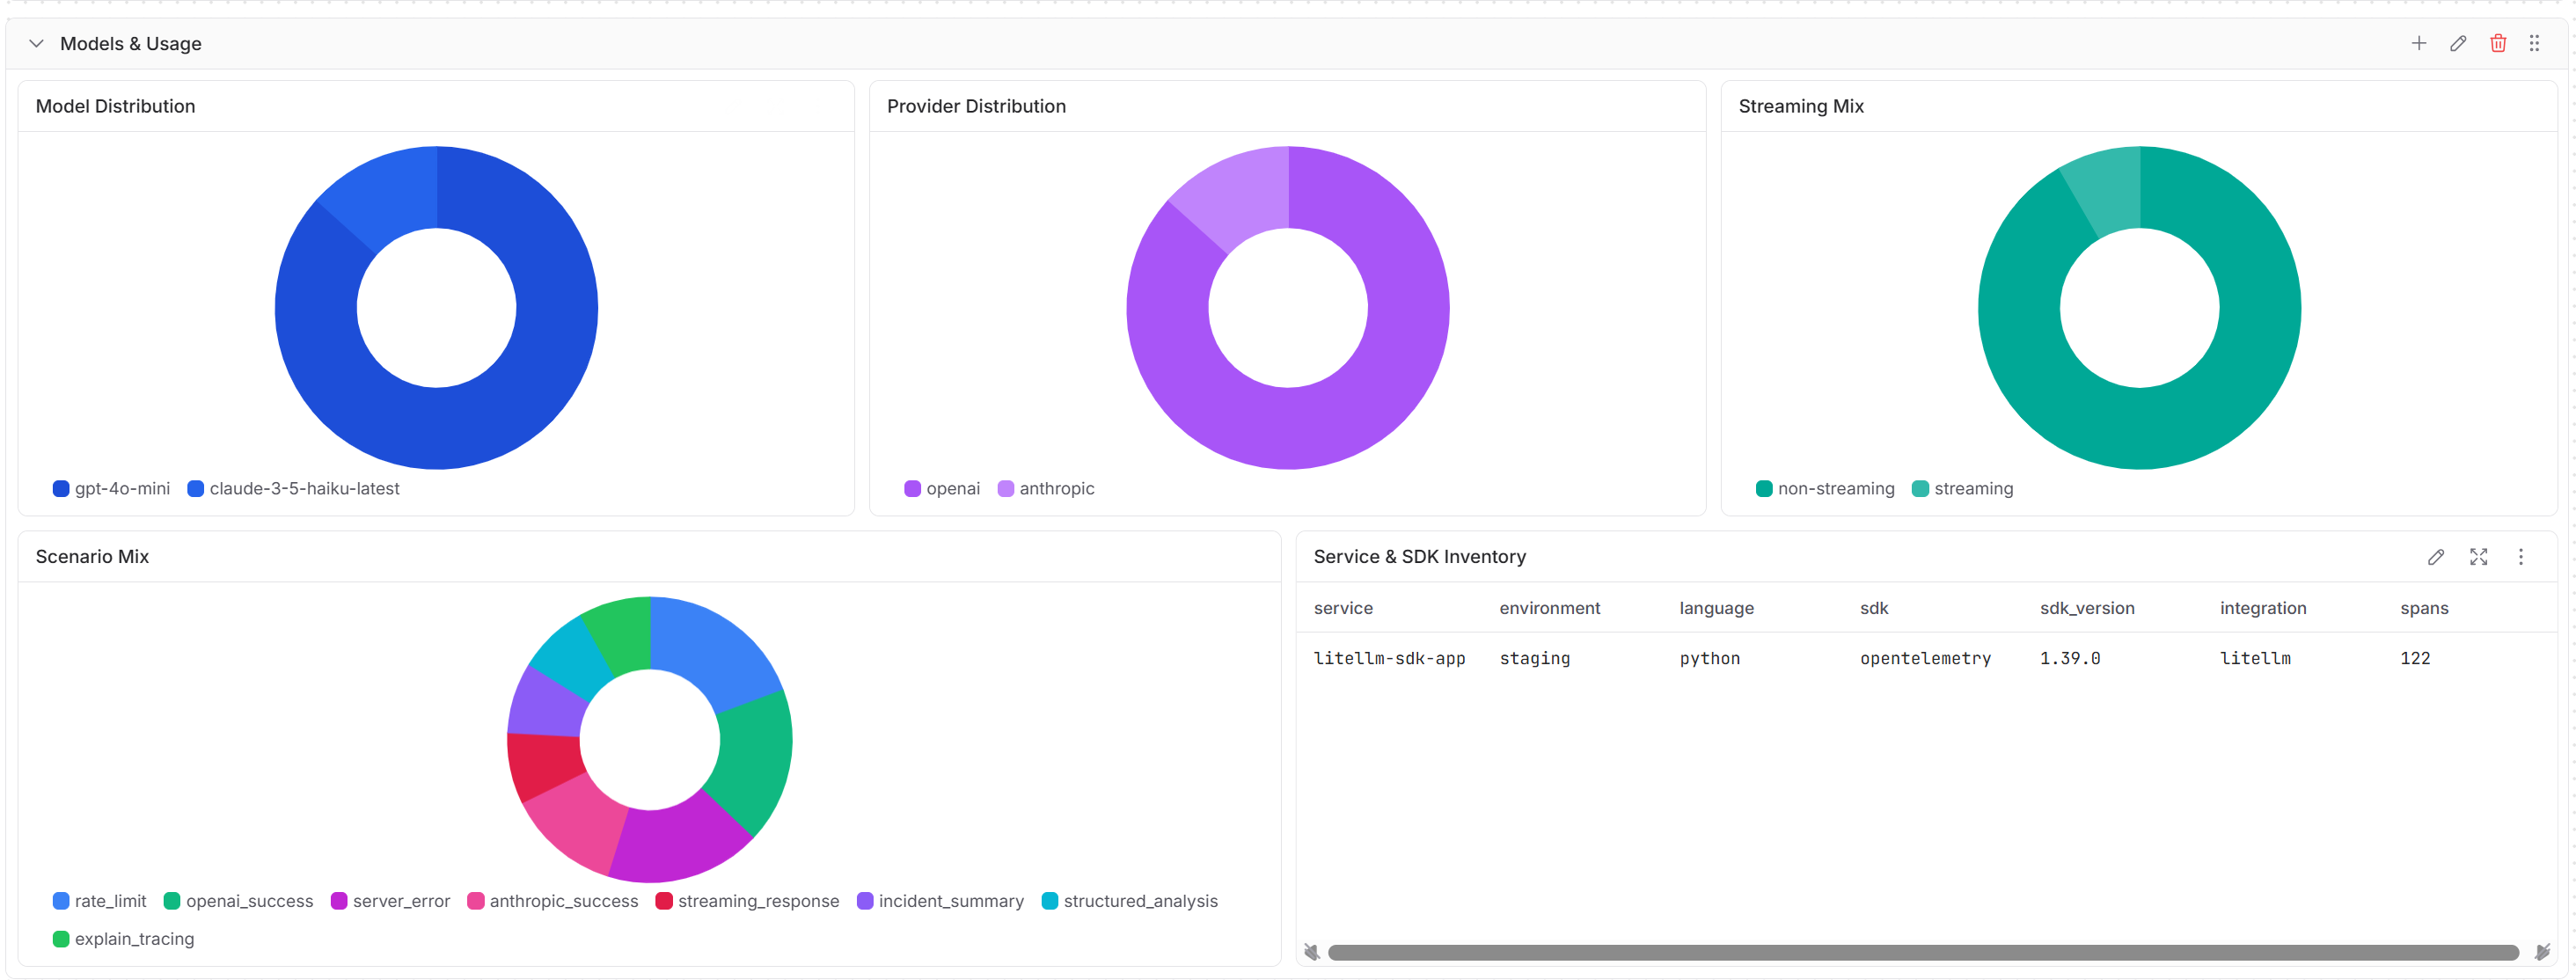
Models and Usage 區段顯示模型與提供者分布、串流使用情況、情境分布與 SDK 清單。可用來比較不同模型的流量,並確認哪些服務與 SDK 版本產生 telemetry。
Token 與成本
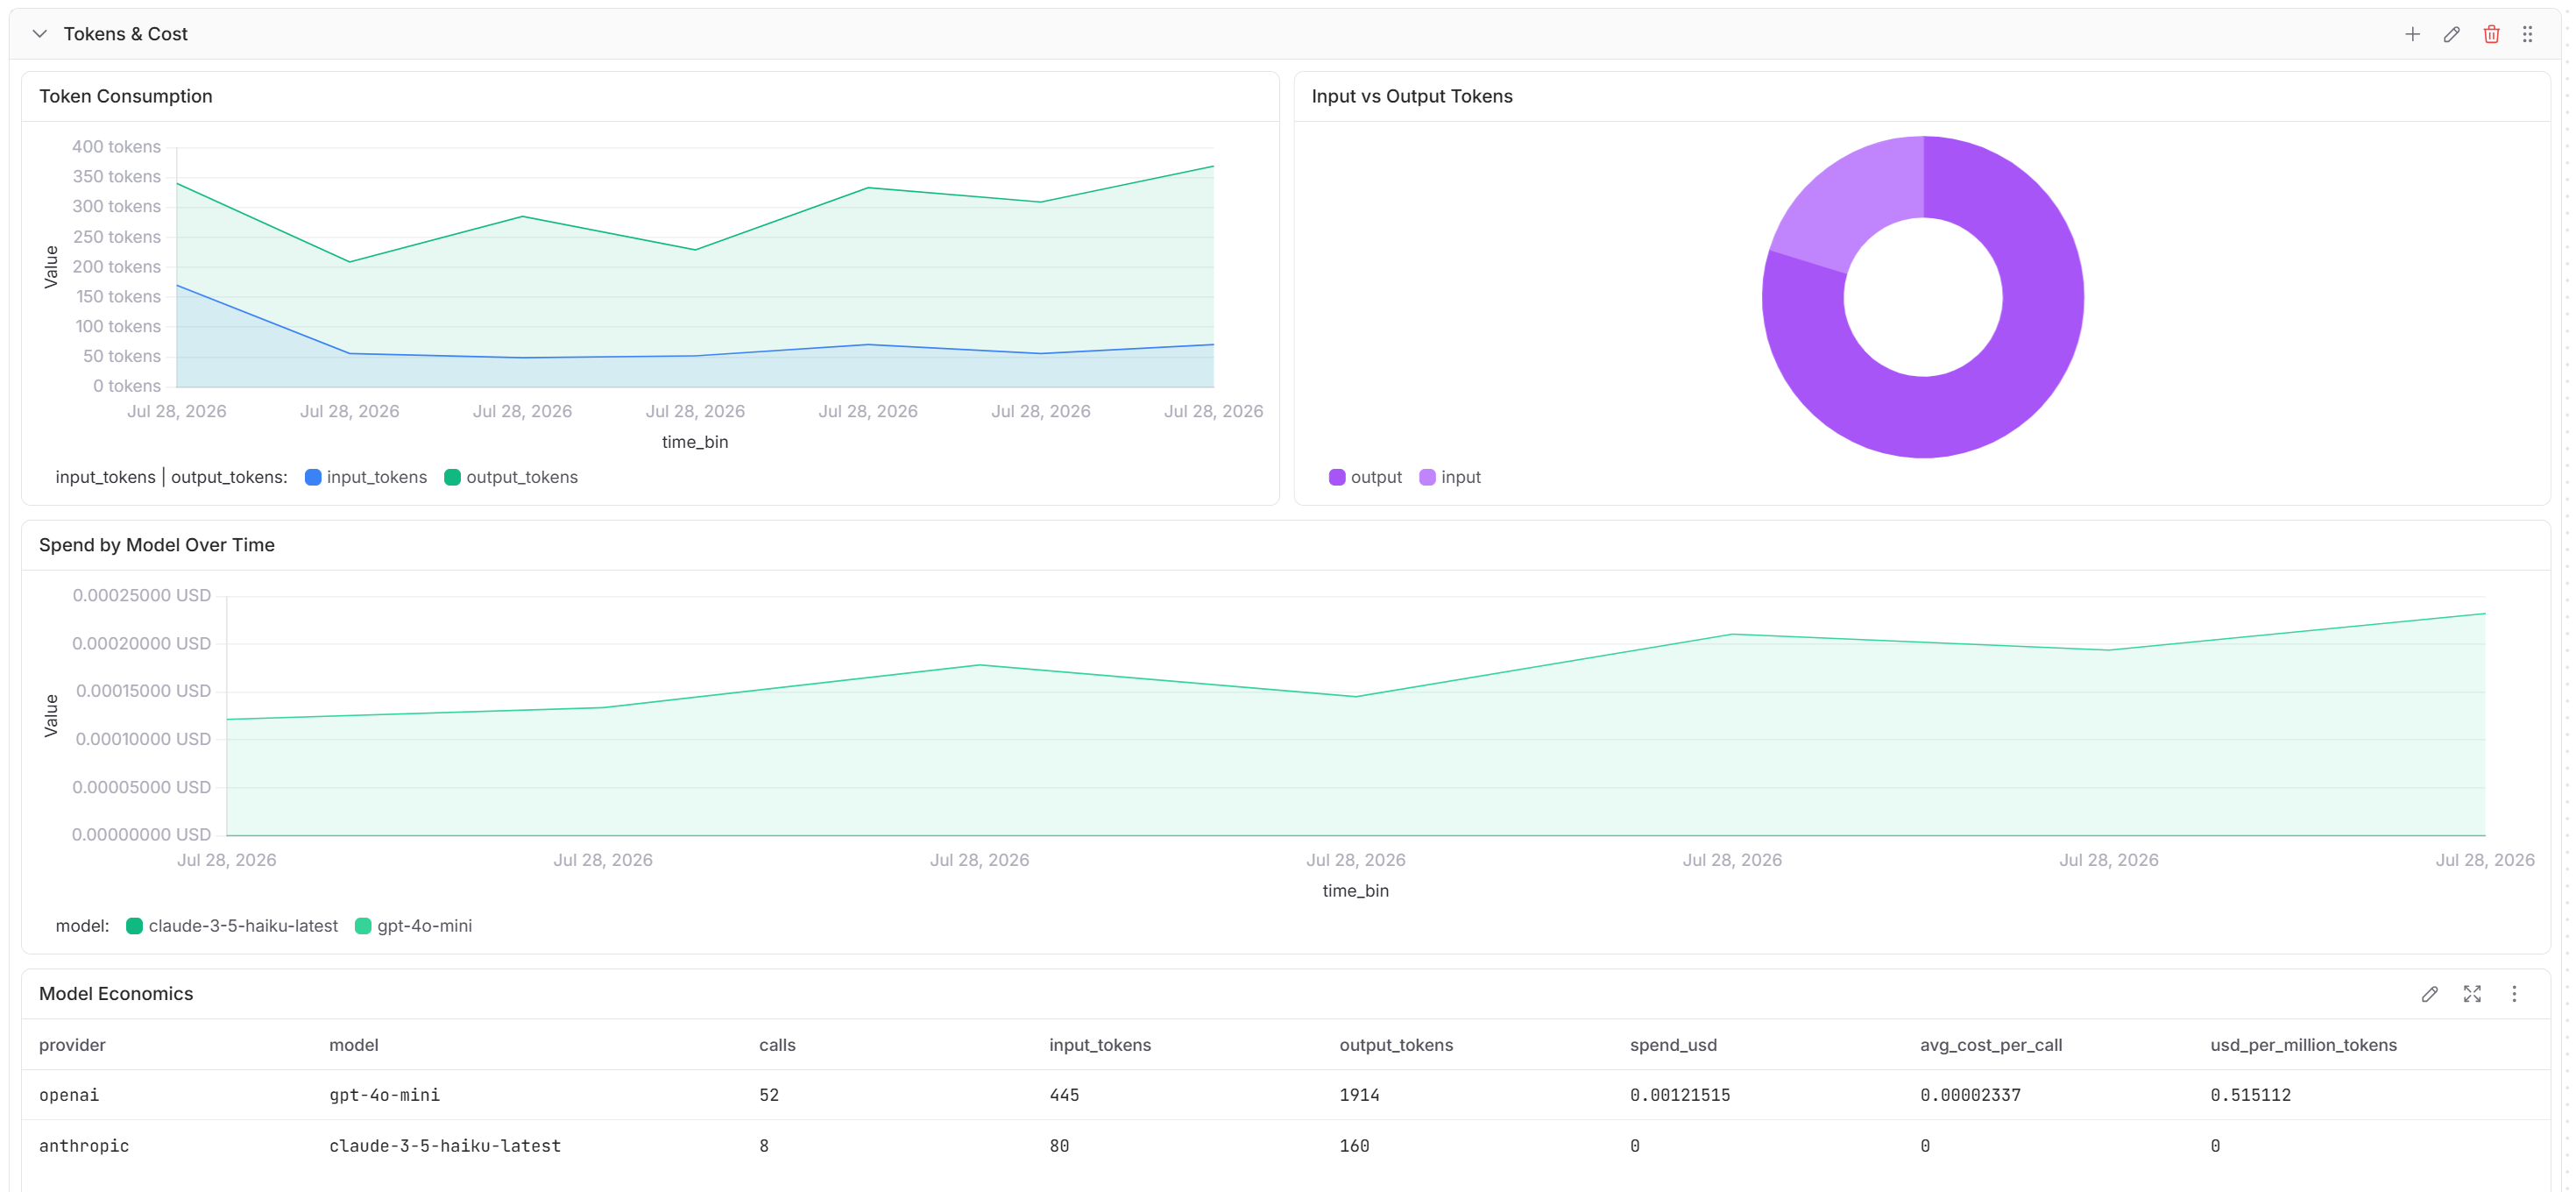
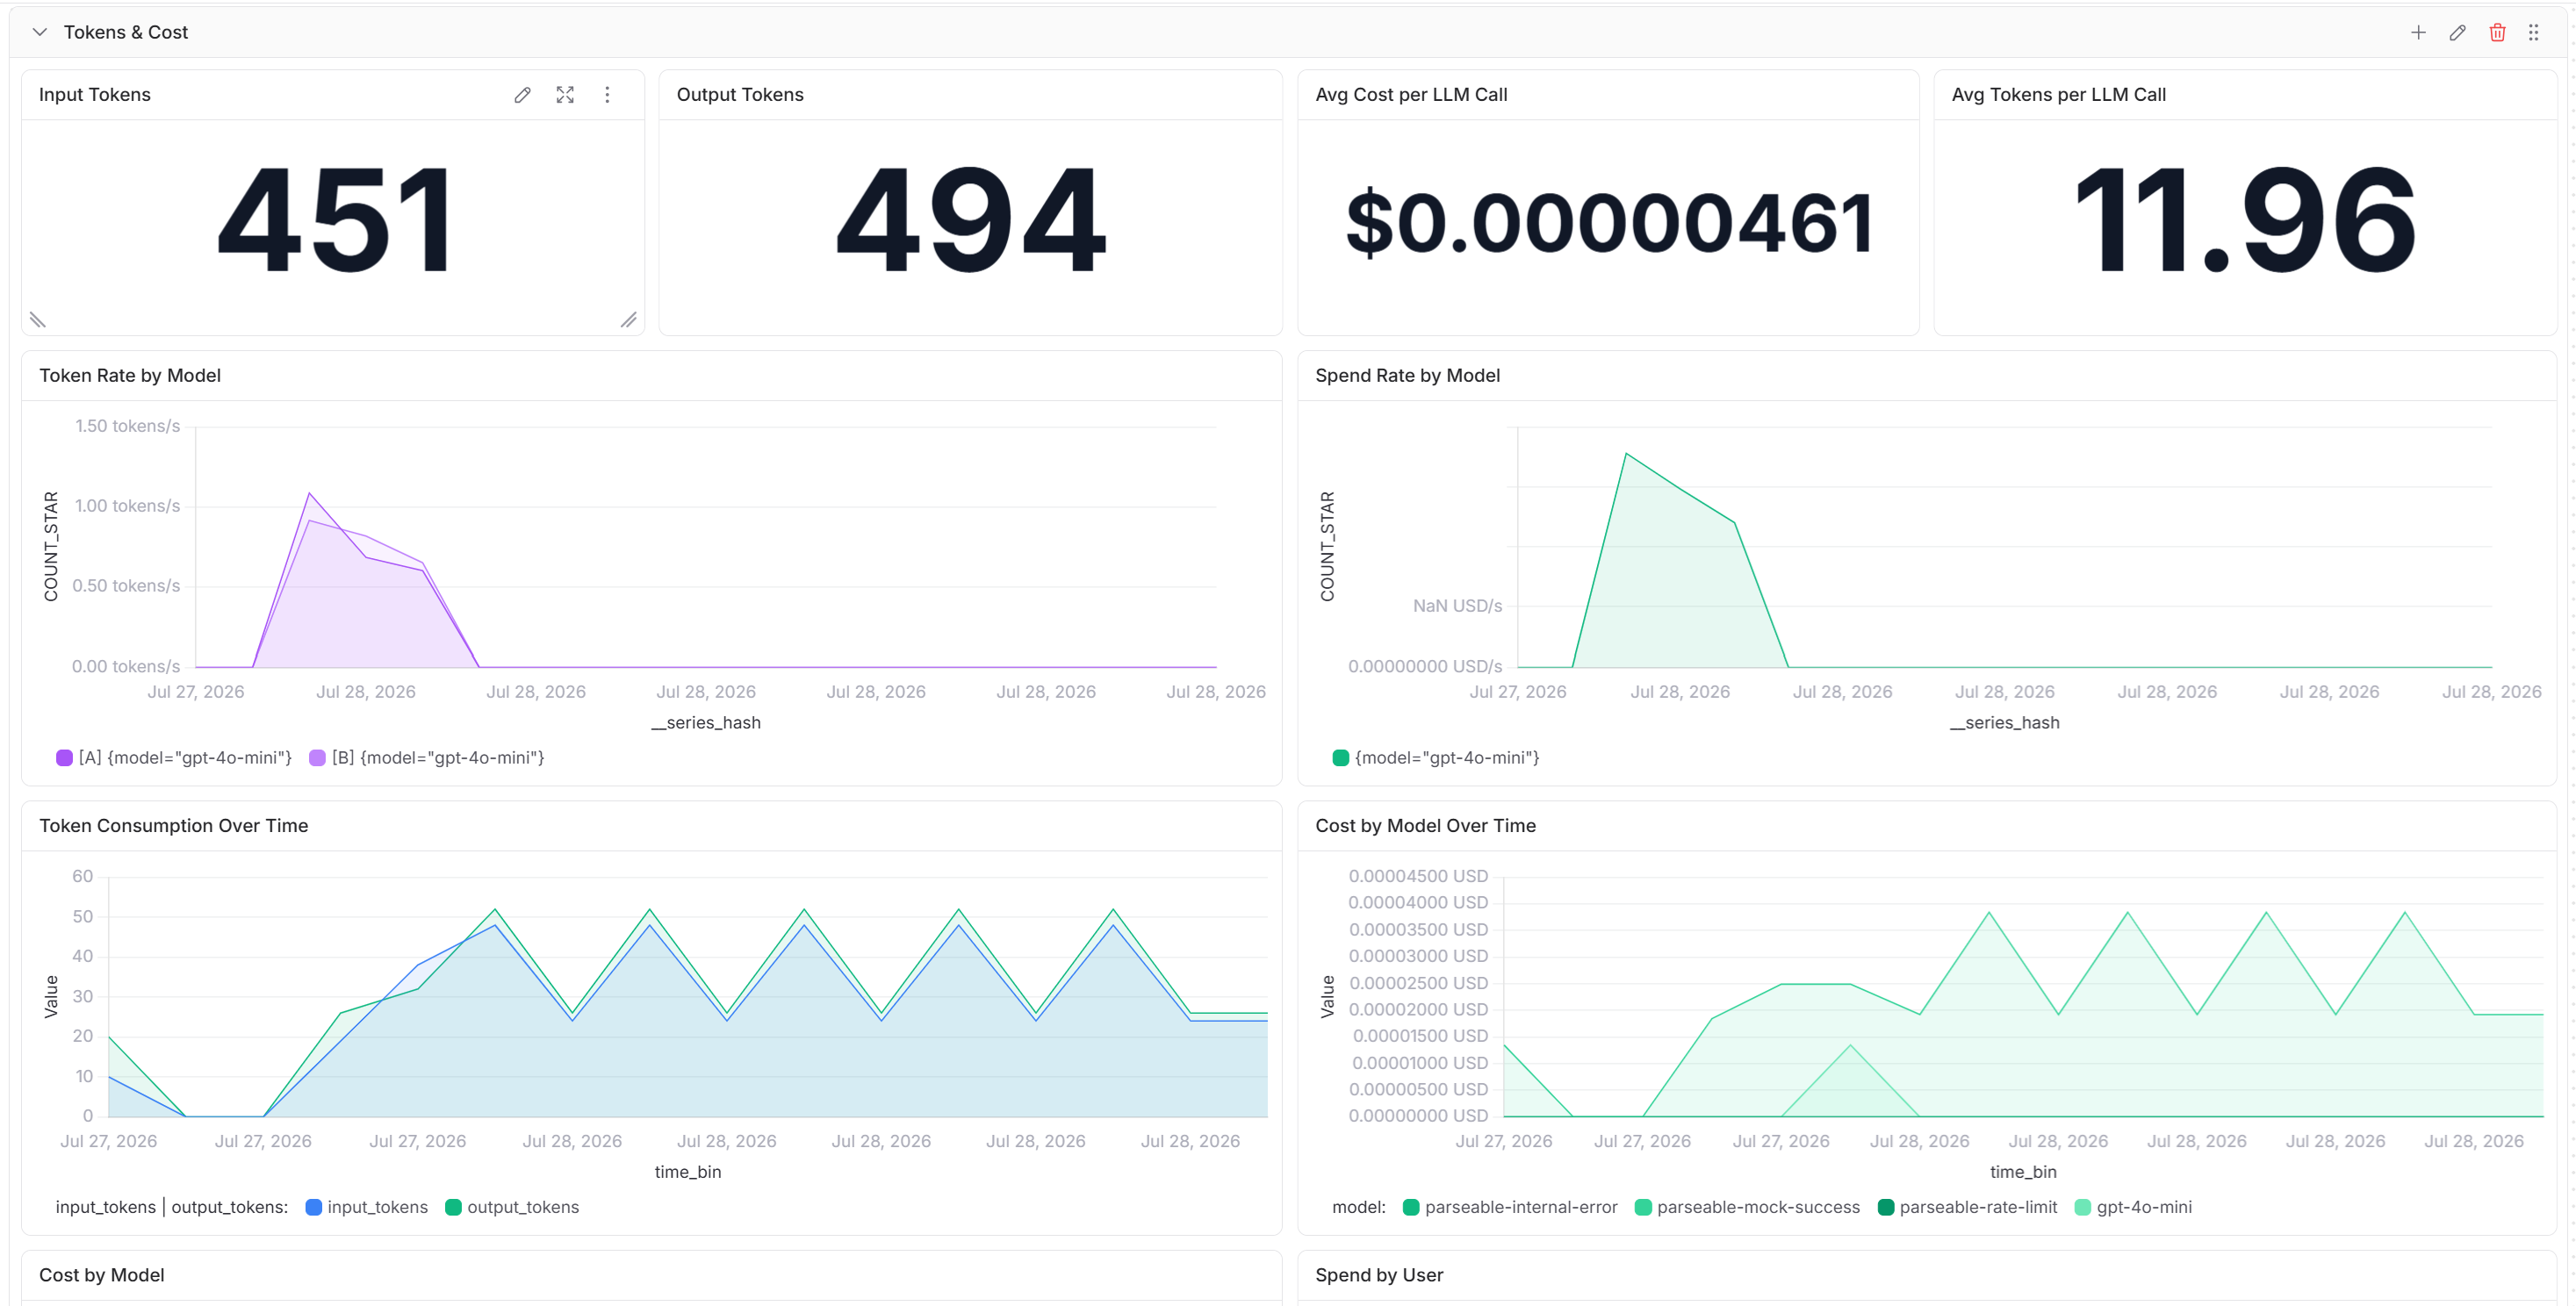
Tokens and Cost 區段顯示輸入與輸出 token 消耗、各模型隨時間的 spend,以及模型經濟效益。可用來找出高流量模型,並將 token 量與已記錄的 spend 進行比較。
其餘區段涵蓋 Traffic and Reliability、Performance and Latency、Cost and FinOps、Logs、Trace Explorer 以及 Metrics and Telemetry。請參閱 Parseable Dashboards 以取得匯入與自訂說明。
Gateway 會將 OpenTelemetry traces 傳送至 Collector,並在 /metrics 公開 gateway metrics 供 Collector 擷取。Parseable LiteLLM Gateway 指南 提供資料集與 Collector 設定。
步驟 1: 安裝 LiteLLM Gateway 與 telemetry 套件。
pip install "litellm[proxy]" \
  opentelemetry-api \
  opentelemetry-sdk \
  opentelemetry-exporter-otlp-proto-http \
  opentelemetry-instrumentation-fastapi \
  prometheus-client==0.20.0
步驟 2: 在 config.yaml 中啟用 OpenTelemetry 與 Prometheus 回呼。
litellm_settings:
  callbacks:
    - otel
    - prometheus

callback_settings:
  otel:
    attributes:
      exclude_list:
        - hidden_params
        - metadata.requester_metadata
        - metadata.requester_ip_address
        - metadata.spend_logs_metadata
        - metadata.mcp_tool_call_metadata
        - metadata.vector_store_request_metadata
        - metadata.prompt_management_metadata
attribute exclusion list 可防止與請求相關的中繼資料建立高基數 metric series。
步驟 3: 將 LiteLLM 指向 OpenTelemetry Collector。
export LITELLM_MASTER_KEY="<litellm-master-key>"
export LITELLM_OTEL_V2="true"
export LITELLM_OTEL_INTEGRATION_ENABLE_METRICS="true"
export USE_OTEL_LITELLM_REQUEST_SPAN="true"
export OTEL_SEMCONV_STABILITY_OPT_IN="gen_ai_latest_experimental"
export OTEL_EXPORTER="otlp_http"
export OTEL_ENDPOINT="http://localhost:4318"
export OTEL_SERVICE_NAME="litellm-gateway"
export OTEL_ENVIRONMENT_NAME="production"
export OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT="no_content"
在 LiteLLM 與 Collector 的 Prometheus receiver 中使用相同的 LITELLM_MASTER_KEY。request-span 與 semantic-convention 設定會建立 Parseable 儀表板查詢所使用的 CLIENT spans。
步驟 4: 啟動 Gateway。
litellm --config config.yaml --port 4000
設定 Collector 透過 OTLP/HTTP 接收 traces,並使用 LiteLLM master key 擷取 http://<litellm-host>:4000/metrics。將 traces 傳送至 Parseable 中的 <gateway-traces-dataset>,並將 metrics 傳送至 <gateway-metrics-dataset>。
在 Parseable 中檢視 Traces 與 Metrics
從 Traces 頁面開啟 <gateway-traces-dataset>,以檢查請求路徑、routing、防護欄、cache 或資料庫活動,以及提供者呼叫。從 Metrics 頁面開啟 <gateway-metrics-dataset>,以檢查 GenAI metrics 與 LiteLLM Prometheus metrics。
儀表板
LiteLLM Proxy Observability 儀表板 包含七個區段共 52 個圖磚。它結合 SQL trace 查詢與 PromQL gateway metrics,以涵蓋請求健康狀態、延遲、tokens、spend、模型行為與部署健康狀態。
將 JSON 範本匯入 Parseable。將 Trace Dataset 設為 <gateway-traces-dataset>,並將 Metrics Dataset 設為 <gateway-metrics-dataset>。
Gateway 總覽
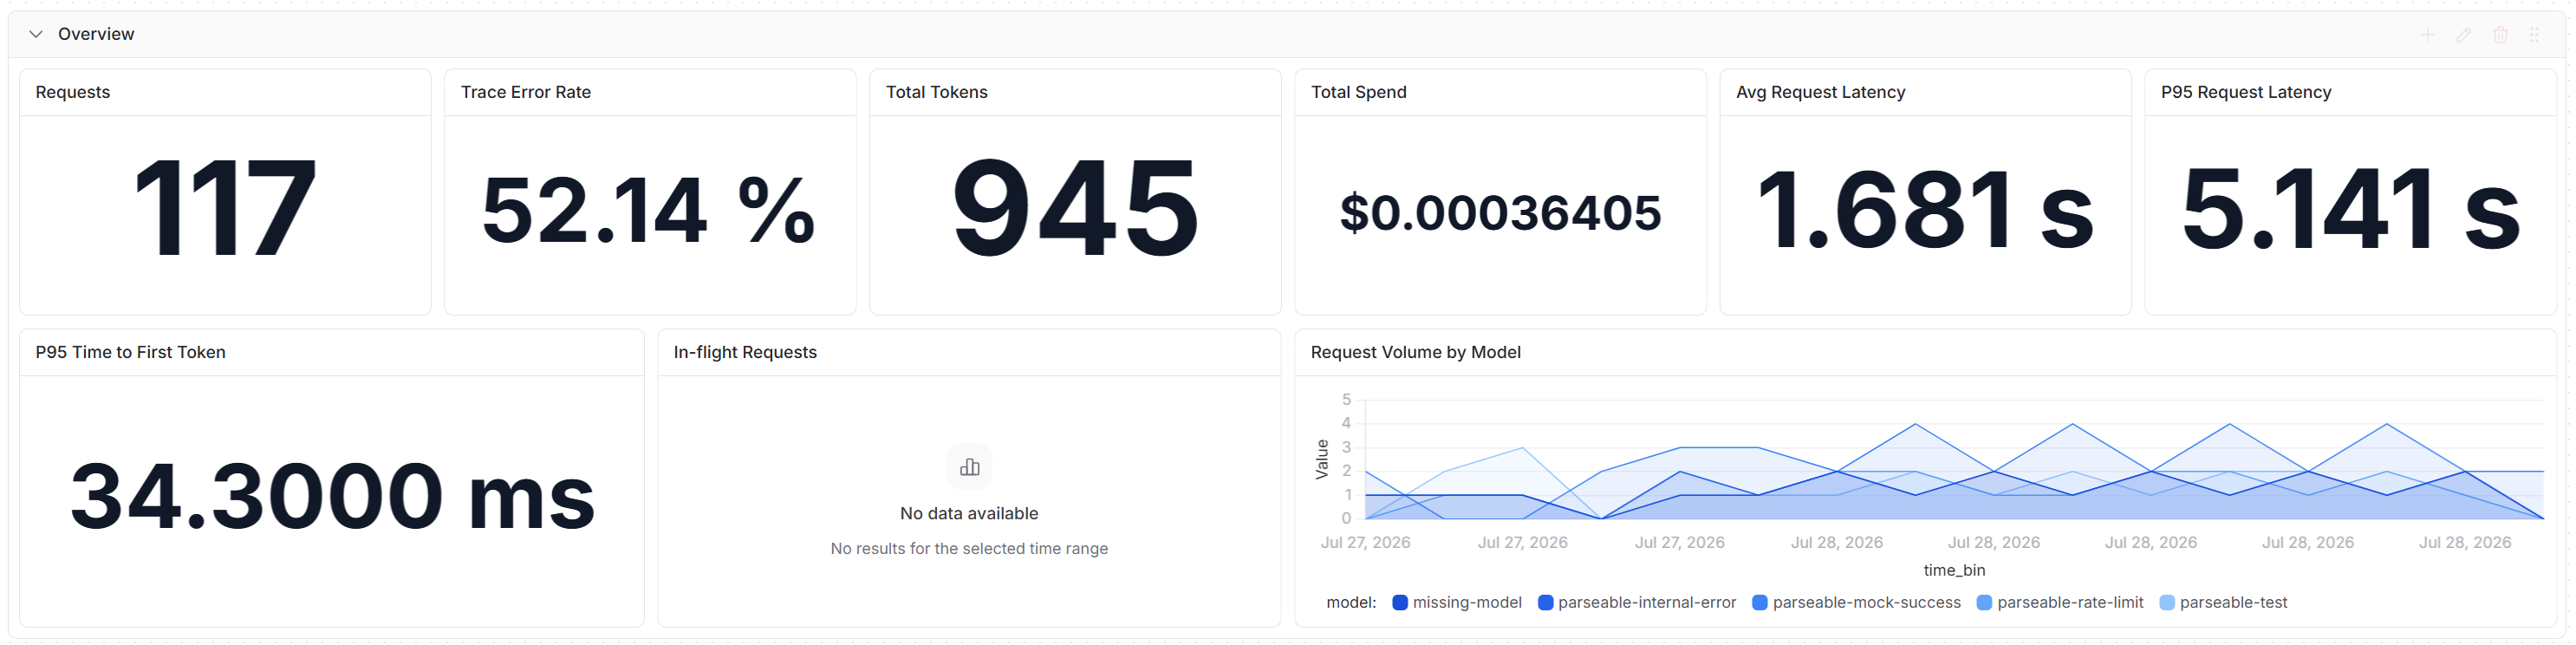
Overview 區段顯示請求數、trace 錯誤率、總 token、總 spend、平均請求延遲、P95 請求延遲,以及 P95 首 token 時間。它包含進行中請求與依模型劃分的請求量面板。使用這些訊號來選擇後續區段:Traffic and Reliability、Latency、Tokens and Cost、Cost and FinOps、Models and Usage 或 Trace Explorer。
模型與使用情況
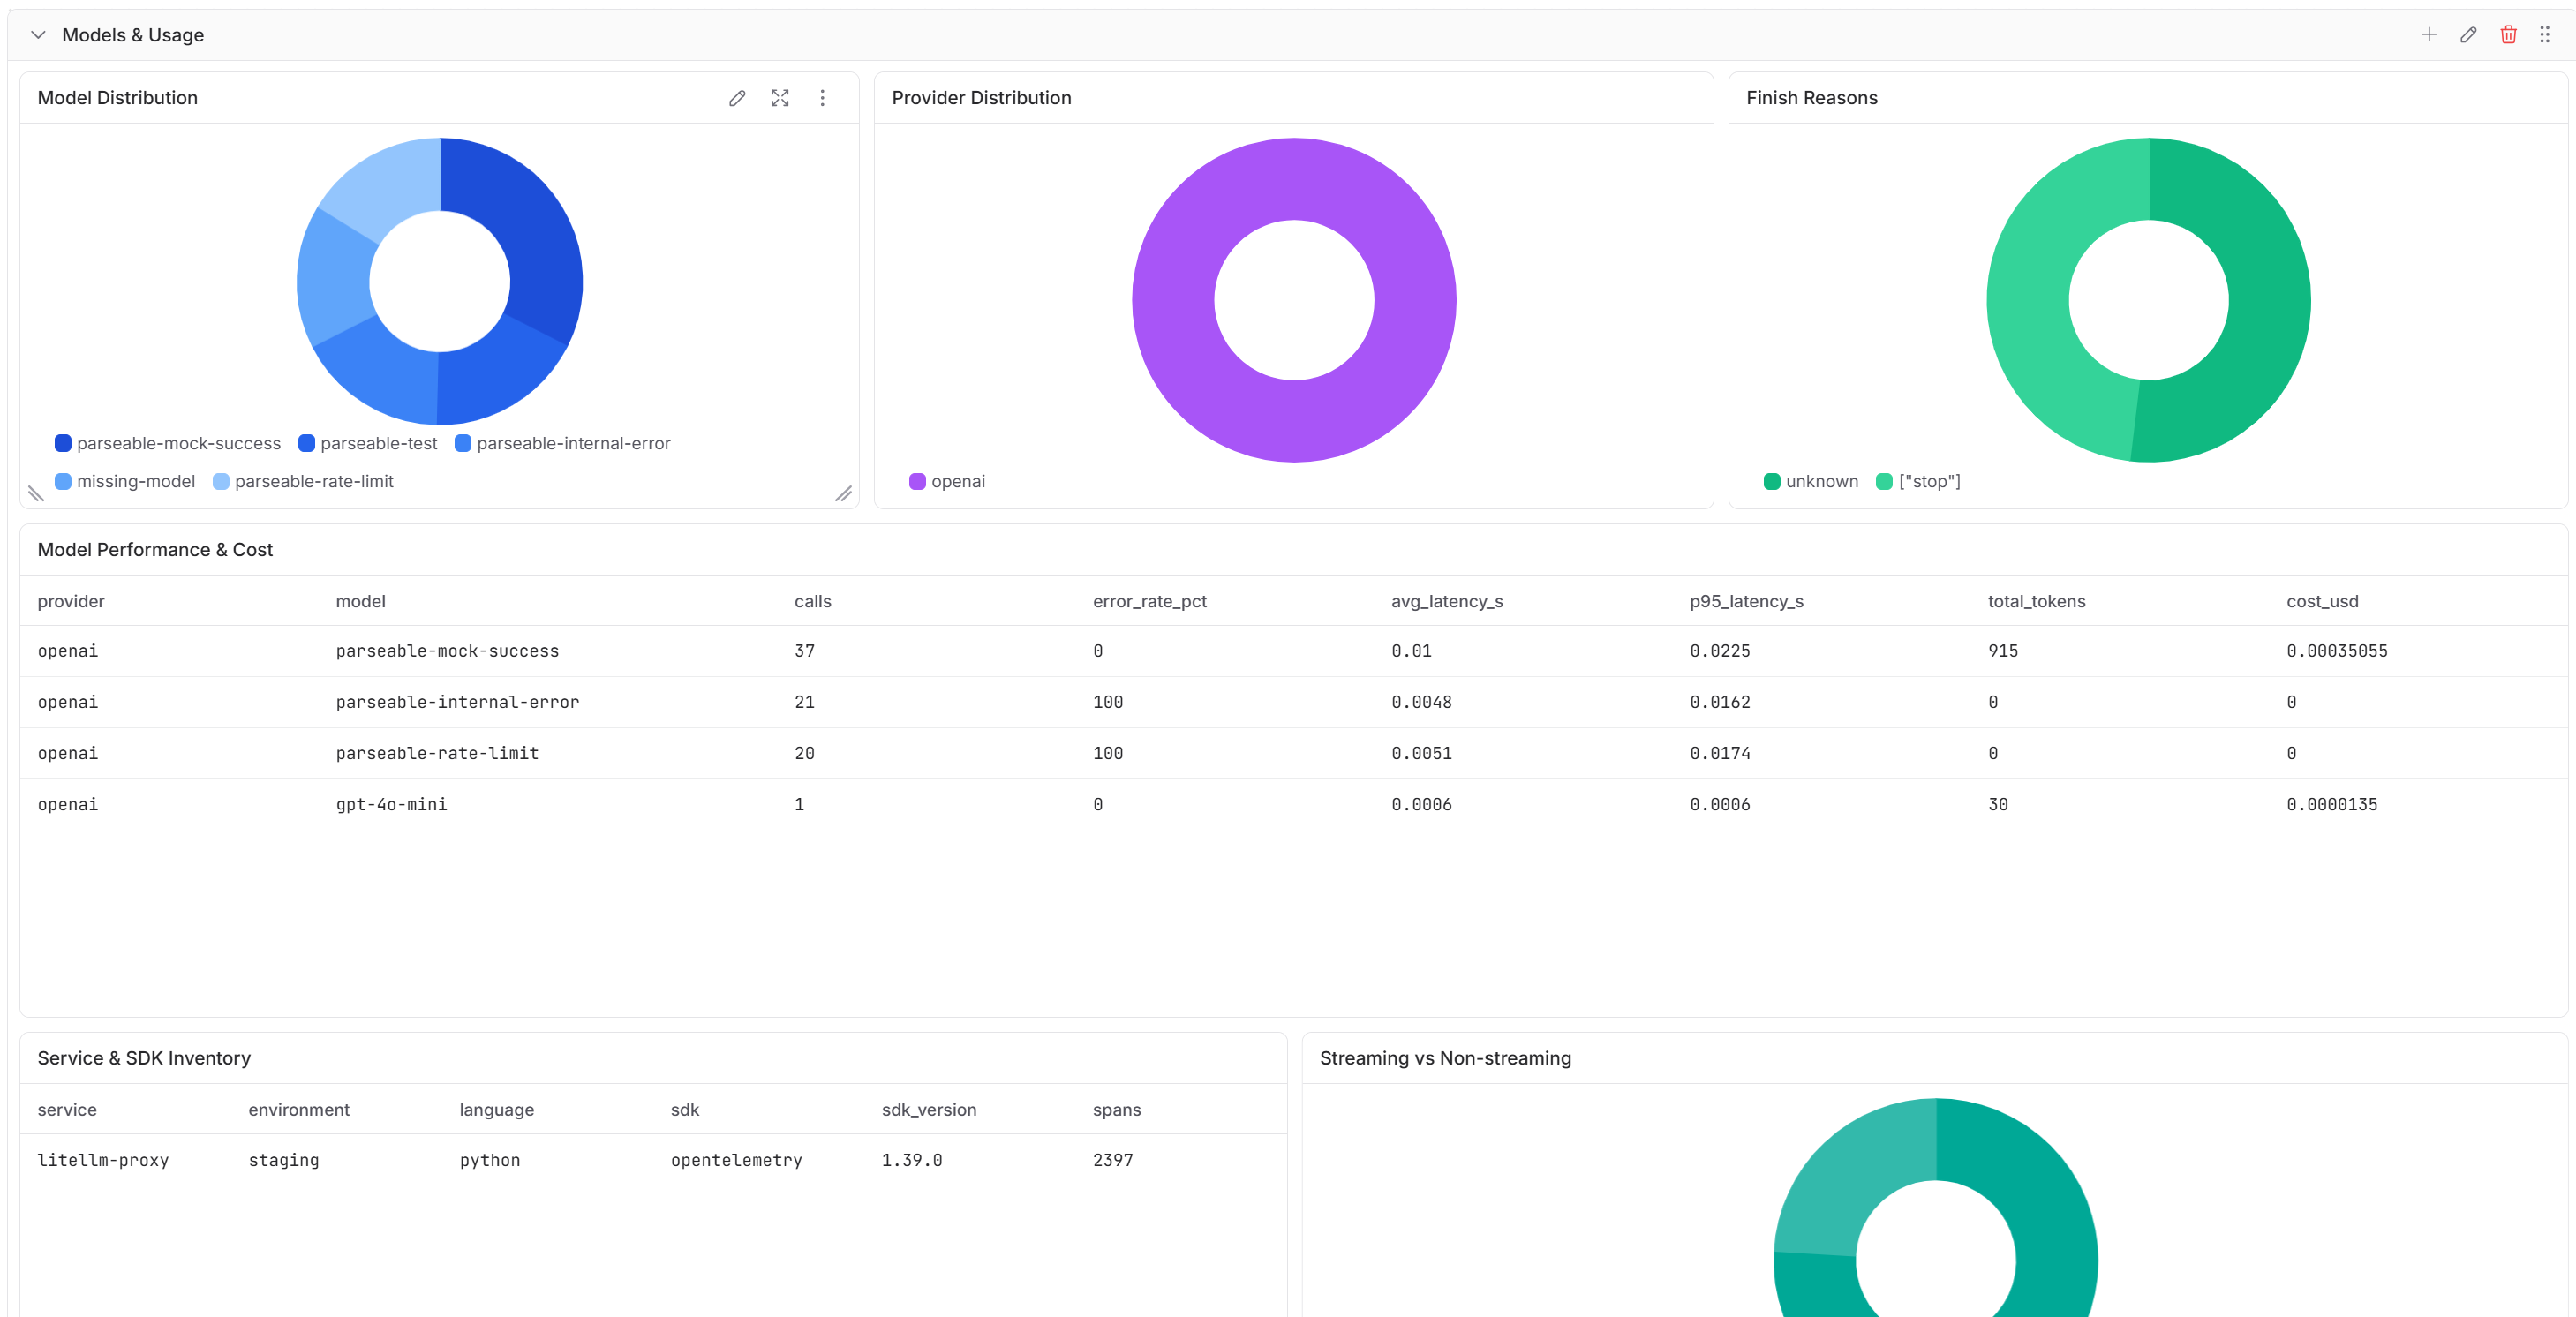
Models and Usage 區段顯示模型與提供者分布、結束原因、串流使用情況與服務清單。其 Model Performance and Cost 表格會比較每個模型的呼叫次數、錯誤率、平均與 P95 延遲、token 量與成本。
Token 與成本
Tokens and Cost 區段顯示各模型的輸入與輸出 token 總數、每次呼叫平均成本、每次呼叫平均 token 數、token rate 與 spend rate。其時間序列面板會比較所選期間內的 token 消耗與模型成本。
請參閱 Parseable Dashboards 以取得匯入與自訂說明。

