OpenAI Fast 與 Ultrafast 模式
對 GPT-6 Astra 的 Fast 模式使用 service_tier: "priority",或對 Ultrafast 使用 service_tier: "ultrafast"。您可以在 Admin UI 或 config.yaml 中將該層級設為部署預設值,或針對每個請求個別選擇。以下範例使用 Responses API。
本導覽會為 Astra Ultrafast 建立 gpt-6-astra-ultrafast,並以名為 gpt-6.1-sol-fast 的 Fast 替代項目。這些 gateway 別名是您自行選擇的名稱;service_tier 參數會選取處理模式。
支援的模型與可用性
Fast 模式
OpenAI 已將 Priority 處理重新命名為 Fast 模式。service_tier: "priority" 和 service_tier: "fast" 都會選取它。本指南使用 priority,這也保留了 Codex 的 /fast 指令。
下列模型已透過 LiteLLM 的完整 Responses API 請求在 2026 年 10 月 6 日驗證。每個模型都回傳了 Fast 處理層級:
| OpenAI 模型 ID | LiteLLM 上游模型 | 回傳的 service_tier |
|---|---|---|
gpt-6-astra | openai/gpt-6-astra | fast |
gpt-6.1-sol | openai/gpt-6.1-sol | fast |
gpt-6-sol | openai/gpt-6-sol | fast |
gpt-6-luna | openai/gpt-6-luna | fast |
gpt-5.6-sol | openai/gpt-5.6-sol | priority |
gpt-5.6-terra | openai/gpt-5.6-terra | priority |
gpt-5.6-luna | openai/gpt-5.6-luna | priority |
這些是本指南目前測試過的模型,不是完整清單。請參閱 OpenAI 的 Fast 定價表 以取得其他受支援模型。Fast 模式也支援 Chat Completions。對於上述 GPT-6 模型,它無法搭配 EU 資料駐留使用;請查看 OpenAI 的 區域需求。
Ultrafast 模式
搭配 service_tier: "ultrafast" 使用 GPT-6 Astra(openai/gpt-6-astra)。透過 LiteLLM 的完整 Responses API 請求在測試中回傳了 service_tier: "ultrafast"。本指南中的 Ultrafast 設定只使用 Astra。
OpenAI 讓所有 API 使用者都能使用 Astra Ultrafast,且初始速率限制較低。請透過 HTTP 或 WebSocket 使用 Responses API。Ultrafast 僅支援美國資料駐留與全球處理;不支援 EU 與其他非美國區域處理端點。請參閱 OpenAI 的 Ultrafast 指南 以取得目前的可用性與限制。
您的 OpenAI 帳戶必須支援該模型所選的層級。將層級加入 LiteLLM 的目錄不會在 OpenAI 啟用它,而且支援 Fast 模式不代表支援 Ultrafast。
開始之前
請使用支援 Responses API 的最新 LiteLLM 版本、可存取所選模型且有可用額度的 OpenAI API 憑證,以及可將模型新增至您的 gateway 的權限。以下 UI 導覽是在 LiteLLM v1.105.0 上擷取的。若是新的 gateway,請先完成 Admin UI 快速入門。
這兩種模式的費用都比 Standard 高。請查看 OpenAI 的 Fast 定價 與 Ultrafast 定價。若要使用 LiteLLM 進行支出追蹤,請確認您的模型 cost-map 項目具有適用於 Fast 的 *_priority 費率或適用於 Ultrafast 的 *_ultrafast 費率,包括輸入、輸出、快取與長上下文費率。若定價缺失或與您的協議不同,請先設定 自訂定價,再依賴支出總計或預算。
在 Admin UI 中設定
1. 選取模型與憑證
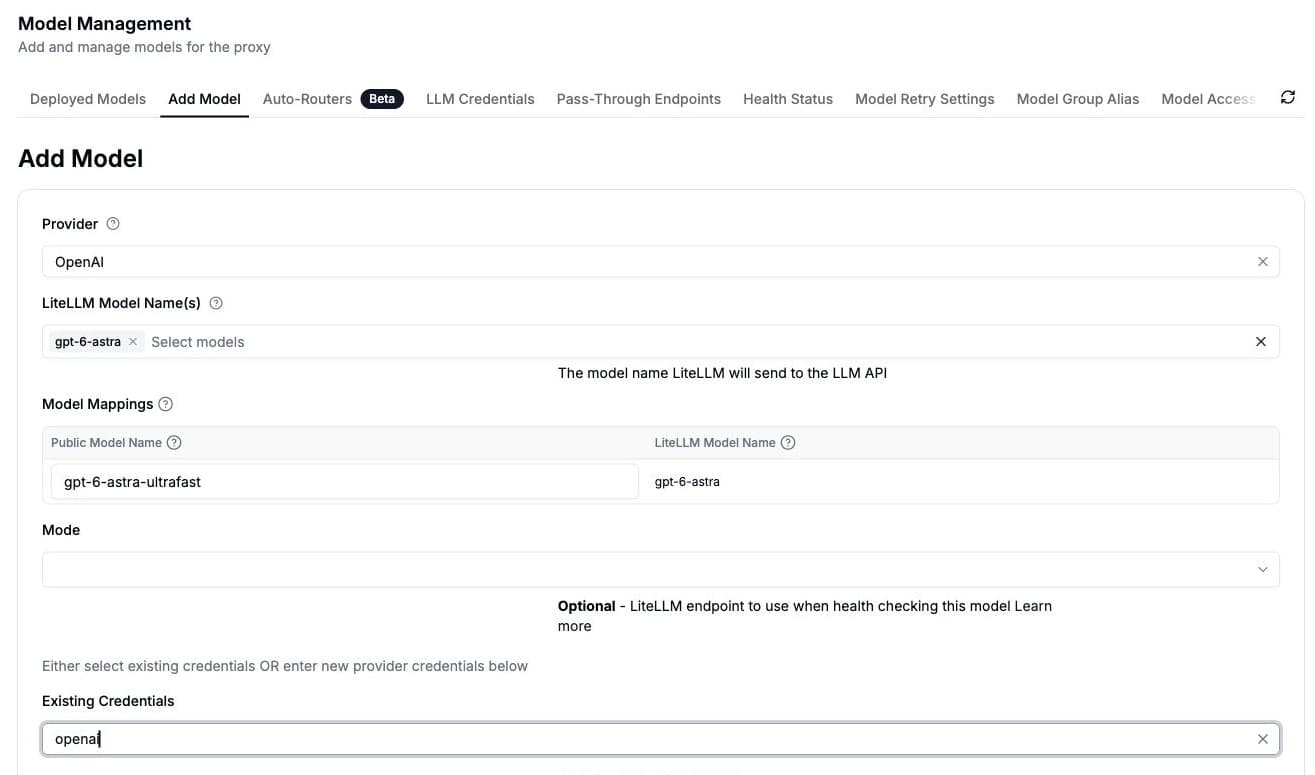
開啟 Models + Endpoints,然後按 Add Model。選擇 OpenAI 作為提供者,並在 LiteLLM Model Name(s) 下方選擇 gpt-6-astra。在 Model Mappings 中,將 Public Model Name 設為 gpt-6-astra-ultrafast。
對於 Fast 模式,請從上方的 Fast 表格中選取一個模型,例如 gpt-6.1-sol,並使用例如 gpt-6.1-sol-fast 的公開名稱。模型選擇的截圖顯示的是 Astra;Fast 設定則另外顯示在下方。
在 Existing Credentials 下方選取您的 OpenAI 憑證,或在提供者憑證欄位中輸入您的 OpenAI API 金鑰。截圖使用的是名為 openai 的現有憑證;請使用您自己的憑證名稱。
先將 Mode 保持空白。在 v1.105.0 中,該下拉選單不包含 Responses;請在下一步透過 Model Info 設定它。
2. 設定服務層級
展開 Advanced Settings,並為您的模式選擇設定:
LiteLLM Params 中的 service_tier(單數)會選取處理模式。Model Info 中的 service_tiers(複數)則是可選的模式清單,會向 Codex 等用戶端宣告。
- Ultrafast(Astra)
- Fast
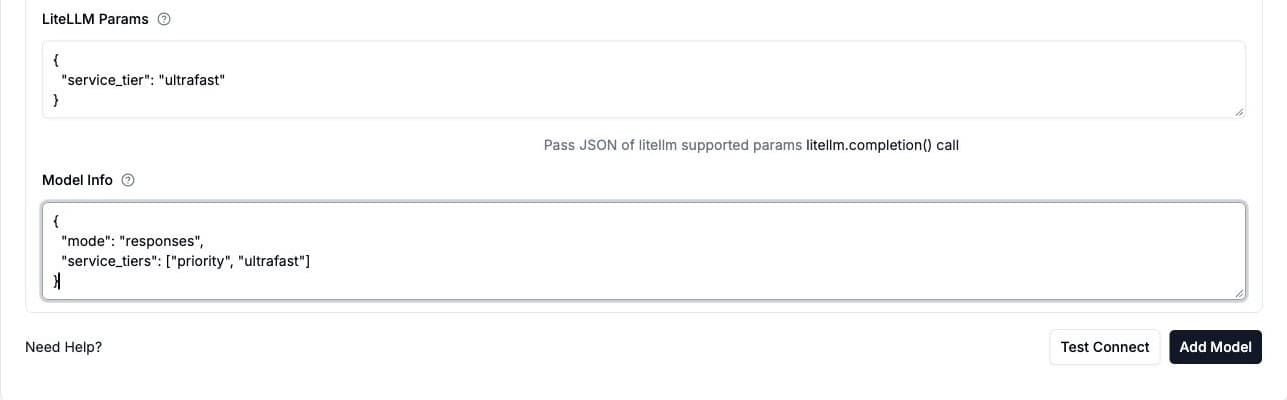
在 LiteLLM Params 中輸入此 JSON:
{
  "service_tier": "ultrafast"
}
在 Model Info 中輸入此 JSON:
{
  "mode": "responses",
  "service_tiers": ["priority", "ultrafast"]
}
在 LiteLLM Params 中輸入此 JSON:
{
  "service_tier": "priority"
}
在 Model Info 中輸入此 JSON:
{
  "mode": "responses",
  "service_tiers": ["priority"]
}
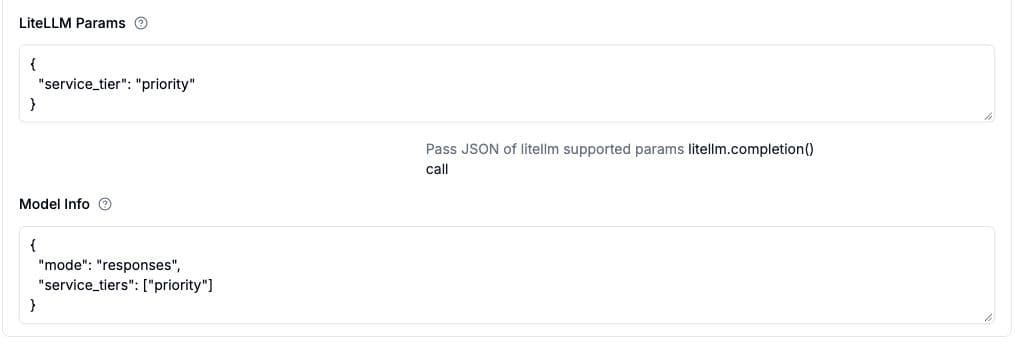
mode: "responses" 會讓連線測試使用 Responses 端點。
3. 測試並儲存
按一下 Test Connect。測試應會將所選的上游模型與 service_tier(Fast 為 priority,Astra Ultrafast 為 ultrafast)傳送到 OpenAI 的 /v1/responses 端點。請先解決測試中顯示的任何憑證、配額或存取錯誤,然後按 Add Model 儲存。
在 Deployed Models 下方,搜尋您設定的公開名稱,開啟其模型 ID,並選取 Raw JSON。確認 litellm_params.service_tier 與您選擇的層級相符,且 model_info.mode 為 "responses"。下方請使用可存取此公開模型名稱的 虛擬金鑰 來發出請求。
使用 config.yaml 設定
將下列部署新增至您的 gateway 設定,作為在 UI 中新增的替代方式:
- Ultrafast(GPT-6 Astra)
- Fast(GPT-6.1 Sol)
model_list:
  - model_name: gpt-6-astra-ultrafast
    litellm_params:
      model: openai/gpt-6-astra
      api_key: os.environ/OPENAI_API_KEY
      service_tier: ultrafast
    model_info:
      mode: responses
      service_tiers: ["priority", "ultrafast"]
model_list:
  - model_name: gpt-6.1-sol-fast
    litellm_params:
      model: openai/gpt-6.1-sol
      api_key: os.environ/OPENAI_API_KEY
      service_tier: priority
    model_info:
      mode: responses
      service_tiers: ["priority"]
在 gateway 的環境中設定 OPENAI_API_KEY,並以更新後的設定重新啟動。若為本機 proxy 安裝,請使用 litellm --config config.yaml 啟動;請參閱 proxy 設定 以了解部署選項。
openai/ 前綴會選取上游提供者。用戶端會呼叫所選部署的公開 model_name,例如 gpt-6-astra-ultrafast。請將提供者金鑰保留在 gateway 上;用戶端使用其 LiteLLM 虛擬金鑰進行驗證。
透過 gateway 傳送請求
下方請求使用 Astra Ultrafast 別名。對於 Fast 部署,請改用 model: "gpt-6.1-sol-fast" 和 service_tier: "priority"。
將 LITELLM_BASE_URL 設為不含尾端 /v1 的 gateway URL,並將 LITELLM_API_KEY 設為可存取該模型的虛擬金鑰:
export LITELLM_BASE_URL="http://localhost:4000"
export LITELLM_API_KEY="<your-litellm-virtual-key>"
- curl
- OpenAI Python SDK
curl "${LITELLM_BASE_URL}/v1/responses" \
  -H "Authorization: Bearer ${LITELLM_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra-ultrafast",
    "service_tier": "ultrafast",
    "input": "Say hello in one sentence."
  }'
安裝或升級 openai,然後執行:
import os
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["LITELLM_BASE_URL"].rstrip("/") + "/v1",
    api_key=os.environ["LITELLM_API_KEY"],
)

response = client.responses.create(
    model="gpt-6-astra-ultrafast",
    service_tier="ultrafast",
    input="Say hello in one sentence.",
)

print(response.output_text)
print(response.service_tier)
上述兩個範例都明確請求了一個 tier。若用戶端省略 service_tier,上方的部署預設值會提供它。請求中明確指定的 tier 會覆寫該預設值。若只想對特定請求使用 Fast 或 Ultrafast,請將 service_tier 從部署中移除,並在那些請求中送出它。
直接使用 LiteLLM Python SDK
在沒有閘道的情況下,請在應用程式的環境中設定 OPENAI_API_KEY,並使用 litellm.responses() 呼叫上游模型:
import litellm

response = litellm.responses(
    model="openai/gpt-6-astra",
    service_tier="ultrafast",
    input="Say hello in one sentence.",
)

print(response)
對於 Fast 模式,請使用 model="openai/gpt-6.1-sol" 和 service_tier="priority",或使用上方 Fast 表格中的其他模型。
在 Codex 中提供 /fast 和 /ultrafast
使用 model_info.service_tiers: ["priority"] 來提供 /fast。對於 Astra,使用 ["priority", "ultrafast"] 來同時提供 /fast 和 /ultrafast。Codex CLI 0.159 或更新版本也需要將 model_catalog_url 指向您閘道的 /v1/models 端點,並且 [features] api_key_model_discovery = true。請遵循 Codex 模型目錄設定,選取您的閘道模型,然後選擇一個模式。
對於使用者切換模式開關的模型,請省略部署的 litellm_params.service_tier,並保留 model_info.service_tiers。否則,停止送出 tier 的用戶端仍會繼承部署的預設值。宣告一個 tier 並不會授予 OpenAI 存取該 tier 的權限。
驗證與疑難排解
檢查完成回應的 service_tier 欄位,以確認提供該請求服務的 tier:Fast 模式為 fast 或 priority,Ultrafast 則為 ultrafast。OpenAI 的 Fast 指南 說明了傳回的 tier 名稱,以及流量上升限制何時可能會將 Fast 請求降級為 default。若為串流,請在 response.completed 事件上檢查回應。僅有已儲存的模型名稱、目錄項目,或送出的請求本身,都無法確認實際提供服務的 tier。
| 症狀 | 要檢查的項目 |
|---|---|
insufficient_quota 或 credit_balance_exhausted | 檢查 OpenAI 帳戶的點數與帳單。LiteLLM 虛擬金鑰的預算不會為上游帳戶提供資金。 |
Invalid service_tier argument,或提供者拒絕該模型或 tier | 檢查 支援的模型、帳戶存取權限、區域端點,以及請求的 tier。對於上述 Ultrafast 設定,請使用 Astra。僅有模型存取權並不保證能存取每個 tier。 |
| Fast 或 Ultrafast 請求看起來與 Standard 成本相同 | 確認模型的 *_priority 或 *_ultrafast 定價欄位,或設定自訂定價。提供者存取權與 LiteLLM 成本追蹤是分開的。 |
| 請求使用了不同的 tier | 檢查用戶端的 service_tier;它會覆寫部署預設值。確認所選別名路由到預期的部署。 |
Fast 請求回傳 service_tier: "default" | 當流量上升過快時,OpenAI 可能會降級請求。請檢查提供者的上升限制;僅有 HTTP 200 並不能證明是 Fast 處理。 |
Codex 沒有顯示 /fast 或 /ultrafast | 檢查目錄設定與模型的 service_tiers。如果多個部署共用同一個別名,請在每個部署上設定清單。請參閱 Codex 指南以了解目錄快取與版本需求。 |
這些範例使用 HTTP Responses 請求。對於重複的代理程式工具呼叫,OpenAI 建議使用持久的 WebSocket 連線以降低連線額外負擔;請參閱 LiteLLM 的 Responses WebSocket 指南。

