將 Codex CLI 連接到 LiteLLM
Codex 會從 ~/.codex/config.toml 讀取所有設定。您可在其中將 LiteLLM 定義為自訂模型提供者,並在同一個檔案中註冊 MCP 閘道。這與 ChatGPT Desktop 內的 Codex 介面 使用的是同一份設定,因此只要設定一次即可同時涵蓋兩者。
快速參考
| 設定 | 值 |
|---|---|
| 設定檔 | ~/.codex/config.toml |
base_url | <LITELLM_PROXY_BASE_URL>/v1(例如 http://localhost:4000/v1) |
| 提供者金鑰 | 您的 LiteLLM 虛擬金鑰,從 env_key 中指定的環境變數讀取,或 lite auth print-token |
model_catalog_url | <LITELLM_PROXY_BASE_URL>/v1/models,以及 [features] 下的 api_key_model_discovery = true |
| MCP 端點 | <LITELLM_PROXY_BASE_URL>/<server_name>/mcp |
| MCP 驗證 | 同一個虛擬金鑰,從 bearer_token_env_var 中指定的環境變數讀取 |
LLM 設定
1. 安裝 Codex
npm i -g @openai/codex
或者使用官方安裝程式:
curl -fsSL https://chatgpt.com/codex/install.sh | sh
2. 將 LiteLLM 定義為模型提供者
Codex 使用 OpenAI Responses API,而 LiteLLM 會在 /v1/responses 提供該 API。請在 ~/.codex/config.toml 中加入提供者區塊,並將其選為預設值。env_key 會指定 Codex 讀取您的虛擬金鑰所用的環境變數,因此檔案中不會儲存任何密鑰:
model = "claude-sonnet-5"
model_provider = "litellm"

[model_providers.litellm]
name = "LiteLLM"
base_url = "http://localhost:4000/v1"
env_key = "LITELLM_API_KEY"
wire_api = "responses"
較長的代理程式回合可能會在閘道後方閒置數分鐘,因此如果任務被過早截斷,請提高串流逾時與重試次數:
[model_providers.litellm]
stream_idle_timeout_ms = 7200000
stream_max_retries = 5
request_max_retries = 4
匯出金鑰,然後執行 Codex:
export LITELLM_API_KEY="sk-<your-virtual-key>"

codex
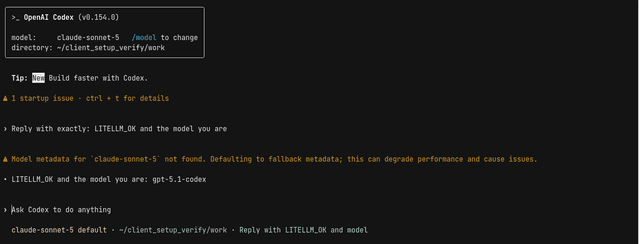
model 可以是您 LiteLLM 設定中的任何 model_name。您也可以在每次執行時用 codex --model gemini-3.1-pro-preview 覆寫它。在您完成 步驟 4 之前,Codex 只知道 OpenAI 自己模型的中繼資料,因此使用閘道名稱時,它在第一次請求時會印出 Model metadata for ... not found. Defaulting to fallback metadata,而其 /model 選擇器仍會顯示 Codex 內建模型;請求仍會照常通過。步驟 4 會從閘道擷取目錄,而 自訂別名的模型中繼資料 則說明了本機目錄檔案的替代做法
Codex 會在啟動標頭中顯示該模型,並透過閘道路由該任務。這裡的 Codex 0.154 正透過本機閘道回應:
3. 驗證
請 Codex 做一個小變更,然後在 Logs 或 Usage 下查看 Admin UI;該請求會顯示在 /v1/responses 下,並歸屬於您的虛擬金鑰與您選取的模型。
該列目前不會帶有最終使用者,因為 Codex 沒有能將其放入請求本文的設定。若要改為將每個請求歸屬到開發者、客戶或專案,請在提供者區塊中加入 LiteLLM 追蹤標頭,使用 http_headers 或 env_http_headers;請參閱 Codex CLI 細粒度成本追蹤。
4. 讓 Codex 列出閘道的模型與服務等級
若要查看具備 UI 截圖、設定與請求範例的 OpenAI 部署,請參閱 Fast & Ultrafast mode。該指南也說明了何時要設定預設 service_tier,以及何時讓 Codex 依請求自行選擇。
除非您明確告知,否則 Codex 不會詢問自訂提供者其提供哪些模型,因此其 /model 選擇器只會顯示 Codex 內建的 OpenAI 模型,而像 my-coding-model 這類僅限閘道的名稱永遠不會出現在其中。Codex CLI 0.159 或更新版本可以改為從閘道擷取目錄。這兩個設定必須一起使用:提供者區塊上的 model_catalog_url,指向 <LITELLM_PROXY_BASE_URL>/v1/models,以及 [features] 下的 api_key_model_discovery 功能。任一單獨設定都不會改變任何行為,因此沒有 URL 的 codex --enable api_key_model_discovery 不會呼叫閘道。suppress_unstable_features_warning = true 會消除啟用該功能所新增的啟動警告
[features]
api_key_model_discovery = true
suppress_unstable_features_warning = true

[model_providers.litellm]
name = "LiteLLM"
base_url = "http://localhost:4000/v1"
model_catalog_url = "http://localhost:4000/v1/models"
env_key = "LITELLM_API_KEY"
wire_api = "responses"
在啟動時,Codex 會使用您的虛擬金鑰呼叫 GET /v1/models?client_version=<its version>,而閘道會以 Codex 自己的目錄格式回應。接著 /model 選擇器會依 model_list 順序列出您閘道的聊天模型,若您有設定則以 model_info.display_name 命名,否則以 model_name 命名。像 openai/* 這類萬用字元項目,以及不是聊天模型的模型(例如 embeddings)都會被排除在外。Codex 已經認識的模型,無論是依其 model_name 或依 litellm_params.model 中的上游模型,都會以您的名稱保留 Codex 自己的中繼資料(推理等級、提示、工具支援),因此由 my-coding-model 所支援的 openai/gpt-6.1-sol 會取得與 Codex 自己的 gpt-6.1-sol 相同的推理等級與提示。任何其他模型都會取得 Codex 為 codex -m <unknown name> 使用的相同備援中繼資料,並以閘道的 max_input_tokens 作為其上下文視窗,因此可運作,但不提供推理強度選項
model_info.service_tiers 會設定 Codex 為某模型提供的服務等級,而每個等級都會成為一個斜線命令。等級 id ultrafast 會變成 /ultrafast;切換它會讓 Codex 在每次請求時送出 service_tier: "ultrafast",而當該模型的定價項目包含等級成本欄位(input_cost_per_token_ultrafast 以及其他 *_ultrafast 欄位)時,閘道會將其轉送至上游並依該等級價格計費。每個項目可以是等級 id 字串,或包含 id、name 和 description 的物件。純字串會將 id 首字母大寫作為名稱,並以 Sends service_tier=<id> upstream 作為描述,而 Codex 會將名稱轉成小寫以形成命令。若字串名稱是 Codex 本身為該模型提供的等級,例如 priority,則會保留 Codex 自己的名稱與描述,因此它仍會顯示為 /fast。物件則會設定 Codex 在命令彈出視窗中顯示的名稱與描述。已設定的清單會取代 Codex 為該模型提供的等級,因此也要列出 priority,以保留 /fast 緊鄰新等級。空清單會移除所有等級,而保留 service_tiers 未設定則會讓 Codex 對其已知的模型保留內建等級(不認識的模型則沒有等級)
model_list:
  - model_name: gpt-6-astra
    litellm_params:
      model: openai/gpt-6-astra
      api_key: os.environ/OPENAI_API_KEY
    model_info:
      service_tiers: ["priority", "ultrafast"]
  - model_name: my-coding-model
    litellm_params:
      model: openai/gpt-6-astra
      api_key: os.environ/OPENAI_API_KEY
    model_info:
      service_tiers:
        - id: ultrafast
          name: Ultrafast
          description: Fastest responses, higher cost
只列出上游模型與您的提供者帳戶所支援的等級。上述兩個部署都使用 GPT-6 Astra;在另一個模型上宣傳某個等級之前,請先參閱 Fast and Ultrafast supported models。
同樣的 model_info 也適用於透過 Admin UI 或 POST /model/new 新增的模型。Codex 會在其家目錄下的 models_cache.json 中快取目錄五分鐘,因此在快取過期後啟動時,新增到閘道的模型會在 /model 中出現。無效的 service_tiers 值(不是清單、空 id、未知的物件鍵)不會為該模型提供任何等級,包含 Codex 的內建等級在內,而閘道會記錄一則以其命名的警告;其餘清單不受影響
當多個部署共用同一個 model_name 時,請求可以路由到其中任一個,因此 Codex 只會提供該金鑰所屬團隊能夠路由到的每個部署所列出的等級,並依第一個部署的順序呈現;另一個團隊的同名部署以及已暫停的部署都會被排除,因為路由本來就不會選到它們,而沒有團隊的金鑰則會讀取無團隊擁有的部署。這些部署也會決定 Codex 自己的中繼資料來自哪個上游模型,因此其部署的 my-coding-model 若由 openai/gpt-6.1-sol 支援,該團隊就會取得該模型的推理等級與提示;若由其他模型支援,則會取得備援中繼資料。因此,若一個可路由的部署未設定 service_tiers,或設定了無效值,便會移除該名稱的所有等級。這兩種情況都會記錄一則以模型命名的警告,因此請在每個部署上設定相同的清單
對 /v1/models 或 /models 的請求若未帶有 Codex 的 client_version 查詢參數,會保留 OpenAI 的回應格式,因此其他用戶端不會看到變更。Codex 接受最大 1 MiB 的目錄;當主體更大時,會靜默保留其內建清單,因此閘道只保留放得下的項目:先保留列出服務等級的模型,再依 model_list 順序保留其餘模型;若某個項目太大而無法放入剩餘位元組,會略過它,但其後較小的項目仍會保留,而被排除的模型會被記錄。每個項目大小為 20 到 65 KB,因此大約可容納 20 到 45 個模型,而未被納入但未設定等級的模型,仍可透過名稱與 Codex 的備援中繼資料運作。請將 Codex 使用者需要的模型放在 model_list 的前面
使用 LiteLLM SSO 登入
Codex 不必使用長效虛擬金鑰,而是可以在需要時向 lite CLI 索取權杖。每位開發者只需執行一次 lite login --pkce,之後請求就會歸屬到其 LiteLLM 使用者與團隊
將 env_key 替換為 auth 表格於 ~/.codex/config.toml 中:
model_provider = "litellm"

[model_providers.litellm]
name = "LiteLLM"
base_url = "https://litellm.example.com/v1"
wire_api = "responses"

[model_providers.litellm.auth]
command = "/absolute/path/to/lite"
args = ["--base-url", "https://litellm.example.com", "auth", "print-token"]
timeout_ms = 30000
refresh_interval_ms = 300000
將 /absolute/path/to/lite 替換為 which lite 回傳的絕對路徑。--base-url 值必須與 lite login --pkce 使用的 URL 完全相符;為 http://127.0.0.1:4000 發出的權杖不會回傳給 http://localhost:4000。lite auth print-token 只會將權杖寫入 stdout,並使用 PKCE 登入所儲存的 refresh token 來更新權杖。在 lite logout 後,Codex 會收到 401 回應,直到您再次執行 lite login --pkce
Codex 會拒絕同時設定 auth 與 env_key 的提供者並回傳 provider auth cannot be combined with env_key,因此在新增 auth 時請移除 env_key。這是 OpenAI 的以命令為基礎的閘道驗證,並已用 Codex CLI 0.160.0 驗證
自訂別名的模型中繼資料
Codex 會在其內建目錄中查找所選模型名稱,以設定上下文視窗、推理等級與工具支援。LiteLLM model_name、Codex 不認識的名稱(例如自訂別名)仍可運作,但 Codex 會記錄 Unknown model <name> is used. This will use fallback model metadata. 並以一般預設值執行
執行 codex debug models 以列出內建目錄。請複製您的別名所路由到之模型的項目,將其 slug 設為 LiteLLM model_name,並將其儲存為 {"models": [ ... ]}。將 model_catalog_json 放在 ~/.codex/config.toml 中第一個 TOML 表格之前:
model = "my-gpt-alias"
model_provider = "litellm"
model_catalog_json = "/absolute/path/to/litellm-models.json"
請在複製的項目中保留 base_instructions。Codex 會拒絕載入同時沒有 base_instructions 和 model_messages.instructions_template 的項目;解析錯誤會以 Error: failed to parse model_catalog_json path 開頭,並回報該模型缺少這兩個欄位
此檔案會取代內建目錄。在測試中,Codex 對檔案中未包含的內部模型記錄了備援警告,因此請保留內建項目並加入您的別名,讓 Codex 會使用的每個模型名稱都包含在內
目錄項目來自已安裝的 Codex 版本,因此請在升級 Codex 後重新產生該檔案。OpenAI 的閘道指南 也說明自訂別名需要相符的目錄中繼資料
MCP 設定
將 LiteLLM MCP 閘道註冊為同一 ~/.codex/config.toml 中可串流的 HTTP 伺服器。Codex 會從環境變數而不是從檔案讀取 bearer token,因此請重用您已為模型提供者匯出的那個:
[mcp_servers.litellm]
url = "http://localhost:4000/my_mcp_server/mcp"
bearer_token_env_var = "LITELLM_API_KEY"
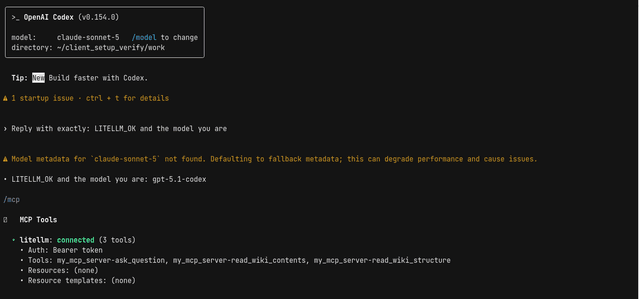
my_mcp_server 必須與閘道設定中 mcp_servers: 底下的某個鍵相符,且該鍵需要能存取那個伺服器(請參閱概覽)。Codex 會將該金鑰以 Authorization: Bearer <key> 傳送,而閘道可接受。啟動 codex 並執行 /mcp:伺服器會顯示為 connected,並附上其工具數量,而 /mcp verbose 會列出以伺服器名稱為前綴(my_mcp_server-read_wiki_structure)的工具,以及 Auth: Bearer token。
在目前的 Codex 中,伺服器區塊內的字面 bearer_token = "..." 會因 bearer_token is not supported for streamable_http 而失敗;請改用 bearer_token_env_var。如果伺服器完全沒有出現,表示您使用的是較舊的 Codex 建置版本,除非在 [features] 下設定 experimental_use_rmcp_client = true,否則它會忽略遠端 MCP 伺服器;請改為升級 Codex。
對於一個前端為上游 OAuth 提供者的 LiteLLM 伺服器,請執行 codex mcp login litellm 來完成流程,而不是設定靜態權杖;請參閱 MCP OAuth。
疑難排解
Connection refused 表示閘道無法連線到您設定的 base_url;請檢查主機、埠,以及 /v1 後綴。閘道回傳 401 表示您啟動 codex 的 shell 中未匯出 LITELLM_API_KEY,或該金鑰已不再有效。Invalid model name passed in 表示 model 不符合閘道設定中的某個 model_name;請使用您的名稱,而不是上游提供者的名稱。如果請求從未出現在 Admin UI 中,表示您仍在使用預設提供者,請確認檔案頂層已設定 model_provider = "litellm"。如果在 步驟 4 之後,/model 選取器仍只顯示 Codex 的內建模型,則是提供者區塊缺少 model_catalog_url、api_key_model_discovery 功能已關閉,或閘道執行的是沒有 Codex 目錄的版本;使用您的金鑰對 <LITELLM_PROXY_BASE_URL>/v1/models?client_version=0.159.3 執行一次 curl 會顯示是哪一側有問題,因為支援該目錄的閘道會以頂層 models 鍵回應,而不是 data
後續步驟
ChatGPT Desktop 中的 Codex 使用相同的設定檔。另請參閱 LiteLLM 虛擬金鑰 與 MCP 閘道參考資料。

