生產環境最佳實務
在正式上線前,請先完成本頁內容。此頁涵蓋生產環境組態、機器容量規劃與 worker 策略、Redis,以及資料庫與遷移;各段落彼此獨立,因此也可作為既有部署的檢視清單。關於 Postgres 與 Redis 執行個體本身要配置多大(包括 AWS、Azure 與 GCP 的執行個體建議),請參閱 資料庫容量規劃 與 Redis 容量規劃。若要了解更深入的容器調校,例如替代伺服器、代理層的 TLS、keepalive,以及從物件儲存載入組態,請參閱 伺服器調校。
組態
設定主金鑰
主金鑰是代理的管理員憑證:它用於驗證管理員 API 請求,也是 Admin UI 的登入密碼。請將其設為環境變數(必須以 sk- 開頭),妥善保存在您的密鑰管理系統中,並使用 主金鑰輪替流程 進行輪替。
export LITELLM_MASTER_KEY="sk-<long-random-value>"
設定受信任的代理範圍
Admin UI 登入失敗會依來源位址限制次數(請參閱 安全性最佳實務)。只有在代理知道哪個位址是用戶端時,此限制才會生效,因此請將 general_settings.trusted_proxy_ranges 設為 LiteLLM 前方負載平衡器或 ingress 的 CIDR 範圍;若用戶端直接連線,則設為 []。若未設定,代理會在啟動時發出警告,且只會套用較弱的每個使用者名稱限制。
general_settings:
  trusted_proxy_ranges: ["10.0.0.0/8"]   # or [] when clients connect directly
開啟警示
在 LLM 發生例外、請求過慢或卡住、超出預算、資料庫例外、服務中斷,以及每週支出報告時收到通知。在 Admin UI 中前往 Settings,再前往 Logging & Alerts,開啟 Alerting Types 分頁,切換您要的警示類型,貼上您的 Slack webhook URL,然後按一下 Test Alerts 以確認送達。門檻與報告頻率可在旁邊的 Alerting Settings 分頁中設定。
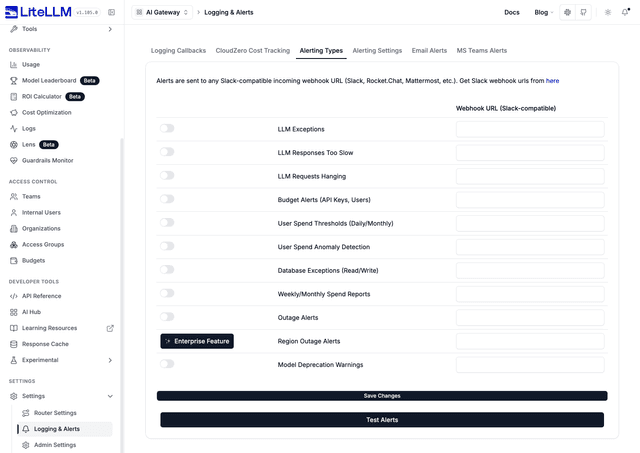
若要改為寫入組態,請在 general_settings 下設定 alerting: ["slack"],並在環境中匯出 SLACK_WEBHOOK_URL。
批次寫入支出
將支出更新每 60 秒寫入一次資料庫,而不是每個請求都寫入;在生產流量下,每個請求都寫入會讓資料庫成為熱點。
general_settings:
  proxy_batch_write_at: 60
當每秒大約超過 1000 個請求時,也請透過 Redis 交易緩衝區 來路由這些寫入,以避免連線耗盡與死結。
調整跨 pod 的組態重新載入
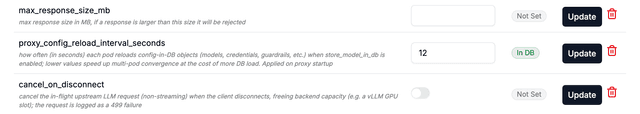
使用 store_model_in_db: true 時,每個 pod 都會透過背景工作,輪詢資料庫以與執行階段新增的組態(模型、憑證、防護欄、一般設定等)保持同步。這裡沒有跨 pod 的推送;pod 會在變更後的一個輪詢間隔內收斂。該間隔預設為 30 秒且可調整,因此若需要更快收斂可將其降低;若您在繁忙資料庫上執行許多 pod,則可將其提高以減輕負載。
general_settings:
  store_model_in_db: true
  proxy_config_reload_interval_seconds: 30
該值會在啟動時讀取,因此變更會在每個 pod 重新啟動後生效。也可在 Admin UI 的 General 分頁下的 Router Settings 中設定,或透過 PROXY_CONFIG_RELOAD_INTERVAL_SECONDS 環境變數設定。
限制資料庫連線
限制每個 worker process 的連線池,避免您的執行個體耗盡資料庫。將其大小設為 MAX_DB_CONNECTIONS / (instances × workers);預設值為 10。
general_settings:
  database_connection_pool_limit: 10
每個執行個體都會放大總連線數:3 個執行個體 × 4 個 worker × 10 條連線 = 對您的資料庫總共 120 條連線。
一旦 autoscaler 接管 replica 數量,該公式中的執行個體數就是 maxReplicas,而不是您目前執行的 pod 數量。litellm-helm 圖表預設將 autoscaling.maxReplicas 與 keda.maxReplicas 設為 100,因此完全擴展的部署在預設連線池上限 10 下,會要求大約 1000 條連線,遠超過標準 Postgres 可接受的範圍。請依照您的資料庫可提供的容量設定 maxReplicas,並參閱 如何計算正確數值 了解完整計算方式。
將錯誤記錄排除在資料庫之外
LLM 例外預設會寫入資料庫。在持續發生提供者錯誤時,這會使支出記錄表膨脹;請改為將例外送至您的記錄堆疊(請參閱 警示 與 記錄回呼)。
general_settings:
  disable_error_logs: True
設定請求逾時
讓卡住的請求失敗,而不是持續保持連線開啟;預設值為 6000 秒。
litellm_settings:
  request_timeout: 600
生產環境記錄
關閉除錯記錄、輸出 JSON 記錄,並靜音 FastAPI 的每請求資訊記錄:
litellm_settings:
  set_verbose: False
  json_logs: true
export LITELLM_LOG="ERROR"
停用 load_dotenv
設定 export LITELLM_MODE="PRODUCTION"。這會停用 load_dotenv(),否則它會自動從本機 .env 載入憑證。
設定鹽值金鑰
如果您使用資料庫,請設定鹽值金鑰以加密與解密已儲存的變數。新增模型後請勿變更;它會加密您的 LLM API key 憑證,變更後將無法讀取。請使用 密碼產生器 產生隨機雜湊。
export LITELLM_SALT_KEY="sk-<paste-a-long-random-key>"
容量規劃與 workers
機器規格
每個 pod 請配置 1 vCPU 與 4Gi 記憶體,且 requests 與 limits 都要設定;如果每個容器執行超過一個 worker,則兩者都要隨 worker 數量擴充。
resources:
  requests:
    cpu: "1" # should be 1*num_workers
    memory: "4Gi" # should be 4*num_workers
  limits:
    cpu: "1"
    memory: "4Gi"
這兩個數值都是以每個 worker 計算,因此該倍數是真實需求而非概略值:執行 8 個 worker 的容器需要 8 vCPU 與 32Gi,而不是 1 vCPU 與 4Gi。從單一 worker 的數值去規劃多 worker 容器,常會導致資源不足;這也是在 Kubernetes 上維持每個 pod 一個 worker,並讓 replica 而不是 worker 承擔並行度的主要原因。
4Gi 是底線,而不是目標。代理的穩態記憶體占用並不是取決於同時服務多少請求:Prisma 會將查詢引擎作為獨立程序執行,而其常駐記憶體行為像是高水位標記,會成長到該引擎曾執行過的最大單一語句所需大小,之後 glibc 也不會把那段記憶體還給作業系統。因此,pod 的底線會一路累積到它歷來最糟的一次寫入並在 worker 的生命週期內維持不變。若配置低於 4Gi,單次大型寫入就足以讓 pod 超過限制並被核心 OOM-kill,這會在其他各項指標看起來都很正常的流量下表現為 crash loop。
最大的語句來自啟用 store_prompts_in_spend_logs 的支出記錄,因為此時每一列都會帶上完整的 prompt 與回應,而不只是計數器。若您儲存 prompts,請將 4Gi 視為最低值,並為 pod 保留更高的餘裕。
自動擴縮
請以 CPU 為擴縮依據,並保持 memory 目標未設定。Memory 對代理而言不是可用的擴縮訊號:查詢引擎的常駐記憶體反映的是 pod 曾經做過的最大寫入,而不是目前正在做的事情,因此一旦有單次大型寫入,memory 目標就會把 replica 一路往上推,且不會再縮回來。請將記憶體配置為上述底線,並讓 CPU 決定 replica 數量。
targetCPUUtilizationPercentage: 60
之所以使用 60 而不是更高的門檻,是因為 replica 一建立完成並不代表可立即使用。litellm-helm 啟動探針最多允許 300 秒讓 pod 通過第一次 readiness 檢查,因此在 CPU 達到 80% 時新增的 replica,會在觸發飽和數分鐘後才到位。兩個圖表都內建較高的預設值:litellm-helm 為 80,而分組圖表的 gateway 為 70;這些數值是為了讓圖表能在任何環境順利安裝。請在生產環境中將其調低。
Worker 與擴縮
在 Kubernetes 上,或者在任何其他正在讀取 CPU 的 pod 層級 autoscaler 環境中,每個 pod 執行一個 Uvicorn worker,並水平擴充(增加 pod 數量)而不是垂直擴充(增加每個 pod 的 worker 數量)。這是預設設定,所以您只需要 --num_workers 1;每個 pod 一個程序可讓延遲保持可預測,讓 Horizontal Pod Autoscaler 針對單一程序讀取上方的 CPU 閾值,而且因為 Kubernetes 一次只排空一個 pod,所以能讓滾動重啟無中斷。
CMD ["--port", "4000", "--config", "./proxy_server_config.yaml", "--num_workers", "1"]
在單一 VM 或裸容器上,如果沒有任何東西幫您做擴充,則情況相反:將 NUM_WORKERS 設為該機器的 vCPU 數量,因為沒有其他東西會讓那些核心投入工作。容量與連線限制都是按每個 worker 計算,所以一台執行八個 worker 的機器,需要上方記憶體底限的八倍,以及連線池的八分之一。
如果您在持續負載下看到記憶體逐漸成長,請在固定的請求數之後使用 --max_requests_before_restart 回收每個 worker,以限制記憶體使用量。
CMD ["--port", "4000", "--config", "./proxy_server_config.yaml", "--num_workers", "1", "--max_requests_before_restart", "10000"]
若要在一個容器中配置多個 worker、替代伺服器(Gunicorn、Hypercorn、Granian)、以 jitter 錯開回收、Kubernetes 上的無中斷滾動重啟、在代理端終止 TLS、keepalive 調校,以及從 S3 或 GCS 載入 config.yaml,請參閱 伺服器調校。
在專用 worker 上執行背景工作
啟動時,proxy 會註冊背景工作的排程器,而且每個 Uvicorn worker 程序只會註冊一次,而不是每個 pod 一次。以 --num_workers 4 啟動的 pod 會執行每個工作的四份副本,因此十個這類 replica 的部署會執行四十份,而工作數量會隨 replica 乘以程序數量倍增,即使這些工作大多原本只應執行一次。
其效果是共享的工作,例如重設預算、清理 spend log 或推送使用量匯出,會在執行任何動作前先透過 Redis 選出單一擁有者。未設定 Redis 時,沒有可供選舉的機制,因此每個註冊它的程序都會不受保護地執行。LITELLM_JOB_ROLE 可讓您在一個 deployment 上註冊這些工作,而不是在每個處理流量的 replica 上註冊;對於沒有 Redis 的多 pod deployment,這是達成單次執行的唯一方法。
LITELLM_JOB_ROLE | 程序註冊的內容 |
|---|---|
未設定,或 all | 每個工作。這是預設值,也是您已經擁有的行為 |
worker | 每個工作,包括單一擁有者的工作 |
serving | 不註冊任何單一擁有者工作 |
解析不區分大小寫,並且會忽略前後空白。無法辨識的值會回退到 all 並記錄警告,因此拼字錯誤不會在沒有提示的情況下停止某個 deployment 的預算重設。
設定為 serving 的 pod 會停止註冊預算重設工作、spend log 清理、金鑰輪替、過期的 Admin UI session key 清理、PTU 固定成本彙總、每週與每月 spend 報表、Prometheus fallback stats、batch 與 responses 成本輪詢,以及 CloudZero、Focus、Vantage 與 Mavvrik 使用量匯出。
它仍會註冊 spend flush、每日標籤 spend flush、gateway 請求計數器 flush、定期設定重新載入,以及資料庫 model 與憑證重新載入,因為這些工作各自只是排空該 pod 自己的記憶體佇列,或重新整理該 pod 自己的 model 註冊表,而不是作用於另一個 pod 也可能作用的狀態。因此,serving pod 仍會將自己的 spend 寫入資料庫,並持續接收在執行階段新增的 model;這個角色改變的是它排程哪些共享工作,而不是它是否追蹤自己所服務的內容。
擁有權在執行階段可被觀察。當選出的 pod 會在 INFO 層級記錄 <job name>: pod <id> owns this run,而 litellm_pod_lock_manager_size Prometheus gauge 帶有 <job>:<pod> 標籤,用來命名該工作以及持有其 lock 的 pod。
Kubernetes 參考拓撲
照常擴充 serving Deployment,並讓 worker 保持一個 replica。兩者都指向同一個資料庫與同一個 Redis,這使得 worker 能接手那些 serving pods 不再註冊的工作。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: litellm-serving
spec:
  replicas: 10
  selector:
    matchLabels:
      app: litellm-serving
  template:
    metadata:
      labels:
        app: litellm-serving
    spec:
      containers:
        - name: litellm
          image: docker.litellm.ai/berriai/litellm:v1.98.0 # pin a version, do not use :latest
          args: ["--config", "/app/proxy_server_config.yaml", "--num_workers", "1"]
          ports:
            - containerPort: 4000
          env:
            - name: LITELLM_JOB_ROLE
              value: serving
          envFrom:
            - secretRef:
                name: litellm-secrets # DATABASE_URL, REDIS_HOST, REDIS_PORT, REDIS_PASSWORD, LITELLM_MASTER_KEY
          volumeMounts:
            - name: config-volume
              mountPath: /app/proxy_server_config.yaml
              subPath: config.yaml
          readinessProbe:
            httpGet:
              path: /health/readiness
              port: 4000
            initialDelaySeconds: 120
            periodSeconds: 15
      volumes:
        - name: config-volume
          configMap:
            name: litellm-config-file
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: litellm-jobs
spec:
  replicas: 1
  selector:
    matchLabels:
      app: litellm-jobs
  template:
    metadata:
      labels:
        app: litellm-jobs
    spec:
      containers:
        - name: litellm
          image: docker.litellm.ai/berriai/litellm:v1.98.0 # keep in lockstep with the serving image
          args: ["--config", "/app/proxy_server_config.yaml", "--num_workers", "1"]
          ports:
            - containerPort: 4000
          env:
            - name: LITELLM_JOB_ROLE
              value: worker
          envFrom:
            - secretRef:
                name: litellm-secrets # the same secret, so both reach the same database and Redis
          volumeMounts:
            - name: config-volume
              mountPath: /app/proxy_server_config.yaml
              subPath: config.yaml
          readinessProbe:
            httpGet:
              path: /health/readiness
              port: 4000
            initialDelaySeconds: 120
            periodSeconds: 15
      volumes:
        - name: config-volume
          configMap:
            name: litellm-config-file
將您的 Service 和 Ingress 都只指向 app: litellm-serving,讓 worker 不承擔任何請求流量。給 worker 一個 Uvicorn worker,原因和 serving pods 只給一個相同,因為第二個程序會在原本只應執行一次的那個 deployment 上,註冊每個工作的第二份副本。
Redis
只要您執行超過一個 proxy instance,就請執行 Redis(7.0 或更新版本)。它會在各個 instance 之間共享速率限制計數器、路由 state 與回應快取;沒有它時,每個 instance 都會獨立執行限制,而且快取命中會停留在處理該請求的 instance 本機。若要查看沒有它時哪些功能會退化或停止運作的完整清單,請參閱 需要 Redis 的項目。
router_settings:
  routing_strategy: simple-shuffle # (default) - recommended for best performance
  redis_host: os.environ/REDIS_HOST
  redis_port: os.environ/REDIS_PORT
  redis_password: os.environ/REDIS_PASSWORD

litellm_settings:
  cache: True
  cache_params:
    type: redis
    host: os.environ/REDIS_HOST
    port: os.environ/REDIS_PORT
    password: os.environ/REDIS_PASSWORD
高流量部署請維持預設的 simple-shuffle 路由策略;基於使用量的路由會在請求路徑中加入 Redis 查詢。若要了解應配置多少 Redis,以及在每個雲端應選擇哪種代管方案,請參閱 Redis 容量規劃。
Redis 交易緩衝區
在極高流量下(大約每秒 1000+ 請求,或 10+ instance),spend 追蹤本身會成為資料庫瓶頸:每個 instance 都會對相同的 key、user 與 team rows 發出 UPDATE/UPSERT 陳述式,這會造成死結,並可能耗盡 Postgres 連線(FATAL: sorry, too many clients already)。交易緩衝區改為透過 Redis 路由這些寫入:每個 instance 將自己的 spend 更新排入 Redis,而持有 Redis 支援 lock 的單一 instance 會彙總佇列,並以單一 transaction 將其刷入資料庫。
general_settings:
  use_redis_transaction_buffer: true
使用 litellm_pod_lock_manager_size Prometheus 指標(哪個 pod 持有 flush lock)以及 litellm_in_memory_spend_update_queue_size / litellm_redis_spend_update_queue_size gauge(在記憶體與 Redis 中等待的 spend 更新;_daily_ 變體會追蹤每位 user 的每日彙總)來監控它。如果您在負載下看到 Got exception from REDIS No connection available,請提高您的 Redis max_connections 中的 cache_params。
資料庫與 migrations
若要了解 instance 大小、儲存與 IOPS、各雲端代管 Postgres 的連線上限,以及如何避免 spend log 寫入路徑成為您必須調整容量的項目,請參閱 資料庫容量規劃。
優雅地處理 DB 無法使用
當 LiteLLM 執行於 VPC 上(且無法從公開網際網路存取)時,您可以啟用優雅降級,讓即使資料庫暫時不可用,請求處理仍可繼續。
警告:只有在您於 VPC 上執行 LiteLLM,且無法從公開網際網路存取時才這麼做。
general_settings:
  allow_requests_on_db_unavailable: True
當 allow_requests_on_db_unavailable 設定為 true 時,LiteLLM 會依下列方式處理錯誤:
| 錯誤類型 | 預期行為 | 詳細資料 |
|---|---|---|
| Prisma 連線錯誤 | 請求將被允許 | 無法連上資料庫引擎(連線被拒絕或重設,EngineConnectionError)。請求會以受限的 INTERNAL_USER fallback 身分繼續執行,絕不會是 admin。 |
| Prisma 查詢錯誤(P2xxx,例如 P2010) | 請求將被阻擋 | 資料庫已回應,但查詢失敗,因此無法驗證金鑰,請求會得到 401。因為資料庫可連線,所以視為 fail-closed。 |
| Httpx 錯誤 | 請求將被允許 | 發生於資料庫無法連線時,讓請求即使在 DB 故障期間也能繼續。 |
| Pod 啟動行為 | pod 仍會啟動 | 即使資料庫當機或無法連線,LiteLLM Pods 仍會啟動,以確保部署具有更高的 uptime 保證。 |
| 健康狀態/Readiness 檢查 | 一律回傳 200 OK | /health/readiness 端點會回傳 200 OK 狀態,以確保即使資料庫無法使用,pod 仍保持可運作。 |
| LiteLLM 預算錯誤或 model 錯誤 | 請求將被阻擋 | 當 DB 可連線,但驗證 token 無效、沒有存取權限,或超出預算限制時觸發。 |
在資料庫中斷期間,已在記憶體中的 auth cache 內的 virtual key 會持續通過驗證,直到 user_api_key_cache_ttl 過期;其預設值為 60 秒,並可因 enable_redis_auth_cache 而更長;請參閱 caching_redis。config 檔案中定義的 master key 與 model 會持續運作。未快取的 virtual key 查詢、key/team/user 管理端點,以及 spend log 寫入會失敗,或延後到資料庫恢復後再處理
驗證資料庫伺服器憑證(自訂 CA,例如 AWS RDS)
託管式 Postgres(AWS RDS、Cloud SQL、Azure Flexible Server、內部 PKI)會提供由提供者自家 CA 簽發的憑證,而這個 CA 不在預設映像檔的信任存放區中。您不需要自訂映像檔也能驗證它:將 CA 憑證束掛載到容器中,並使用提供者文件提供的相同 libpq 參數將 DB URL 指向它。
export DATABASE_URL="postgresql://user:pass@mydb.abc123.us-east-1.rds.amazonaws.com:5432/litellm?sslmode=verify-full&sslrootcert=/certs/global-bundle.pem"
LiteLLM 會將 sslmode=verify-full(或 verify-ca)以及 sslrootcert 重新寫入其 Postgres 驅動程式可理解的參數(sslmode=require、sslcert=<bundle>、sslaccept=strict)中,並在 DATABASE_URL、DIRECT_URL 與 DATABASE_URL_READ_REPLICA 上這麼做,因此每次連線都會檢查伺服器憑證鏈與主機名稱,包括遷移時。若伺服器的憑證無法鏈結到已掛載的憑證束,啟動時就會因 P1011: Error opening a TLS connection ... certificate verify failed 而失敗。此驅動程式沒有僅檢查憑證鏈的模式,因此 verify-ca 也會檢查主機名稱。直接設定驅動程式參數(sslmode=require&sslcert=/certs/global-bundle.pem&sslaccept=strict)同樣可行,而您自行固定的任何驅動程式參數都會優先於轉換結果。這些相同的鍵也可以透過 database_extra_connection_params 從設定而非 URL 設定(請參閱 Cap Idle DB Connections + Pass Extra Prisma URL Params)。
純 Docker:
docker run \
  -v /path/to/global-bundle.pem:/certs/global-bundle.pem:ro \
  -e DATABASE_URL="postgresql://user:pass@mydb.abc123.us-east-1.rds.amazonaws.com:5432/litellm?sslmode=verify-full&sslrootcert=/certs/global-bundle.pem" \
  -e LITELLM_MASTER_KEY="sk-<paste-a-long-random-key>" \
  -p 4000:4000 \
  ghcr.io/berriai/litellm:main-stable --config /app/config.yaml
Helm:將憑證束放入 ConfigMap 或 Secret,並透過 volumes / volumeMounts 掛載。Deployment 與 migrations Job 都會取得這些掛載,因此 migrations 也會驗證憑證。
kubectl create configmap rds-ca --from-file=global-bundle.pem
db:
  useExisting: true
  endpoint: mydb.abc123.us-east-1.rds.amazonaws.com
  database: litellm
  url: postgresql://$(DATABASE_USERNAME):$(DATABASE_PASSWORD)@$(DATABASE_HOST)/$(DATABASE_NAME)?sslmode=verify-full&sslrootcert=/certs/global-bundle.pem
volumes:
  - name: rds-ca
    configMap:
      name: rds-ca
volumeMounts:
  - name: rds-ca
    mountPath: /certs
    readOnly: true
從 AWS 下載 RDS 憑證束;其他提供者也會以相同方式發布他們的憑證束。這與 SSL_CERT_FILE 不同,後者只會影響 LiteLLM 對 LLM 提供者與回呼的外送 HTTPS 請求;DB 驅動程式不會讀取它。若您兩者都需要,請掛載一個憑證束,並讓兩個設定都指向它。
錯開排程背景工作
LiteLLM 會對資料庫執行一組排程背景工作:spend flushes、daily tag spend、budget resets、config-in-DB 重新載入、credential 重新載入、spend log retention cleanup,以及您啟用的任何 cost export 整合。這些工作會在 proxy 啟動時全部註冊,而 interval 工作的第一次執行會在那個時刻之後的一個 interval,因此若不錯開,它們會在同一時刻全部觸發;在 rollout 一起啟動的每個副本上都如此,且在程序存續期間都會如此。在大型部署中,這會表現為週期性的資料庫 CPU 尖峰,並與請求路徑驗證與 budget 查詢競爭資源。
LiteLLM 預設會將它們分散。每個工作都會依其 scheduler job id 與執行該工作的程序身分導出的確定性偏移量進行位移,因此同一個 pod 上的兩個工作會落在不同時刻;同一個工作在每個副本上也會落在不同時刻;同時重啟也不會把所有工作重新放回同一個時間戳記。任何工作都不會被延遲超過其自身週期的一次。
這些預設值適合大多數部署。對於大型多 pod 叢集,請加寬視窗,讓相同數量的工作分散到更長的時間內:
general_settings:
  scheduled_job_stagger:
    window_seconds: 600
套用的偏移量會在啟動時以 INFO 等級記錄一次,作為單行內容,列出身分、視窗,以及每個工作的偏移量,因此您在除錯的排程可以從記錄中重現,而不是靠猜測。將記錄層級設為 DEBUG,還可取得每次觸發的排定時間與實際開始時間的對照。
偏移量絕不會影響您自行提供的 cron 排程,例如 maximum_spend_logs_cleanup_cron,因為那指定的是您選定的某個時刻。若要將 LiteLLM 自己的其中一個工作固定在未位移的排程上,或將其精確放到您想要的位置,請明確設定其偏移量:
general_settings:
  scheduled_job_stagger:
    offsets:
      update_spend_job: 0
      ptu_flat_cost_rollup_job: 900
副本會使用 POD_NAME 被放入視窗中,若失敗則退回到 HOSTNAME,再來是系統主機名稱,以及 worker process id。若您的副本共用同一個主機名稱,請為每個副本提供不同的 identity,以免它們落在相同的偏移量上。設定 enabled: false 可關閉整個機制並恢復先前的行為。
透過 Helm PreSync hook 執行 migrations
Helm PreSync hook 流程目前為 beta 版。
為了確保只有一個服務管理資料庫遷移,請使用我們的 Helm PreSync Hook for Database Migrations。這可確保遷移在 helm upgrade 或 helm install 期間處理,而 LiteLLM pods 則明確停用遷移。
- Helm PreSync Hook:
- Helm PreSync hook 已在 chart 中設定,會在部署期間執行資料庫 migrations。
- 此 hook 一律會設定
DISABLE_SCHEMA_UPDATE=false,確保 migrations 能可靠執行。
供 ArgoCD 設定的參考設定,用於 values.yaml
db:
  useExisting: true # use existing Postgres DB
  url: postgresql://ishaanjaffer0324:... # url of existing Postgres DB
-
LiteLLM Pods:
- 在 LiteLLM pod 設定中設定
DISABLE_SCHEMA_UPDATE=true,以避免它們執行 migrations。
LiteLLM pod 的範例設定:
env:
  - name: DISABLE_SCHEMA_UPDATE
value: "true" - 在 LiteLLM pod 設定中設定
使用 prisma migrate deploy
LiteLLM 預設會在啟動時執行 prisma migrate deploy,因此在正式環境中,db migrations 會跨版本處理而不需要任何設定。若要讓某個 pod 完全不執行 migrations,請如 透過 Helm PreSync hook 執行 migrations 所述設定 DISABLE_SCHEMA_UPDATE=true。
較舊版本會透過 USE_PRISMA_MIGRATE="True" 來限制此行為。當 migrate deploy 成為預設值時,該旗標已在 PR #13555 中移除,而這個頁面在之後仍持續建議使用它。現在設定 USE_PRISMA_MIGRATE 不會產生任何作用;可以安全地從您的環境中移除,而且移除後不會改變 migration 行為
migrate deploy 指令:
- 不會 在已套用的 migration 自 migration history 中缺失時發出警告
- 不會 偵測 drift(production 資料庫結構描述與 migration history 結尾狀態不同,例如因 hotfix 造成)
- 不會 重設資料庫或產生構件(例如 Prisma Client)
- 不會 依賴 shadow database
LiteLLM 如何提供 migrations:
-
會將新的 migration 檔案寫入我們的
litellm-proxy-extras套件。 查看全部 -
核心 litellm pip 套件會更新,以指向新的
litellm-proxy-extras套件。這可確保舊版 LiteLLM 會繼續使用舊的 migrations。 查看程式碼 -
當您升級到新版 LiteLLM 時,migration 檔案會套用到資料庫。 查看程式碼
唯讀檔案系統
在 Kubernetes 中以 readOnlyRootFilesystem: true 執行 LiteLLM 是安全最佳實務,可防止容器程序寫入 root 檔案系統。LiteLLM 完全支援此設定。
如果您看到 Permission denied 錯誤,表示 LiteLLM pod 是以唯讀檔案系統執行。LiteLLM 需要可寫入的目錄,用於:
- 資料庫遷移:設定
LITELLM_MIGRATION_DIR="/path/to/writable/directory" - 管理 UI:設定
LITELLM_UI_PATH="/path/to/writable/directory" - UI 資產/標誌:設定
LITELLM_ASSETS_PATH="/path/to/writable/directory"
選項 1:使用 EmptyDir Volumes 搭配 InitContainer(建議)
此方法會在 pod 啟動時,將 Docker 映像中的預先建置 UI 複製到可寫入的 emptyDir volumes。
完整 Deployment manifest(initContainer、env、securityContext、volumes)
apiVersion: apps/v1
kind: Deployment
metadata:
  name: litellm-proxy
spec:
  template:
    spec:
      initContainers:
        - name: setup-ui
          image: ghcr.io/berriai/litellm:latest
          command:
            - sh
            - -c
            - |
              cp -r /var/lib/litellm/ui/* /app/var/litellm/ui/ && \
              cp -r /var/lib/litellm/assets/* /app/var/litellm/assets/
          volumeMounts:
            - name: ui-volume
              mountPath: /app/var/litellm/ui
            - name: assets-volume
              mountPath: /app/var/litellm/assets

      containers:
        - name: litellm
          image: ghcr.io/berriai/litellm:latest
          env:
            - name: LITELLM_NON_ROOT
              value: "true"
            - name: LITELLM_UI_PATH
              value: "/app/var/litellm/ui"
            - name: LITELLM_ASSETS_PATH
              value: "/app/var/litellm/assets"
            - name: LITELLM_MIGRATION_DIR
              value: "/app/migrations"
            - name: PRISMA_BINARY_CACHE_DIR
              value: "/app/cache/prisma-python/binaries"
            - name: XDG_CACHE_HOME
              value: "/app/cache"
          securityContext:
            readOnlyRootFilesystem: true
            runAsNonRoot: true
            runAsUser: 101
            capabilities:
              drop:
                - ALL
          volumeMounts:
            - name: config
              mountPath: /app/config.yaml
              subPath: config.yaml
              readOnly: true
            - name: ui-volume
              mountPath: /app/var/litellm/ui
            - name: assets-volume
              mountPath: /app/var/litellm/assets
            - name: cache
              mountPath: /app/cache
            - name: migrations
              mountPath: /app/migrations

      volumes:
        - name: config
          configMap:
            name: litellm-config
        - name: ui-volume
          emptyDir:
            sizeLimit: 100Mi
        - name: assets-volume
          emptyDir:
            sizeLimit: 10Mi
        - name: cache
          emptyDir:
            sizeLimit: 500Mi
        - name: migrations
          emptyDir:
            sizeLimit: 64Mi
選項 2:不含 UI(僅 API 部署)
如果您不需要管理 UI,可以使用最小化設定執行:
env:
  - name: LITELLM_NON_ROOT
    value: "true"
  - name: LITELLM_MIGRATION_DIR
    value: "/app/migrations"
securityContext:
  readOnlyRootFilesystem: true
proxy 會針對 UI 記錄警告,但 API 端點會正常運作。
唯讀檔案系統的環境變數:
| 變數 | 用途 | 預設值 |
|---|---|---|
LITELLM_UI_PATH | 管理 UI 目錄 | /var/lib/litellm/ui (Docker) |
LITELLM_ASSETS_PATH | UI 資產/標誌 | /var/lib/litellm/assets (Docker) |
LITELLM_MIGRATION_DIR | 資料庫遷移 | 套件目錄 |
PRISMA_BINARY_CACHE_DIR | Prisma 二進位快取 | 系統預設值 |
XDG_CACHE_HOME | 一般快取目錄 | 系統預設值 |
注意:一律將 LITELLM_MIGRATION_DIR 設為可寫入的 emptyDir 路徑,並將 PRISMA_BINARY_CACHE_DIR 與 XDG_CACHE_HOME 設為可寫入路徑。若使用自訂 server_root_path,您必須在 Dockerfile 中預先處理 UI 檔案,因為 proxy 無法在執行時於唯讀檔案系統上修改檔案。若 UI 含有由官方 Docker 映像檔建立的 .litellm_ui_ready marker file,系統會自動判定其為已預先重構。
驗證正式環境就緒狀態
預期效能
請參閱 這裡 的基準測試。
確認已關閉 debug 記錄
您在 proxy 伺服器上的記錄中,應只看到以下等級的詳細資訊:
# INFO:     192.168.2.205:11774 - "POST /chat/completions HTTP/1.1" 200 OK
# INFO:     192.168.2.205:34717 - "POST /chat/completions HTTP/1.1" 200 OK
# INFO:     192.168.2.205:29734 - "POST /chat/completions HTTP/1.1" 200 OK
部署 FAQ
Q: Postgres 是唯一支援的資料庫嗎?還是您也支援其他資料庫(例如 Mongo)?
A: 我們曾評估過 MySQL,但維護上很困難,並且替客戶帶來了 bug。現階段,PostgreSQL 是我們在正式部署中主要支援的資料庫。
因為 LiteLLM 是透過 Prisma 與 PostgreSQL wire protocol 與資料庫溝通,所以任何與 Postgres-wire 相容的分散式 SQL 資料庫都可以直接替換使用。YugabyteDB 就是在正式環境中以這種方式使用;只要將 DATABASE_URL 指向其 YSQL endpoint(postgresql://<user>:<password>@<host>:<port>/<dbname>),LiteLLM 就會不加修改地執行 migrations 與查詢。若您需要超越單一 Postgres 執行個體所能提供的水平擴充或多區域高可用性,這會是很適合的選擇。
Q: 如果 Postgres 發生停機,LiteLLM 會如何反應?會 fail-open 還是會有 API 停機?
A: 若 DB 不可用發生在您的 VPC 內,您可以優雅地處理它;請參閱上方的 優雅處理 DB 不可用。
需要協助或想要專屬支援嗎?請在 這裡 與創辦人對談。

