📈 Prometheus 指標
LiteLLM 會提供一個供 Prometheus 輪詢的 /metrics 端點
快速開始
如果您使用的是搭配 litellm --config proxy_config.yaml 的 LiteLLM CLI,那麼您需要 uv add prometheus_client==0.20.0。這已經預先安裝在 litellm Docker 映像中
將以下內容加入您的 proxy config.yaml
model_list:
  - model_name: gpt-5.6-terra
    litellm_params:
      model: gpt-5.6-terra
litellm_settings:
  callbacks:
    - prometheus
啟動 proxy
litellm --config config.yaml --debug
測試請求
curl --location 'http://0.0.0.0:4000/chat/completions' \
    --header 'Content-Type: application/json' \
    --data '{
    "model": "gpt-5.6-terra",
    "messages": [
        {
        "role": "user",
        "content": "what llm are you"
        }
    ]
}'
在 /metrics 上檢視指標:
curl http://localhost:4000/metrics \
  -H "Authorization: Bearer sk-..."
多個工作程序
當使用 LiteLLM 搭配多個工作程序時,您需要設定 PROMETHEUS_MULTIPROC_DIR 環境變數,才能啟用跨工作程序的彙總指標收集。
export PROMETHEUS_MULTIPROC_DIR="/prometheus_multiproc"
此目錄供 Prometheus client library 使用,用來儲存可在多個工作程序之間共享的指標檔案。請確定該目錄存在,且 LiteLLM 程序可寫入。
將 Prometheus 擷取與推論流量隔離
預設情況下,LiteLLM 會在 proxy 連接埠上,使用同一組提供推論請求服務的 Uvicorn worker 來輸出 /metrics。在多 worker 部署中,每次擷取都會彙總跨 worker 的 Prometheus 資料。因此,大型或高基數的指標集合可能會消耗提供請求服務之 worker 的 CPU,並增加尾端延遲。
LiteLLM v1.101.0 及更新版本可從專用程序提供相同的指標集合。設定 --prometheus_metrics_port 或 PROMETHEUS_METRICS_PORT,然後更新 Prometheus 以擷取該連接埠。proxy 連接埠上的原始 /metrics 路由仍可使用,以維持向後相容,因此您可以在不中斷推論流量的情況下遷移擷取目標。
必須啟用 prometheus 回呼。當設定了專用連接埠時,LiteLLM 會在需要時建立 PROMETHEUS_MULTIPROC_DIR,將指標程序繫結到 proxy --host,並在 proxy 結束時一併停止該程序。
litellm --config config.yaml --num_workers 4 --prometheus_metrics_port 4001
scrape_configs:
  - job_name: litellm
    static_configs:
      - targets: ["litellm:4001"]
專用監聽器不使用 LiteLLM virtual-key 驗證。require_auth_for_metrics_endpoint 只適用於 proxy 連接埠上的 /metrics。僅允許受信任的 Prometheus 或收集器網路存取,且不要透過公開 ingress 或 load balancer 公開該專用連接埠。
部署設定
- Helm: litellm-helm
- Helm: componentized
- Terraform: AWS
metricsServer:
  enabled: true
  port: 4001

serviceMonitor:
  enabled: true
此 chart 會建立一個專用的 <release>-litellm-metrics ClusterIP Service,並將 ServiceMonitor 導向它。主要 Service 不會變更,即使 service.type 為 LoadBalancer 也是如此。metricsServer.port 必須與 service.port 不同。
gateway:
  metricsServer:
    enabled: true
    port: 4001
此 chart 會將 metrics server 以 sidecar 形式執行,並與 gateway 共用 Prometheus multiprocess 資料。它會透過專用的 <release>-litellm-gateway-metrics ClusterIP Service 公開該監聽器;請將 Prometheus 設定為探索該私有 Service。gateway Service 保持不變。
module "litellm" {
  source  = "BerriAI/litellm/aws"
  version = "~> 1.101"

  gateway_metrics_port         = 4001
  gateway_metrics_scrape_cidrs = ["10.0.0.0/16"]
}
此模組會將非必要的 metrics sidecar 加入 gateway task,並只允許來自 gateway_metrics_scrape_cidrs 的流入流量使用該連接埠。Application Load Balancer 不會路由到 metrics 連接埠。當 gateway_metrics_port 為 null 時,該功能會停用,這也是預設值,而連接埠 4000 保留給 gateway 流量使用。
驗證 rollout
在變更 Prometheus 目標之前,先檢查專用程序:
curl -fsS http://litellm:4001/health
# {"status":"healthy","multiproc_dir":"..."}

curl -fsS http://litellm:4001/metrics/ | head
專用端點支援與 proxy 連接埠端點相同的指標、標籤設定、篩選與壓縮。Proxy readiness 仍可在連接埠 4000 的 /health/readiness 使用。
虛擬金鑰、團隊、內部使用者
用於追蹤每個 user、key、team 等
| 指標名稱 | 說明 |
|---|---|
litellm_spend_metric | 總支出,依 "end_user", "hashed_api_key", "api_key_alias", "model", "team", "team_alias", "user", "user_email", "client_ip", "user_agent", "requested_model", "model_id", "api_provider", "service_tier" |
litellm_total_tokens_metric | 每個 "end_user", "hashed_api_key", "api_key_alias", "model", "team", "team_alias", "user", "user_email", "requested_model", "model_id", "api_provider" 的輸入 + 輸出 token |
litellm_input_tokens_metric | 每個 "end_user", "hashed_api_key", "api_key_alias", "model", "team", "team_alias", "user", "user_email", "requested_model", "model_id", "api_provider" 的輸入 token |
litellm_output_tokens_metric | 每個 "end_user", "hashed_api_key", "api_key_alias", "model", "team", "team_alias", "user", "user_email", "requested_model", "model_id", "api_provider" 的輸出 token |
Token 類型詳細指標
按 token 類型區分的計數器,會拆分提供者回報的 usage.prompt_tokens_details 與 usage.completion_tokens_details 欄位(例如 OpenAI prompt caching、Anthropic prompt caching、audio I/O、reasoning tokens)。這些會在上述總計之上 額外累加,而既有的 litellm_input_tokens_metric / litellm_output_tokens_metric / litellm_total_tokens_metric 計數器不變。
每個詳細計數器都是稀疏的:只有當提供者回報對應欄位的非零值時才會遞增,因此未公開某項詳細資訊的提供者不會為其產生序列。標籤集合與父層的輸入 / 輸出 token 計數器相同,因此您可以在 PromQL 中順利進行 join。
| 指標名稱 | usage 上的來源欄位 | 典型提供者 |
|---|---|---|
litellm_input_cached_tokens_metric | prompt_tokens_details.cached_tokens | OpenAI prompt cache、Anthropic cache_read_input_tokens、DeepSeek prompt_cache_hit_tokens |
litellm_input_cache_creation_tokens_metric | prompt_tokens_details.cache_creation_tokens | Anthropic cache_creation_input_tokens(prompt cache writes) |
litellm_input_audio_tokens_metric | prompt_tokens_details.audio_tokens | OpenAI gpt-4o-audio-*、Gemini 音訊輸入 |
litellm_output_reasoning_tokens_metric | completion_tokens_details.reasoning_tokens | OpenAI o1-* / o3-*、Anthropic extended thinking |
litellm_output_audio_tokens_metric | completion_tokens_details.audio_tokens | OpenAI gpt-4o-audio-* 音訊輸出 |
PromQL 範例,模型群組的 cache-hit 比率:
sum by (requested_model) (rate(litellm_input_cached_tokens_metric_total[5m]))
/
sum by (requested_model) (rate(litellm_input_tokens_metric_total[5m]))
PromQL 範例,輸出中 reasoning-token 的占比:
sum by (requested_model) (rate(litellm_output_reasoning_tokens_metric_total[5m]))
/
sum by (requested_model) (rate(litellm_output_tokens_metric_total[5m]))
litellm_input_cached_tokens_metric 會追蹤提供者端的 prompt-cache 讀取(提供者回報輸入內容中被快取的部分)。這與 litellm_cached_tokens_metric 不同,後者追蹤的是 LiteLLM 自身的回應快取命中(整個回應直接由 LiteLLM 的快取提供,且未發送任何提供者請求)。
快取指標
追蹤 LiteLLM 自身的回應快取。這三個指標都帶有 "model", "hashed_api_key", "api_key_alias", "team", "team_alias", "end_user", "user", "model_id", "api_provider" 標籤。
| 指標名稱 | 說明 |
|---|---|
litellm_cache_hits_metric | 完全由 LiteLLM 的回應快取提供服務的請求(未發出提供者請求) |
litellm_cache_misses_metric | 未命中 LiteLLM 回應快取的請求 |
litellm_cached_tokens_metric | 由 LiteLLM 的回應快取提供的 token |
團隊 - 預算
| 指標名稱 | 說明 |
|---|---|
litellm_team_max_budget_metric | 團隊標籤的最大預算:"team", "team_alias" |
litellm_remaining_team_budget_metric | 團隊剩餘預算(在 LiteLLM 上建立的團隊)標籤:"team", "team_alias" |
litellm_team_budget_remaining_hours_metric | 團隊預算重設前的剩餘小時數 標籤:"team", "team_alias" |
虛擬金鑰 - 預算
| 指標名稱 | 說明 |
|---|---|
litellm_api_key_max_budget_metric | API 金鑰的最大預算 標籤:"hashed_api_key", "api_key_alias" |
litellm_remaining_api_key_budget_metric | API 金鑰剩餘預算(在 LiteLLM 上建立的金鑰)標籤:"hashed_api_key", "api_key_alias" |
litellm_api_key_budget_remaining_hours_metric | API 金鑰預算重設前的剩餘小時數 標籤:"hashed_api_key", "api_key_alias" |
內部使用者 - 預算
僅對附加到內部使用者的請求發出;最大預算與重設小時數儀表也另外要求該使用者已設定預算。請使用 在啟動時初始化預算指標 以便依排程為所有使用者發出這些指標。
| 指標名稱 | 說明 |
|---|---|
litellm_remaining_user_budget_metric | 內部使用者剩餘預算 標籤:"user" |
litellm_user_max_budget_metric | 內部使用者最大預算 標籤:"user" |
litellm_user_budget_remaining_hours_metric | 內部使用者預算重設前的小時數 標籤:"user" |
組織 - 預算
僅對附加到組織的請求發出,條件與上述內部使用者指標相同。
| 指標名稱 | 說明 |
|---|---|
litellm_remaining_org_budget_metric | 組織剩餘預算 標籤:"org_id", "org_alias" |
litellm_org_max_budget_metric | 組織最大預算 標籤:"org_id", "org_alias" |
litellm_org_budget_remaining_hours_metric | 組織預算重設前的小時數 標籤:"org_id", "org_alias" |
客戶(end_user)- 預算
僅在啟用 end_user tracking 時發出。每次請求時,會根據授權期間快取的 customer row 重新整理該請求客戶的剩餘與最大預算儀表(不會額外查詢資料庫;若快取未命中,則交由週期性重新整理處理);重設小時數儀表,以及沒有近期流量的客戶,則由 在啟動時初始化預算指標 涵蓋,該功能會為每個已附加預算的客戶發出這三個儀表。當設定 max_end_user_budget_id 時,沒有自己預算的客戶會以該預設預算發出。這些序列會受到 在 Prometheus 上追蹤 end_user 中所述的 end_user 基數上限限制。
| 指標名稱 | 說明 |
|---|---|
litellm_remaining_customer_budget_metric | 客戶剩餘預算 標籤:"end_user" |
litellm_customer_max_budget_metric | 客戶最大預算 標籤:"end_user" |
litellm_customer_budget_remaining_hours_metric | 客戶預算重設前的小時數 標籤:"end_user" |
虛擬金鑰 - 速率限制
| 指標名稱 | 說明 |
|---|---|
litellm_remaining_api_key_requests_for_model | LiteLLM 虛擬 API 金鑰的剩餘請求數,僅在該虛擬金鑰已設定模型特定速率限制(rpm)時才會顯示。標籤:"hashed_api_key", "api_key_alias", "model", "model_id" |
litellm_remaining_api_key_tokens_for_model | LiteLLM 虛擬 API 金鑰的剩餘 token 數,僅在該虛擬金鑰已設定模型特定 token 限制(tpm)時才會顯示。標籤:"hashed_api_key", "api_key_alias", "model", "model_id" |
啟動時初始化預算指標
如果您希望 litellm 無論是否收到請求,都為所有金鑰與團隊發出預算指標,請在 prometheus_initialize_budget_metrics 中將 true 設為 config.yaml
運作方式:
- 如果
prometheus_initialize_budget_metrics設為true- 每 5 分鐘,litellm 會執行 cron job,從資料庫讀取所有 keys、teams、internal users 和 organizations
- 接著為每一個項目發出預算指標
- 這用於在
/metrics端點填入預算指標
litellm_settings:
  callbacks: ["prometheus"]
  prometheus_initialize_budget_metrics: true
Pod 健康指標
用這些指標來衡量每個 pod 的佇列深度,並診斷在 LiteLLM 開始處理請求之前 發生的延遲。
| 指標名稱 | 類型 | 說明 |
|---|---|---|
litellm_in_flight_requests | Gauge | 此 uvicorn worker 目前處理中的 HTTP 請求數量。即時追蹤 pod 的佇列深度。若有多個 worker,數值會在所有存活的 worker 之間加總(livesum)。 |
litellm_admission_admitted_requests | Gauge | 目前持有每個 worker 的 admission slot 的請求。僅在啟用 per-worker admission control 時填入。會在所有存活的 worker 之間加總(livesum)。 |
litellm_admission_queued_requests | Gauge | 正在等待每個 worker 的 admission slot 的請求。會在所有存活的 worker 之間加總(livesum)。 |
litellm_admission_rejected_requests_total | Counter | 被 admission control 拒絕並帶有 503 的請求,依 reason 標記:queue_full(佇列在到達時已達上限)或 queue_timeout(等待 admission_queue_timeout_seconds 仍未取得 slot)。 |
何時使用這個指標
LiteLLM 會從處理程序開始時測量延遲。如果請求在 handler 執行前先在 uvicorn 的 event loop 中等待,這段等待對 LiteLLM 自身的記錄是不可見的。litellm_in_flight_requests 顯示某個 pod 在任一時間點的負載情況。
high in_flight_requests + high ALB TargetResponseTime → pod overloaded, scale out
low  in_flight_requests + high ALB TargetResponseTime → delay is pre-ASGI (event loop blocking)
您也可以直接查看目前的值,而不必使用 Prometheus:
curl http://localhost:4000/health/backlog \
  -H "Authorization: Bearer sk-..."
# {"in_flight_requests": 47}
Proxy 層級追蹤指標
用這些指標來追蹤整體 LiteLLM Proxy 的使用情況。
- 追蹤傳送到 proxy 的實際流量速率
- 針對送往 proxy 的請求,統計用戶端請求與失敗數量
| 指標名稱 | 說明 |
|---|---|
litellm_proxy_failed_requests_metric | proxy 回應失敗的總數 - 用戶端未從 litellm proxy 取得成功回應。標籤:"end_user", "hashed_api_key", "api_key_alias", "requested_model", "team", "team_alias", "user", "user_email", "exception_status", "exception_class", "route", "client_ip", "user_agent", "model_id", "api_provider" |
litellm_proxy_total_requests_metric | 傳送至 proxy server 的請求總數 - 追蹤用戶端請求數量。標籤:"end_user", "hashed_api_key", "api_key_alias", "requested_model", "team", "team_alias", "user", "status_code", "user_email", "route", "client_ip", "user_agent", "model_id", "api_provider"。可選地包含 "stream" — 請參閱 發出 Stream 標籤。 |
回呼記錄指標
監控將記錄傳送到下游回呼(例如 S3 cold storage)時的失敗情況
| 指標名稱 | 描述 |
|---|---|
litellm_callback_logging_failures_metric | 傳送記錄到已設定回呼失敗的總次數。標籤:"callback_name"。可用於針對回呼傳遞問題發出警示,例如寫入 S3、langfuse 或 langfuse_otel 及其他 otel 提供者時反覆失敗 |
支援的回呼:
S3Logger- S3 冷儲存失敗langfuse- Langfuse 記錄失敗otel- OpenTelemetry 記錄失敗
防護欄指標
僅在 guardrails 執行時發出。
| 指標名稱 | 描述 |
|---|---|
litellm_guardrail_requests_total | 防護欄呼叫總次數。標籤:"guardrail_name", "status", "hook_type" |
litellm_guardrail_errors_total | 防護欄執行期間遇到的錯誤總次數。標籤:"guardrail_name", "error_type", "hook_type" |
litellm_guardrail_latency_seconds | 防護欄執行延遲(秒)的直方圖。標籤:"guardrail_name", "status", "error_type", "hook_type" |
MCP 閘道指標
僅針對透過 MCP gateway 進行的 MCP 工具呼叫發出。兩個指標都帶有標籤 "mcp_tool_name", "mcp_server_name", "hashed_api_key", "api_key_alias", "team", "team_alias", "user", "end_user"。
| 指標名稱 | 描述 |
|---|---|
litellm_mcp_tool_calls_total | MCP 工具呼叫總次數,依工具與伺服器名稱細分 |
litellm_mcp_tool_call_spend_metric | MCP 工具呼叫的總花費;僅在呼叫具有非零成本時才會遞增 |
受管理批次指標
僅限企業版。當使用 LiteLLM managed batches 以及負責追蹤其成本的 CheckBatchCost 背景工作時發出。
| 指標名稱 | 描述 |
|---|---|
litellm_managed_batch_created_total | 建立的受管理批次總數。標籤:"model", "api_provider", "user", "user_email", "api_key_alias" |
litellm_managed_file_created_total | 建立的受管理檔案總數。標籤:"model", "api_provider", "user", "user_email", "api_key_alias" |
litellm_managed_file_deleted_total | 受管理檔案刪除總數,包含成功或被封鎖。標籤:"result" |
litellm_managed_file_size_bytes | 最新受管理批次檔案的大小(位元組),每個標籤組合的最後一次觀測值。標籤:"purpose", "file_type", "model", "api_provider", "user" |
litellm_managed_batch_duration_seconds | 已完成批次持續時間(秒)的直方圖(completed_at - created_at)。標籤:"model", "api_provider" |
litellm_check_batch_cost_jobs_polled | 上一次 CheckBatchCost 輪詢找到的未處理批次數量 |
litellm_check_batch_cost_jobs_processed_total | CheckBatchCost 成功追蹤成本的批次總數。標籤:"model", "api_provider" |
litellm_check_batch_cost_errors_total | CheckBatchCost 中依錯誤類型區分的錯誤總數。標籤:"error_type" |
litellm_check_batch_cost_last_run_timestamp | 上一次 CheckBatchCost 工作執行的 Unix 時間戳記 |
LLM 提供者指標
用於 LLM API 錯誤監控,以及追蹤剩餘的 rate limit 與 token limit
追蹤的標籤
| 標籤 | 說明 |
|---|---|
| litellm_model_name | LiteLLM 使用的 LLM 模型名稱 |
| requested_model | 請求中送出的模型 |
| model_id | 部署的 model_id。由 LiteLLM 自動產生,每個部署都有唯一的 model_id |
| api_base | 部署的 API Base |
| api_provider | LLM API provider,用於提供者。範例(azure、openai、vertex_ai) |
| hashed_api_key | 請求的雜湊後 API 金鑰 |
| api_key_alias | 使用的 API 金鑰別名 |
| team | 請求的團隊 |
| team_alias | 使用的團隊別名 |
| exception_status | 例外狀態(如果有) |
| exception_class | 例外類別(如果有) |
成功與失敗
| 指標名稱 | 說明 |
|---|---|
litellm_deployment_success_responses | 部署成功的 LLM API 呼叫總次數。標籤:"requested_model", "litellm_model_name", "model_id", "api_base", "api_provider", "hashed_api_key", "api_key_alias", "team", "team_alias", "client_ip", "user_agent" |
litellm_deployment_failure_responses | 特定 LLM 部署失敗的 LLM API 呼叫總次數。標籤:"requested_model", "litellm_model_name", "model_id", "api_base", "api_provider", "exception_status", "exception_class", "hashed_api_key", "api_key_alias", "team", "team_alias", "client_ip", "user_agent" |
litellm_deployment_total_requests | 部署的 LLM API 呼叫總次數-成功 + 失敗。標籤:"requested_model", "litellm_model_name", "model_id", "api_base", "api_provider", "hashed_api_key", "api_key_alias", "team", "team_alias", "client_ip", "user_agent" |
剩餘請求與 token
| 指標名稱 | 說明 |
|---|---|
litellm_remaining_requests_metric | 追蹤 LLM API Deployment 回傳的 x-ratelimit-remaining-requests。標籤:"model_group", "api_provider", "api_base", "litellm_model_name", "hashed_api_key", "api_key_alias", "model_id" |
litellm_remaining_tokens_metric | 追蹤 LLM API Deployment 回傳的 x-ratelimit-remaining-tokens。標籤:"model_group", "api_provider", "api_base", "litellm_model_name", "hashed_api_key", "api_key_alias", "model_id" |
提供者預算
| 指標名稱 | 描述 |
|---|---|
litellm_provider_remaining_budget_metric | LLM 提供者的剩餘預算;僅在設定了 provider budget routing 時發出。標籤:"api_provider" |
花費擷取率
| 指標名稱 | 描述 |
|---|---|
litellm_spend_capture_rate | LiteLLM 擷取為花費的提供者帳單占比,計算範圍為 scheduled capture-rate check 的視窗(已擷取花費 / 提供者帳單)。當最後一次檢查未產生速率時,以及在已配置資料庫但未設定該檢查的每個 proxy 上,NaN。標籤:"api_provider" |
部署狀態
| 指標名稱 | 描述 |
|---|---|
litellm_deployment_state | 部署的狀態:0 = 健康,1 = 部分中斷,2 = 完全中斷。標籤:"litellm_model_name", "model_id", "api_base", "api_provider" |
litellm_deployment_latency_per_output_token | 部署每個輸出 token 的延遲。標籤:"litellm_model_name", "model_id", "api_base", "api_provider", "hashed_api_key", "api_key_alias", "team", "team_alias" |
litellm_deployment_tpm_limit | 部署設定的 TPM 限制;僅對設定中具有 tpm 限制的部署設定。標籤:"litellm_model_name", "model_id", "api_base", "api_provider" |
litellm_deployment_rpm_limit | 部署設定的 RPM 限制;僅對設定中具有 rpm 限制的部署設定。標籤:"litellm_model_name", "model_id", "api_base", "api_provider" |
備援(故障轉移)指標
| 指標名稱 | 說明 |
|---|---|
litellm_deployment_cooled_down | LiteLLM 負載平衡邏輯將某個部署降溫的次數。標籤:"litellm_model_name", "model_id", "api_base", "api_provider", "exception_status" |
litellm_deployment_successful_fallbacks | 從主要模型 -> 備援模型的備援請求成功次數。標籤:"requested_model", "fallback_model", "hashed_api_key", "api_key_alias", "team", "team_alias", "exception_status", "exception_class", "model_id" |
litellm_deployment_failed_fallbacks | 從主要模型 -> 備援模型的備援請求失敗次數。標籤:"requested_model", "fallback_model", "hashed_api_key", "api_key_alias", "team", "team_alias", "exception_status", "exception_class", "model_id" |
請求計數指標
| 指標名稱 | 描述 |
|---|---|
litellm_requests_metric | 已淘汰,請改用 litellm_proxy_total_requests_metric。對 litellm 的 LLM 呼叫總數,依 API 金鑰、團隊、使用者追蹤。標籤:"end_user", "hashed_api_key", "api_key_alias", "model", "team", "team_alias", "user", "user_email", "client_ip", "user_agent", "requested_model", "model_id", "api_provider" |
litellm_zero_cost_requests_total | 帶有使用量但在 $0 記錄的請求,且該模型的定價項目具有非零費率。免費模型與沒有使用量的請求不計入。標籤:"requested_model", "model", "model_id", "api_provider", "reason",其中 reason 為 missing_pricing_key、pricing_not_applied 或 cost_calculation_error。每個被計入的請求也會記錄一則警告,指出缺少的定價鍵,請參閱 價格為 $0 的請求 |
請求延遲指標
請將 litellm_request_total_latency_metric 用於延遲 SLO 與警示。它衡量的是從請求到達 proxy 到處理結束的完整請求。如果總延遲增加,請使用其他指標來判斷延遲來源是驗證、LLM 提供者,還是 LiteLLM 處理。
所有請求延遲指標都是以秒為單位測量的 Prometheus 直方圖。
| 您要測量的內容 | 指標 | 測量區間 |
|---|---|---|
| 端到端延遲 | litellm_request_total_latency_metric | 從請求到達到處理結束。包含驗證、呼叫前回呼、LLM API 呼叫,以及呼叫後處理。 |
| 驗證與請求等待時間 | litellm_request_queue_time_seconds | 從請求到達到呼叫前處理開始。包含驗證與 ASGI 層級排隊。診斷過載的 proxy pod 時,請將此與 litellm_in_flight_requests 比較。 |
| LLM 提供者延遲 | litellm_llm_api_latency_metric | LLM API 呼叫開始到結束。 |
| 首個 token 時間 | litellm_llm_api_time_to_first_token_metric | LLM API 呼叫開始到第一個 token。僅針對串流請求發出。 |
| LiteLLM 處理額外負擔 | litellm_overhead_latency_metric | LiteLLM 處理時間,不含 LLM API 呼叫與防護欄。 |
| LiteLLM 處理與防護欄額外負擔 | litellm_overhead_with_guardrails_latency_metric | LiteLLM 處理時間加上呼叫前與呼叫後防護欄,不含 LLM API 呼叫。呼叫中防護欄會與 LLM API 呼叫並行執行,不包含在內。 |
例如,這個查詢會回傳最近五分鐘的端到端 p95 延遲:
histogram_quantile(0.95, sum by (le) (rate(litellm_request_total_latency_metric_bucket[5m])))
請求延遲指標的標籤
| 指標 | 標籤 |
|---|---|
litellm_request_total_latency_metriclitellm_llm_api_latency_metriclitellm_llm_api_time_to_first_token_metric | end_user, hashed_api_key, api_key_alias, requested_model, team, team_alias, user, model, model_id, api_provider, service_tier |
litellm_request_queue_time_seconds | end_user, hashed_api_key, api_key_alias, requested_model, team, team_alias, user, model, model_id, api_provider |
litellm_overhead_latency_metriclitellm_overhead_with_guardrails_latency_metric | model_group, api_provider, api_base, litellm_model_name, hashed_api_key, api_key_alias, model_id |
litellm_request_queue_time_seconds 不包含 service_tier,因為在記錄此指標時,提供者尚未選擇服務等級。
請在部署與延遲指標上設定呼叫者身分
預設情況下,部署計數器與以呼叫者為範圍的延遲直方圖會使用 api_key_alias 識別呼叫者。將 prometheus_deployment_and_latency_caller_identity 設為改用 user_email,或同時公開兩個標籤:
litellm_settings:
  callbacks: ["prometheus"]
  prometheus_deployment_and_latency_caller_identity: user_email
| 值 | 呼叫者身分標籤 | 行為 |
|---|---|---|
api_key_alias(預設) | api_key_alias | 保留既有的指標結構與既有查詢。 |
user_email | user_email | 以相同位置的 api_key_alias 取代之。 |
both | api_key_alias,接著 user_email | 同時發出兩個維度。user_email 會緊接在 api_key_alias 之後。 |
此設定只適用於以下指標系列:
litellm_deployment_total_requestslitellm_deployment_success_responseslitellm_deployment_failure_responseslitellm_request_total_latency_metriclitellm_llm_api_latency_metriclitellm_llm_api_time_to_first_token_metriclitellm_request_queue_time_secondslitellm_overhead_latency_metriclitellm_deployment_latency_per_output_token
它不會變更與呼叫者無範圍關聯的相關指標,或包含防護欄的 litellm_overhead_with_guardrails_latency_metric。計數器取樣會使用 Prometheus 的 _total 後綴,而直方圖的 _bucket、_sum 與 _count 取樣都會套用所選的身分標籤。
沒有已解析電子郵件的請求會使用 LiteLLM 既有的 "None" 標籤值。範例來說,以下查詢會依已解析電子郵件彙總提供者請求與 p95 端到端延遲,同時排除沒有電子郵件的請求:
sum by (user_email) (
  rate(litellm_deployment_total_requests_total{user_email!="None"}[5m])
)
histogram_quantile(
  0.95,
  sum by (user_email, le) (
    rate(litellm_request_total_latency_metric_bucket{user_email!="None"}[5m])
  )
)
prometheus_metrics_config.include_labels 會根據所選模式進行驗證。在 api_key_alias 模式中,它可以包含 api_key_alias;在 user_email 模式中,它可以包含 user_email;而在 both 模式中,它可以包含兩者之一或同時包含兩者。無效的模式值會使 Proxy 啟動失敗,並出現一則名為接受值的 ValueError,而 user_email 模式搭配受影響系列上的 include_labels: [api_key_alias] 也會使啟動失敗,並列出這兩個設定。prometheus_exclude_labels 會在之後套用,且可以移除任一身分標籤。範例來說,若全域選擇 both 並排除 api_key_alias,則受影響系列上只會剩下 user_email。
變更此設定會變更固定的 Prometheus 收集器標籤結構。變更後請重新啟動每個 LiteLLM Proxy/logger 行程;即時設定重新載入無法重建既有的收集器。
電子郵件地址屬於敏感資料。除非需要以電子郵件層級歸因,否則請保留預設值,維持 在 /metrics 上的驗證,並將網路存取限制為受信任的 Prometheus 擷取器。
both 會針對每個觀測到的完整標籤元組記錄一條系列;它不會為同一個請求建立第二條系列。如果別名與電子郵件之間具有穩定的一對一對應,新增電子郵件標籤不會增加不同系列的數量。當別名被多位使用者重複使用、對應關係隨時間變更,或同一別名同時觀測到已解析與未提供電子郵件時,基數可能會增加。
依服務等級切分延遲與支出
請求延遲指標與 litellm_spend_metric 上的 service_tier 標籤,會帶有請求實際執行的等級,因此您可以在將流量移轉到較便宜或較快的等級前後,比較延遲與成本:
histogram_quantile(0.95, sum by (service_tier, le) (rate(litellm_request_total_latency_metric_bucket[5m])))
其值是提供者回報其所服務的等級,這就是為什麼帶有 "service_tier": "auto" 的請求,會顯示在提供者所選的具體等級下(例如 default),而不是顯示在 auto 下。當提供者未回報等級時,會使用請求中指定的等級;而既未要求也未取得等級的請求,則會以空值標示
在 Prometheus 上追蹤 end_user
預設情況下,LiteLLM 不會在 Prometheus 上追蹤 end_user。這樣做是為了降低 LiteLLM Proxy 指標的基數。
如果您想在 Prometheus 上追蹤 end_user,可以執行以下操作:
litellm_settings:
  callbacks: ["prometheus"]
  enable_end_user_cost_tracking_prometheus_only: true
任何帶有 end_user 標籤的指標,包括 客戶預算儀表,每個指標都會受到 prometheus_end_user_metrics_max_series_per_metric 的上限限制(預設 10000,最舊的系列會先被捨棄),而閒置超過 prometheus_end_user_metrics_ttl_seconds 的系列(預設 3600)會被移除。將任一值設為 null 即可停用該限制。
litellm_settings:
  callbacks: ["prometheus"]
  enable_end_user_cost_tracking_prometheus_only: true
  prometheus_end_user_metrics_max_series_per_metric: 500
  prometheus_end_user_metrics_ttl_seconds: 1800
發出串流標籤
將 stream 標籤加到 litellm_proxy_total_requests_metric,以依串流與非串流來區分請求。預設停用。
litellm_settings:
  callbacks: ["prometheus"]
  prometheus_emit_stream_label: true
啟用後,litellm_proxy_total_requests_metric 會新增一個 stream 標籤,值為 "True"、"False" 或 "None"。
litellm_proxy_total_requests_metric{..., stream="True"} 42
litellm_proxy_total_requests_metric{..., stream="False"} 100
此標籤採 opt-in,因為在既有指標上新增一個新標籤會改變其基數,並破壞以此指標為目標的現有 Prometheus 查詢 / Grafana 儀表板。僅在全新部署上啟用,或在您準備好更新儀表板時再啟用。
[BETA] 自訂指標
在 prometheus 上追蹤上述所有事件的自訂指標。
自訂中繼資料標籤
- 在
config.yaml中定義自訂中繼資料標籤
model_list:
  - model_name: openai/gpt-5.6-terra
    litellm_params:
      model: openai/gpt-5.6-terra
      api_key: os.environ/OPENAI_API_KEY

litellm_settings:
  callbacks: ["prometheus"]
  custom_prometheus_metadata_labels: ["metadata.foo", "metadata.bar"]
- 使用自訂中繼資料標籤發出請求
- Curl Request
- on Key
- on Team
curl -L -X POST 'http://0.0.0.0:4000/v1/chat/completions' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer <LITELLM_API_KEY>' \
-d '{
    "model": "openai/gpt-5.6-terra",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "What's in this image?"
          }
        ]
      }
    ],
    "max_tokens": 300,
    "metadata": {
        "foo": "hello world"
    }
}'
curl -L -X POST 'http://0.0.0.0:4000/key/generate' \
-H "Authorization: Bearer $LITELLM_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "metadata": {
        "foo": "hello world"
    }
}'
curl -L -X POST 'http://0.0.0.0:4000/team/new' \
-H "Authorization: Bearer $LITELLM_API_KEY" \
-H 'Content-Type: application/json' \
-d '{
    "metadata": {
        "foo": "hello world"
    }
}'
- 檢查您的
/metrics端點以查看自訂指標
... "metadata_foo": "hello world" ...
自訂標籤
將特定標籤追蹤為 prometheus 標籤,以便更好地篩選與監控。
- 在
config.yaml中定義自訂標籤
model_list:
  - model_name: openai/gpt-5.6-terra
    litellm_params:
      model: openai/gpt-5.6-terra
      api_key: os.environ/OPENAI_API_KEY

litellm_settings:
  callbacks: ["prometheus"]
  custom_prometheus_metadata_labels: ["metadata.foo", "metadata.bar"]
  custom_prometheus_tags:
    - "prod"
    - "staging"
    - "batch-job"
    - "User-Agent: RooCode/*"
    - "User-Agent: claude-cli/*"
- 使用標籤發出請求
curl -L -X POST 'http://0.0.0.0:4000/v1/chat/completions' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer <LITELLM_API_KEY>' \
-d '{
    "model": "openai/gpt-5.6-terra",
    "messages": [
      {
        "role": "user",
        "content": [
          {
            "type": "text",
            "text": "What's in this image?"
          }
        ]
      }
    ],
    "max_tokens": 300,
    "metadata": {
        "tags": ["prod", "user-facing"]
    }
}'
- 檢查您的
/metrics端點以查看自訂標籤指標
... "tag_prod": "true", "tag_staging": "false", "tag_batch_job": "false" ...
自訂標籤的運作方式:
- 每個已設定的標籤在 prometheus 指標中都會成為一個布林標籤
- 如果標籤符合(完全相符或萬用字元),標籤值為
"true",否則為"false" - 標籤名稱會經過清理以符合 prometheus 相容性(例如,
"batch-job"會變成"tag_batch_job") - 支援使用
*的萬用字元模式(例如,"User-Agent: RooCode/*"可匹配"User-Agent: RooCode/1.0.0")
含萬用字元的範例:
litellm_settings:
  callbacks: ["prometheus"]
  custom_prometheus_tags:
    - "User-Agent: RooCode/*"
    - "User-Agent: claude-cli/*"
使用案例:
- 環境追蹤 (
prod,staging,dev) - 請求類型分類 (
batch-job,user-facing,background) - 功能旗標 (
new-feature,beta-users) - 團隊或服務識別 (
team-a,service-xyz) - User-Agent 追蹤 - 使用此項來追蹤 Roo Code、Claude Code、Gemini CLI 的使用量 (
User-Agent: RooCode/*,User-Agent: claude-cli/*,User-Agent: gemini-cli/*)
設定指標與標籤
您可以選擇性地啟用特定指標並控制要包含哪些標籤,以最佳化效能並降低基數。
啟用特定指標與標籤
透過在 prometheus_metrics_config 中指定它們來設定要發出的指標。每個設定群組都需要一個 group 名稱(用於組織)以及一個要啟用的 metrics 清單。您也可以選擇性地包含一個 include_labels 清單,以篩選這些指標的標籤。
model_list:
  - model_name: gpt-5.6-terra
    litellm_params:
      model: gpt-5.6-terra

litellm_settings:
  callbacks: ["prometheus"]
  prometheus_metrics_config:
    # High-cardinality metrics with minimal labels
    - group: "proxy_metrics"
      metrics:
        - "litellm_proxy_total_requests_metric"
        - "litellm_proxy_failed_requests_metric"
      include_labels:
        - "hashed_api_key"
        - "requested_model"
        - "model_group"
啟動 LiteLLM 時,如果您的指標已正確設定,您應該會在容器記錄中看到以下內容
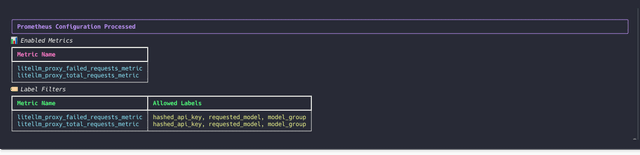
依每個指標篩選標籤
控制每個指標要包含哪些標籤,以降低基數:
litellm_settings:
  callbacks: ["prometheus"]
  prometheus_metrics_config:
    - group: "token_consumption"
      metrics:
        - "litellm_input_tokens_metric"
        - "litellm_output_tokens_metric"
        - "litellm_total_tokens_metric"
      include_labels:
        - "model"
        - "team"
        - "hashed_api_key"
    - group: "request_tracking"
      metrics:
        - "litellm_proxy_total_requests_metric"
      include_labels:
        - "status_code"
        - "requested_model"
進階設定
您可以建立多個具有不同標籤集合的設定群組:
litellm_settings:
  callbacks: ["prometheus"]
  prometheus_metrics_config:
    # High-cardinality metrics with minimal labels
    - group: "deployment_health"
      metrics:
        - "litellm_deployment_success_responses"
        - "litellm_deployment_failure_responses"
      include_labels:
        - "api_provider"
        - "requested_model"

    # Budget metrics with full label set
    - group: "budget_tracking"
      metrics:
        - "litellm_remaining_team_budget_metric"
      include_labels:
        - "team"
        - "team_alias"
        - "hashed_api_key"
        - "api_key_alias"
        - "model"
        - "end_user"

    # Latency metrics with performance-focused labels
    - group: "performance"
      metrics:
        - "litellm_request_total_latency_metric"
        - "litellm_llm_api_latency_metric"
      include_labels:
        - "model"
        - "api_provider"
        - "requested_model"
設定結構:
group:用於組織相關指標的描述性名稱metrics:要包含在此群組中的指標名稱清單include_labels: (選用)要為這些指標包含的標籤清單
預設行為:如果未指定 prometheus_metrics_config,則所有指標都會以其預設標籤啟用(向後相容)。
全域排除指標與標籤
prometheus_metrics_config 採用包含式,因此需要列舉您要保留的每個指標。當您只想移除少數幾個指標或標籤時,請改用全域 prometheus_exclude_metrics 與 prometheus_exclude_labels 選項。未列出的項目都會以預設標籤維持啟用,而未來 LiteLLM 版本新增的指標會自動發出,不需要額外的設定變更。
litellm_settings:
  callbacks: ["prometheus"]
  # Drop these metrics entirely
  prometheus_exclude_metrics:
    - "litellm_input_tokens_metric"
    - "litellm_output_tokens_metric"
  # Drop these labels from every metric that would otherwise emit them
  prometheus_exclude_labels:
    - "hashed_api_key"
    - "api_key_alias"
這兩個清單都會在啟動時驗證;未知的指標或標籤名稱會引發設定錯誤,因此拼字錯誤會立即浮現。排除設定永遠優先,因此在 prometheus_exclude_metrics 中指定的指標即使被某個 prometheus_metrics_config 群組啟用也會被捨棄,而在 prometheus_exclude_labels 中的標籤,即使某個群組的 include_labels 將其列出,也會被移除。
限制每個指標的系列數
每一組指標曾見過的不同標籤組合都會一直留在 Proxy 的記憶體中,直到行程重新啟動,因此像 user、user_email、hashed_api_key、api_key_alias、client_ip 與 user_agent 之類的標籤,會隨著每一位新呼叫者而增加指標狀態。先移除您不查詢的標籤是首要手段(如上所述)。當某個標籤必須保留時,設定 prometheus_metrics_max_series_per_metric 以限制每個指標可保留的系列數。此設定預設關閉,並適用於 prometheus 回呼發出的所有帶標籤指標
litellm_settings:
  callbacks: ["prometheus"]
  prometheus_metrics_max_series_per_metric: 5000
指標看到的前 5000 種標籤組合,會各自保留一條系列。對於計數器或直方圖,之後的每一種組合都會記錄到另一條額外系列上,而其標籤全為 other,因此對該指標的總和仍然精確,只有溢出部分的逐標籤細分會遺失。量測值會跳過超過上限的組合,因為由許多呼叫者共用的一個量測值毫無意義。若某個值不是大於 0 的數字,則會被忽略:Proxy 會在啟動時記錄一則警告,說明設定與其值,並在沒有上限的情況下發出指標
此上限以每個 Proxy 執行個體計算。對於多個 worker,同一個執行個體的 worker 會透過 PROMETHEUS_MULTIPROC_DIR 中每個指標的一個小檔案,就 5000 組合保留系列達成一致,因此合併 worker 的擷取仍會顯示該上限以及 other 系列,而被替換的 worker,例如由 --max_requests_before_restart 取代時,會保留相同的組合。跨執行個體之間不會共享上限,因此一旦某個執行個體達到其上限,它所保留的某個組合可能會在另一個執行個體上成為 other,而對該單一系列的全叢集加總只會計算保留它的執行個體。多個 worker 時,量測值是例外,因為每個 worker 都會以自己的 pid 標籤匯出量測值,因此每個 worker 的量測值可達到上限
若要釋放已離開的呼叫者所持有的名額,也請設定 prometheus_metrics_ttl_seconds。超過該秒數未更新的系列會被移除,最多每 prometheus_metrics_cleanup_interval_seconds 檢查一次(預設 60),其名額會讓給下一個新的標籤組合。已移除的系列會從 /metrics 中消失,直到再次發出為止;屆時其計數會從零重新開始,而 PromQL rate() 與 increase() 會將其視為計數器重設。若 TTL 不是大於 0 的數字,則會以相同的啟動警告忽略;若清理間隔不是至少 0 的數字,則也會以相同的警告忽略,而檢查仍會維持預設的 60 秒
litellm_settings:
  callbacks: ["prometheus"]
  prometheus_metrics_max_series_per_metric: 5000
  prometheus_metrics_ttl_seconds: 3600
TTL 僅在單一程序模式下有效。當設定 PROMETHEUS_MULTIPROC_DIR(多個 worker 或 專用指標埠)時,Prometheus 用戶端程式庫無法移除它已寫入的 series,因此 LiteLLM 會在那裡忽略 prometheus_metrics_ttl_seconds,並在啟動時記錄警告。在該模式下,上限仍然有效,而槽位會在代理程式重新啟動時釋放,因為只要設定了 litellm,PROMETHEUS_MULTIPROC_DIR 也會在開機時清除此目錄,即使只有一個 worker 也是如此,因此已結束 worker 的樣本不會讓合併後的 scrape 超過上限。如果您不是透過 litellm 啟動 workers,請在它們啟動前清空 PROMETHEUS_MULTIPROC_DIR
在 Prometheus 上追蹤 end_user 中的 end_user 上限是獨立的設定,且仍然適用於帶有 end_user 標籤的指標
監控系統健康狀態
若要監控 litellm 相鄰服務(redis / postgres)的健康狀態,請執行:
model_list:
  - model_name: gpt-5.6-terra
    litellm_params:
      model: gpt-5.6-terra
litellm_settings:
  service_callback: ["prometheus_system"]
每個受監控的服務會發出三個指標,名稱為 litellm_<service>_<type>:
| Metric Name | Type | Description |
|---|---|---|
litellm_<service>_latency | Histogram | 對服務呼叫的延遲(秒) |
litellm_<service>_failed_requests_total | Counter | 對服務失敗呼叫的數量。標籤:"error_class", "function_name",用於除錯失敗原因 |
litellm_<service>_total_requests_total | Counter | 對服務呼叫的總數,與失敗 counter 搭配使用可計算錯誤率 |
受監控的服務如下:
| Service | Description |
|---|---|
redis | Redis 呼叫(快取、速率限制狀態) |
postgres | Postgres DB 呼叫(keys、teams、spend logs)。範例:litellm_postgres_latency、litellm_postgres_failed_requests_total、litellm_postgres_total_requests_total |
auth | 請求驗證檢查。適合用來抓出因 DB 負載過高而造成的驗證緩慢 |
batch_write_to_db | 批次寫入 DB 的 spend/usage |
reset_budget_job | 週期性的預算重設工作 |
router | LiteLLM 路由操作 |
proxy_pre_call | 代理程式在呼叫 LLM API 之前執行的 pre-call hooks |
self | LiteLLM 自己的 API 呼叫處理 |
範例警示:DB 發生故障或變慢:
rate(litellm_postgres_failed_requests_total[5m]) > 0
histogram_quantile(0.95, sum by (le) (rate(litellm_postgres_latency_bucket[5m]))) > 1
DB Transaction Queue 健康指標
使用這些指標來監控 DB Transaction Queue 的健康狀態。例如:監控記憶體內與 redis 緩衝區的大小。
| Metric Name | Description | Storage Type |
|---|---|---|
litellm_pod_lock_manager_size | 表示哪個 pod 持有寫入更新到資料庫的鎖定。 | Redis |
litellm_in_memory_daily_spend_update_queue_size | 記憶體中的每日 spend 更新佇列項目數量。這些是每個使用者的彙總 spend logs。 | In-Memory |
litellm_redis_daily_spend_update_queue_size | Redis 中每日 spend 更新佇列項目數量。這些是每個使用者的彙總 spend logs。 | Redis |
litellm_redis_daily_end_user_spend_update_queue_size | Redis 中每日 end user spend 更新佇列項目數量。 | Redis |
litellm_redis_daily_agent_spend_update_queue_size | Redis 中每日 agent spend 更新佇列項目數量。 | Redis |
litellm_in_memory_spend_update_queue_size | keys、users、teams、team members 等的記憶體中彙總 spend 值。 | In-Memory |
litellm_redis_spend_update_queue_size | keys、users、teams 等的 Redis 彙總 spend 值。 | Redis |
🔥 LiteLLM 維護的 Grafana 儀表板
LiteLLM 為此頁上的 litellm_* 指標維護兩個 Grafana 儀表板,兩者都位於 cookbook/litellm_proxy_server/grafana_dashboard 資料夾中。請從 Dashboards > New > Import 匯入 JSON,並在提示時選取您的 Prometheus 資料來源
All Prometheus Metrics 儀表板 針對上方表格中的每個指標都有一個面板,並依主題分組:traffic、latency、spend and tokens、cache、deployments、rate limits、budgets、guardrails、MCP、managed files and batches、users and teams,以及 prometheus_system 服務指標和 DB transaction 佇列大小。您尚未啟用的功能之面板會保持空白;其 readme 列出每一列需要哪個設定
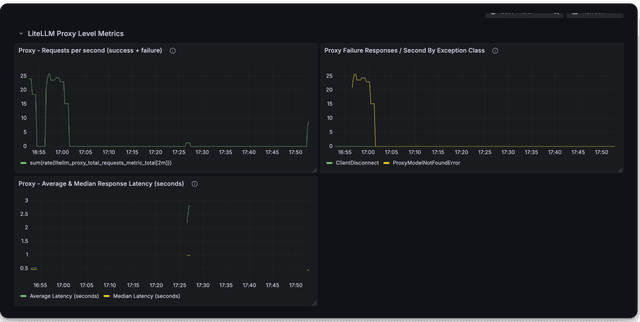
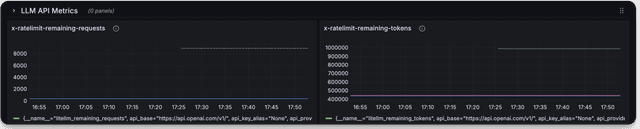
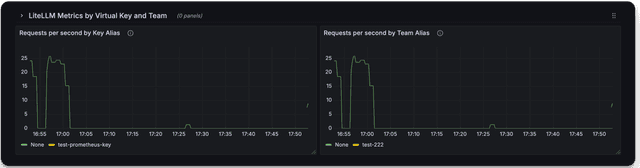
v2 儀表板 是請求速率、失敗、延遲,以及每個 model group 的剩餘請求與剩餘 token 儀表的精簡檢視,如下所示
已棄用的指標
| 指標名稱 | 說明 |
|---|---|
litellm_llm_api_failed_requests_metric | 已棄用 請改用 litellm_proxy_failed_requests_metric |
/metrics 端點上的驗證
預設情況下,/metrics 需要 LiteLLM API 金鑰驗證(自 v1.85.0 起)。
對於 Prometheus,請將 authorization 加入您的 scrape config:
scrape_configs:
  - job_name: 'litellm'
    authorization:
      type: Bearer
      credentials: <LITELLM_API_KEY>
    static_configs:
      - targets: ['localhost:4000']
若要允許未經驗證的存取:
litellm_settings:
  require_auth_for_metrics_endpoint: false
常見問題
_created 與 _total 指標有何不同?
Python Prometheus client 會在每個 counter 和 histogram 旁邊發出一個 _created 樣本。它保存的是該 series 建立時的 Unix 時間戳(通常是程序啟動時,或第一次看到該標籤組合時),而且它不會計算任何數值。
您應該在計數用途上使用 _total 指標

