Spend Logs 的最大保留期間
這會說明如何設定 spend logs 的最大保留期限。這有助於透過自動刪除舊記錄來管理資料庫大小。
保留與清理皆為開源。此頁上的每個設定都可在沒有企業授權的情況下運作,而且清理作業在執行前不會檢查授權狀態。
需求
- Postgres(用於日誌儲存)
- Redis (選用):僅在您執行多個 proxy 執行個體並希望啟用分散式鎖定時才需要
用法
設定
將以下內容加入您的 proxy_config.yaml 中的 general_settings:
general_settings:
  maximum_spend_logs_retention_period: "7d"  # Keep logs for 7 days

  # Optional: prune per-tag daily spend rollups older than this
  maximum_daily_tag_spend_retention_period: "90d"

  # Optional: set how frequently cleanup should run - default is daily
  maximum_spend_logs_retention_interval: "1d"  # Run cleanup daily

  # Optional: set exact time for cleanup (Cron syntax)
  maximum_spend_logs_cleanup_cron: "0 4 * * *" # Run at 04:00 AM daily

  # Optional: bound how much work a single run may do
  maximum_spend_logs_cleanup_batch_size: 1000   # Rows per DELETE statement
  maximum_spend_logs_cleanup_max_batches: 500   # DELETE statements per table per run
  maximum_spend_logs_cleanup_run_budget: "5m"   # Wall clock for the whole run
  maximum_spend_logs_cleanup_batch_timeout: "30s" # statement_timeout and lock_timeout per batch

litellm_settings:
  cache: true
  cache_params:
    type: redis
作業執行時機
清理作業只有在您要求時才會存在。當 maximum_spend_logs_retention_period、maximum_autorouter_session_retention_period、maximum_health_check_retention_period 或 maximum_daily_tag_spend_retention_period 之中任何一個被設定時,會在 proxy 啟動時註冊;否則不會。之後若透過 /config/update 設定其中之一,則會在下一次設定同步時註冊該作業,無需重新啟動。若未設定任何一項,無論 batch、budget 或 interval 設定如何,都不會刪除任何內容。
當設定了保留期間且未設定 maximum_spend_logs_cleanup_cron 時,排程是以間隔而非一天中的特定時間。該間隔來自 maximum_spend_logs_retention_interval,預設為 1d,並會額外加入最多 60 秒的隨機偏移,避免一整群 pod 在同一瞬間全部觸發。因此第一次執行大約會落在啟動後的一個間隔,而不是午夜,也不是開機時。若您希望作業固定在較安靜的時段執行,請設定 maximum_spend_logs_cleanup_cron。
會刪除什麼
一次執行會修剪這些資料表,各自依其保留設定所隱含的截止點進行:
| 資料表 | 時間欄位 | 保留設定 |
|---|---|---|
LiteLLM_SpendLogs | startTime | maximum_spend_logs_retention_period |
LiteLLM_SpendLogToolIndex | start_time | maximum_spend_logs_retention_period |
LiteLLM_AutoRouterSession | last_turn_at | maximum_autorouter_session_retention_period |
LiteLLM_HealthCheckTable | checked_at | maximum_health_check_retention_period |
LiteLLM_DailyTagSpend | date | maximum_daily_tag_spend_retention_period |
LiteLLM_SpendLogToolIndex 列是從 spend logs 衍生而來,因此其到期時間與其所指向的日誌列相同。Auto-router session rollups 有自己的保留設定與自己的截止點。只設定 maximum_autorouter_session_retention_period 就足以註冊該作業,在這種情況下 spend logs 會保持不變,而只會修剪 session rollups。
LiteLLM_DailyTagSpend 每個 tag、model 與日曆日各有一列,並支撐 Tag Usage 頁面。其 date 欄位是 YYYY-MM-DD 字串,因此截止點以日計:其日期嚴格早於保留期間回溯到的那一天的列會被刪除,而那個邊界日本身則會保留。若 maximum_daily_tag_spend_retention_period 未設定,該資料表就永遠不會被動到,這是既有行為。Tag 預算是根據終身計數器執行,且不受此修剪影響,但 Tag Usage 圖表將無法再顯示已刪除的日期。
設定選項
maximum_spend_logs_retention_period(必填)
記錄在刪除前應保留多久。支援的格式:
"7d"– 7 天"24h"– 24 小時"60m"– 60 分鐘"3600s"– 3600 秒
maximum_spend_logs_retention_interval(選填)
清理工作應多久執行一次。使用與上述相同的格式。若未設定,且只有在 maximum_spend_logs_retention_period 有設定時,清理將每 24 小時執行一次。
maximum_spend_logs_cleanup_cron(選填)
使用標準 cron 語法排程清理。這會優先於 maximum_spend_logs_retention_interval。
範例:
"0 4 * * *"– 每日早上 04:00 執行"0 0 * * sun"– 每週日午夜執行"*/30 * * * *"– 每 30 分鐘執行一次
請在 weekday 欄位使用星期名稱(sun、mon、...),不要使用數字。LiteLLM 使用 APScheduler 排程清理,而 APScheduler 的星期編號是 0=Monday 到 6=Sunday;標準 cron 則是 0=Sunday 到 6=Saturday。數字型 weekday 值不會在這兩種慣例之間自動轉換,因此 "0 0 * * 0" 會在 Monday 執行,而不是 Sunday。星期名稱在兩種慣例中意思相同,且行為永遠符合預期。
以下四個設定會限制單次執行可做多少工作。每一項也都有對應的環境變數,用來設定該設定的預設值。兩者不可互換:當兩者都存在時,會以 general_settings 鍵為準,且是逐鍵生效。任何 duration parser 拒絕的值,以及任何非正值,都會回退到預設值。
maximum_spend_logs_cleanup_batch_size(選填)
每個 DELETE 陳述式會刪除多少列。預設為 1000。環境預設值:SPEND_LOG_CLEANUP_BATCH_SIZE
maximum_spend_logs_cleanup_max_batches(選填)
作業每次、每個資料表會發出多少 DELETE 陳述式,精確就是那麼多,不會更多。預設為 500,因此在預設 batch 大小下,一次執行對每個被修剪的資料表最多會刪除 500,000 列。環境預設值:SPEND_LOG_RUN_LOOPS
maximum_spend_logs_cleanup_run_budget(選填)
整次執行的牆鐘時間預算,格式與保留期間相同。預設為 5m。此預算是涵蓋執行所觸及的所有資料表,而非逐一資料表分開計算,因此 spend logs 會先消耗它,剩餘的部分再供 tool index 與 session rollups 使用。當預算用盡時,執行會停在當下的位置,而剩餘積壓會等到下一個 tick。環境預設值:SPEND_LOG_CLEANUP_RUN_BUDGET_SECONDS,以秒表示
maximum_spend_logs_cleanup_batch_timeout(選填)
每一個作業所發出陳述式的 Postgres statement_timeout 與 lock_timeout。預設為 30s。無法在此視窗內完成,或無法取得鎖定的陳述式,會由資料庫取消,而不是在使用者流量排隊等待時一直持有鎖定。環境預設值:SPEND_LOG_CLEANUP_BATCH_TIMEOUT_SECONDS,以秒表示
被取消的陳述式會被視為 batch 失敗,而連續 SPEND_LOG_CLEANUP_MAX_CONSECUTIVE_BATCH_FAILURES 次失敗(預設 3 次)會中止執行。若將 timeout 設得低於 batch 實際所需時間,每個 batch 都會被取消,因此執行會在未刪除任何內容的情況下中止,並記錄 Aborting LiteLLM_SpendLogs cleanup after 3 consecutive batch failures; total deleted before abort: 0。如果您提高 maximum_spend_logs_cleanup_batch_size,請確認 timeout 仍為較大的陳述式保留足夠完成時間。
運作方式
步驟 1. 取得鎖定(使用 Redis 為選用)
如果啟用 Redis,LiteLLM 會使用它來確保一次只有一個 instance 執行清理。
- 如果取得鎖定:
- 此 instance 會繼續清理
- 其他 instance 會略過
- 如果沒有鎖定:
- 清理仍會執行(適用於單一節點設定)
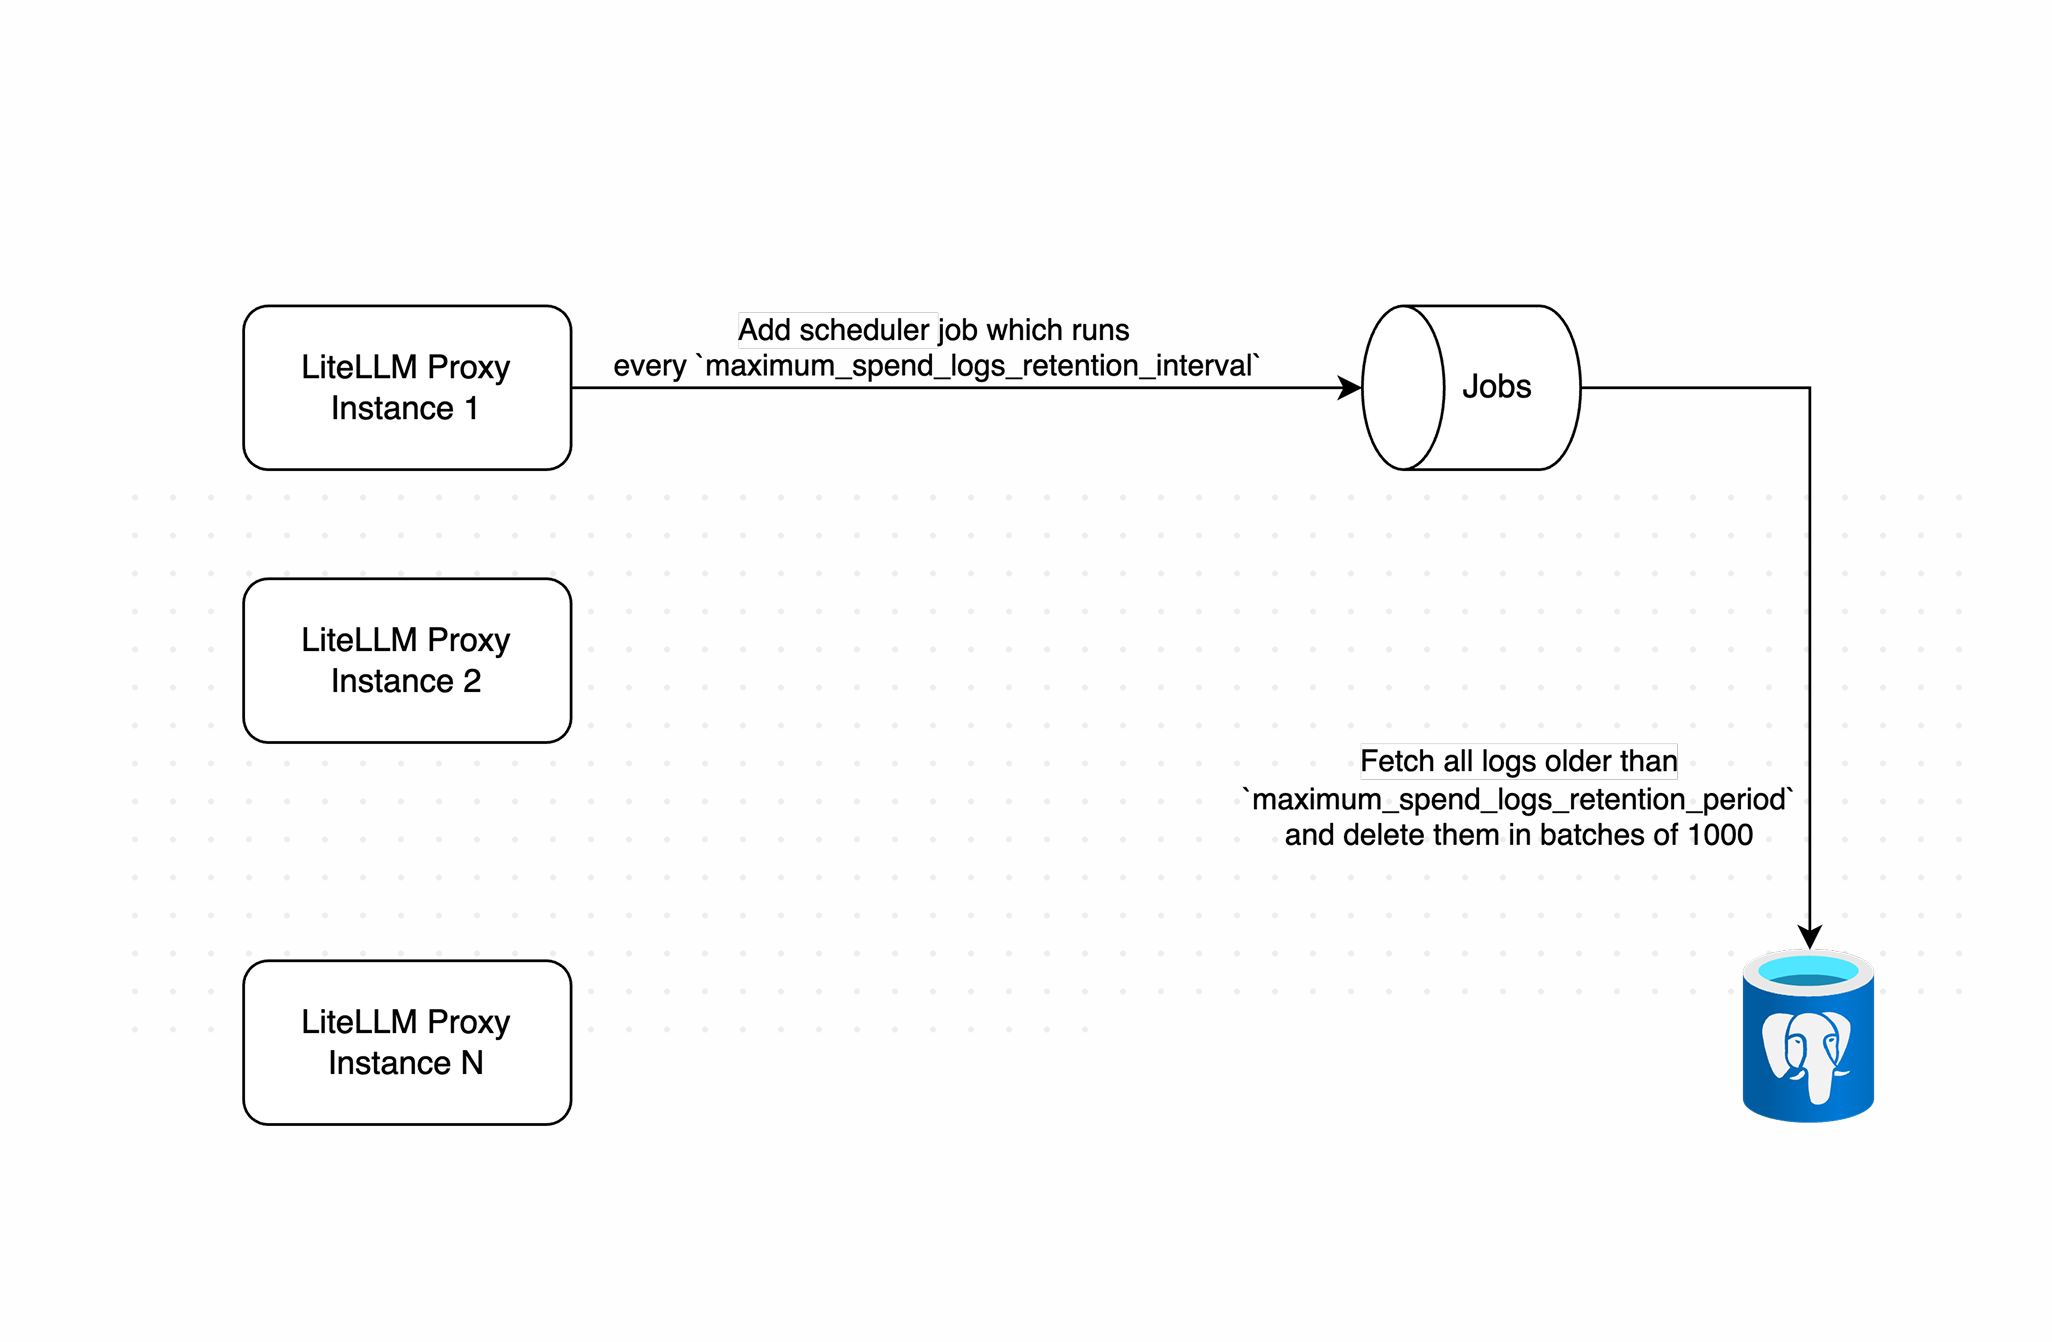
Spend log 刪除的運作方式
步驟 2. 批次刪除
一旦清理開始:
- 會使用已設定的保留期限計算截止日期
- 以批次刪除早於截止日期的記錄(預設大小
1000) - 在批次之間加入短暫延遲,以避免資料庫過載
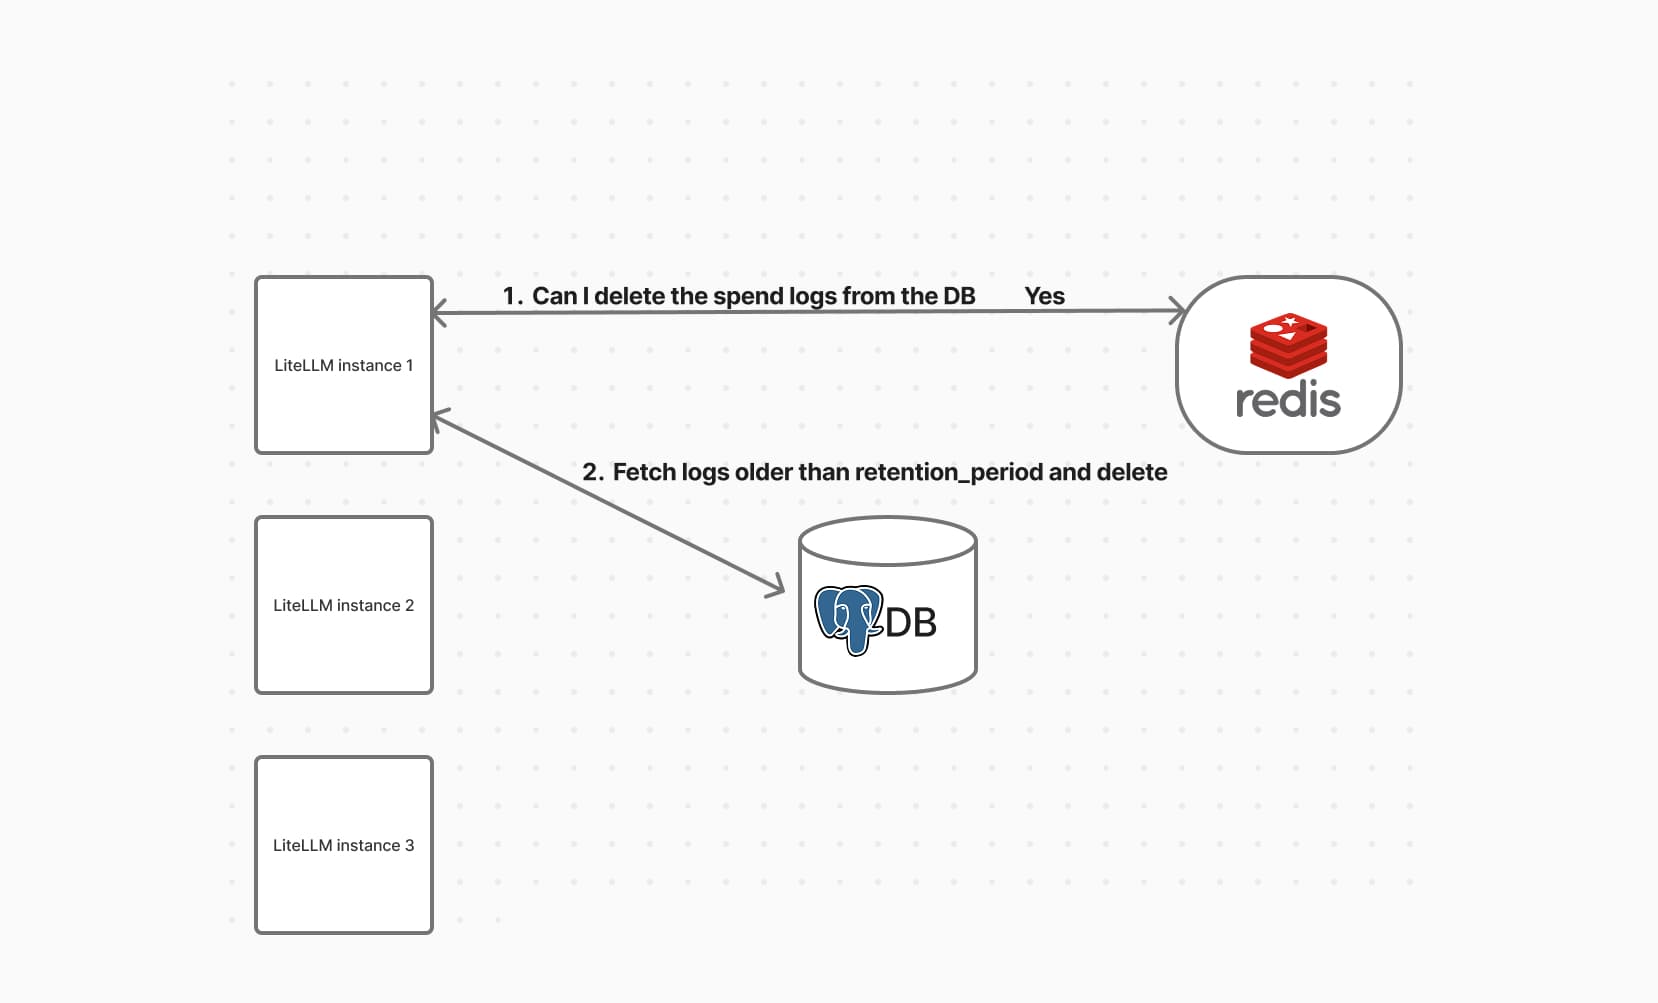
舊記錄的批次刪除
第 3 步。界限
若不加限制,對大型資料表進行一次執行會變成一長串高成本的寫入交易,可能讓其正在清理的資料庫不堪負荷。每次執行都同時受三種界限約束,並在先碰到哪個界限時就停止:每 DELETE maximum_spend_logs_cleanup_batch_size 列(預設 1000)、每個資料表 maximum_spend_logs_cleanup_max_batches 陳述式(預設 500),以及整次執行的 maximum_spend_logs_cleanup_run_budget 牆鐘時間(預設 5m)。在預設值下,每個資料表最多可處理 500,000 列,且最多進行五分鐘的工作。
預算會在陳述式之間檢查,因此它決定作業何時停止發出新工作。已在執行中的陳述式受 maximum_spend_logs_cleanup_batch_timeout 約束,這會套用為作業所發出每一個陳述式的 Postgres statement_timeout 與 lock_timeout,包括 outstanding-rows probe 在內。誠實地說,陳述式之間的檢查意味著一次執行最多可能超出預算一個 batch timeout,因此在設定預算時,請知道真正上限是預算再加上一個 timeout。提早停止是預期中的行為。下一個 tick 時,執行會從相同的截止點繼續,因此積壓會在幾次執行中逐步清空。
每個界限都有一個環境變數可設定其預設值,列於下方,並附帶兩個失敗處理旋鈕。若針對相同界限存在 general_settings 鍵,則該鍵會覆寫環境預設值:
| 環境變數 | 預設值 | 說明 |
|---|---|---|
SPEND_LOG_CLEANUP_BATCH_SIZE | 1000 | 每個 DELETE 陳述式刪除的列數 |
SPEND_LOG_RUN_LOOPS | 500 | 每個資料表每次執行的 DELETE 陳述式最大數量 |
SPEND_LOG_CLEANUP_RUN_BUDGET_SECONDS | 300 | 整次執行共用的牆鐘時間預算(秒) |
SPEND_LOG_CLEANUP_BATCH_TIMEOUT_SECONDS | 30 | 每一個作業所發出陳述式的 Postgres statement_timeout 與 lock_timeout(秒) |
SPEND_LOG_CLEANUP_REMAINING_COUNT_CAP | 100000 | outstanding-rows probe 的上限,因此回報積壓本身不會變成昂貴的掃描 |
SPEND_LOG_CLEANUP_MAX_CONSECUTIVE_BATCH_FAILURES | 3 | 在執行中止前可容忍的連續 batch 失敗次數 |
SPEND_LOG_CLEANUP_BATCH_FAILURE_BACKOFF_SECONDS | 0.5 | 在重試前,失敗 batch 之後的暫停時間 |
指標
作業會透過 Prometheus 回報其執行情況,因此您可以分辨健康的穩定狀態與持續增長的積壓。除最後一個之外,每個指標都以 table 為標籤;最後一個則以 outcome 為標籤:
| 指標 | 它告訴您什麼 |
|---|---|
litellm_spend_log_cleanup_rows_deleted_total | 每個資料表移除的列數 |
litellm_spend_log_cleanup_batch_duration_seconds | 單一批次所需時間;在調整批次大小時,您會關注這個數值 |
litellm_spend_log_cleanup_rows_remaining | 執行後仍在等待中的過期列 |
litellm_spend_log_cleanup_batch_failures_total | 失敗的批次,包括因批次逾時而被取消的陳述式 |
litellm_spend_log_cleanup_runs_total | 依 outcome 分組的執行:completed、budget_exhausted、batch_cap_reached、skipped_locked、skipped_disabled,或 aborted |
rows_remaining 是應該設定警示的項目。持平或接近零表示保留機制跟得上,線條上升則表示沒有跟上。請將它與 runs_total 一起閱讀:健康的部署會維持在 completed,而持續出現 budget_exhausted 或 batch_cap_reached 則表示每個 tick 執行都被提早中止,且需要提高這些參數
rows_remaining 背後的探測受到 SPEND_LOG_CLEANUP_REMAINING_COUNT_CAP(預設 100000)的限制。它會在達到上限時停止計數,因此回報待處理量時本身不會變成大型資料表的完整掃描,這表示比上限還多的過期列會準確回報為上限。當數值停在 100000 時,請將其視為下限
大型資料表
索引
LiteLLM_SpendLogs 隨附針對 startTime 與 (startTime, request_id) 的索引,而這正是刪除批次所需要的,所以在預設 schema 上不需要為保留機制新增任何內容。在一個預先填入 2,000,000 列的資料表上,單一批次的計畫是對 LiteLLM_SpendLogs_startTime_idx 進行索引掃描並餵入 nested loop,對 1000 列批次約需 1.8 毫秒
因此,批次本身成本很低,執行緩慢通常不是不良計畫的跡象。大型待處理量真正造成的成本是 WAL 容量,以及刪除留下的 dead tuples 所造成的 autovacuum 負載。在同一張資料表上,一次移除了約 500,000 列、耗時 111 秒的執行,會在 spend log 與 tool 索引資料表上留下約 1,000,000 個 dead tuples,這足以讓 autovacuum 在執行結束後很長一段時間內仍忙於處理它們。應針對這點調整,而不是針對刪除計畫
調整參數大小
批次大小是在鎖定時間與 WAL 記錄大小之間,和吞吐量相互取捨。更大的批次能在每個陳述式中刪除更多列,且在批次之間的固定暫停中花費相對更少時間,但代價是持有列鎖更久,並給 maximum_spend_logs_cleanup_batch_timeout 的緩衝更少。最大批次數限制單次執行最多能從一個資料表刪除多少,而執行預算則限制整個執行不論其他兩者如何設定,最多能持有資料庫注意力多久
批次之間的暫停為固定 0.1 秒,在預設批次大小下主導每批成本,這使吞吐量接近每秒 10,000 列,並讓 500 批次上限(而不是五分鐘預算)成為預設值下的約束限制
假設某個部署每天匯入 5,000,000 筆 spend log 列,保留期為 30 天。在穩態下,每日執行都必須刪除約一天的列,因此預設的 500,000 上限會讓保留機制永久落後,資料表也會無限制成長。將 maximum_spend_logs_cleanup_batch_size 提高到 5000,並將 maximum_spend_logs_cleanup_max_batches 提高到 2000,會把上限提高到 10,000,000 列,並使 5,000,000 列的執行時間約為 110 秒,明確落在預設 5m 預算內,而且每個陳述式仍會在 30 秒批次逾時內遠遠完成。幾天後檢查 litellm_spend_log_cleanup_rows_remaining:如果趨於持平,表示您有跟上;如果持續上升,請改用 maximum_spend_logs_retention_interval 更頻繁地執行清理,而不是進一步加大批次
清空大型待處理量
第一次在已經持有數月歷史資料的資料表上啟用保留機制,是值得事先規劃的情況。一次執行會在其預算耗盡時停止,並在下一個 tick 從相同的截點繼續,因此待處理量確實會自行消化,只是需要很多次執行。若維持預設值並採每日間隔,1 億列的待處理量需要數月
若要更快清空,請在維護視窗期間提高 maximum_spend_logs_cleanup_run_budget 與 maximum_spend_logs_cleanup_max_batches,執行時監看 spend log 資料表上的複寫延遲與 autovacuum,然後再把兩者恢復為預設值。在您可控制的視窗中清空,比在尖峰時段中途才發現同樣的工作容易推理得多
如果資料表之所以很大,是因為流量確實很高,而不是因為保留機制關閉,那麼將其轉換為分割區資料表會是更好的解法。此時保留機制會直接捨棄整個分割區,而不是刪除列,這會立即釋放磁碟空間,且不會留下需要 vacuum 的 dead tuples;而且對於分割區捨棄所回收的資料,批次或預算參數都不再重要。請見下方
高流量部署的分區
在高請求量(每天數百萬列)的情況下,透過 DELETE 進行保留會變成問題。刪除列不會將磁碟空間還給作業系統;它會留下 dead tuples(「tombstones」),之後必須由 autovacuum 回收。當寫入速度超過 autovacuum 時,即使邏輯列數有上限,資料表在磁碟上的大小仍會持續成長,而 LiteLLM_SpendLogs 一個月內就可能達到數百 GB。
修正方式是對 startTime 採用原生 Postgres 範圍分割區。對於已分割區的資料表,保留機制會以 DROP TABLE 捨棄整個分割區,這是一個立即釋放磁碟空間的中繼資料操作,不會留下 tombstone,也不需要 vacuum。當設定了 general_settings.use_spend_logs_partitioning: true 且資料表確實已分割區時,同一個清理工作會從批次刪除切換為捨棄過期分割區,並在每次執行時預先建立即將到來的分割區,讓寫入永遠有可落點的分割區;這兩個條件都必須成立,僅偵測到並不會切換行為。
這是選擇性啟用。預設 schema 不會分區,因此現有部署不會受到影響,直到您將資料表轉換為止。
分割區維護與執行預算之間有一項值得知道的互動。此工作只會在執行仍有預算時開始分割區維護,而已經超時的執行會跳過,直到下一個 tick。當捨棄動作開始後,預算無法將其提早中止,因為捨棄分割區屬於 DDL,會持有 ACCESS EXCLUSIVE 鎖並且必須執行到完成。此工作其餘動作都可以在陳述式之間被中斷,因此這是預算無法在進行中界定的唯一工作
轉換資料表
無法直接對已填充的資料表進行分區,因此轉換會先將現有資料表改名移開,然後建立新的分區資料表。分區鍵必須是主鍵的一部分,因此主鍵會變成複合 ("request_id", "startTime");LiteLLM 的 spend-log 寫入路徑使用 INSERT ... ON CONFLICT DO NOTHING,這與此相容。
在您的資料庫上執行 db_scripts/partition_spend_logs.sql 中的 runbook(請先在 staging 副本上測試並先備份)。它會建立分區 parent、複合主鍵、startTime 索引,以及一個 DEFAULT 分區,作為任何超出範圍列的安全網。
轉換完成後,請如上所示設定保留期限,清理工作就會替您管理分區。
調校
| 環境變數 | 預設值 | 說明 |
|---|---|---|
SPEND_LOG_PARTITION_INTERVAL | day | 分區粒度:day、week 或 month。高流量資料表請使用 day,以便精確保留且單一分區維持可管理。 |
SPEND_LOG_PARTITION_PRECREATE_AHEAD | 7 | 每次清理執行要預先建立多少個未來分區。 |
只有在整個時間範圍都早於保留截止點時,分區才會被刪除,因此實際保留時間會向上取整到分區粒度。

